Qwen-Image 2.1이란
Qwen-Image 2.1은 체크포인트 하나로 두 가지 일을 합니다. 텍스트에서 이미지를 생성하고, 문장 하나와 최대 열 장의 참조 이미지로 기존 그림을 편집합니다. 생성 부분은 70억 파라미터의 디퓨전 트랜스포머입니다. Qwen3-VL 8B 텍스트 인코더와 짝을 이루며, ComfyUI에서는 별도 파일로 불러옵니다.
인코더가 언어 모델이기 때문에 키워드 목록이 아니라 문장 전체, 레이아웃 지시, 따옴표 안의 단어를 읽어 낼 수 있습니다.
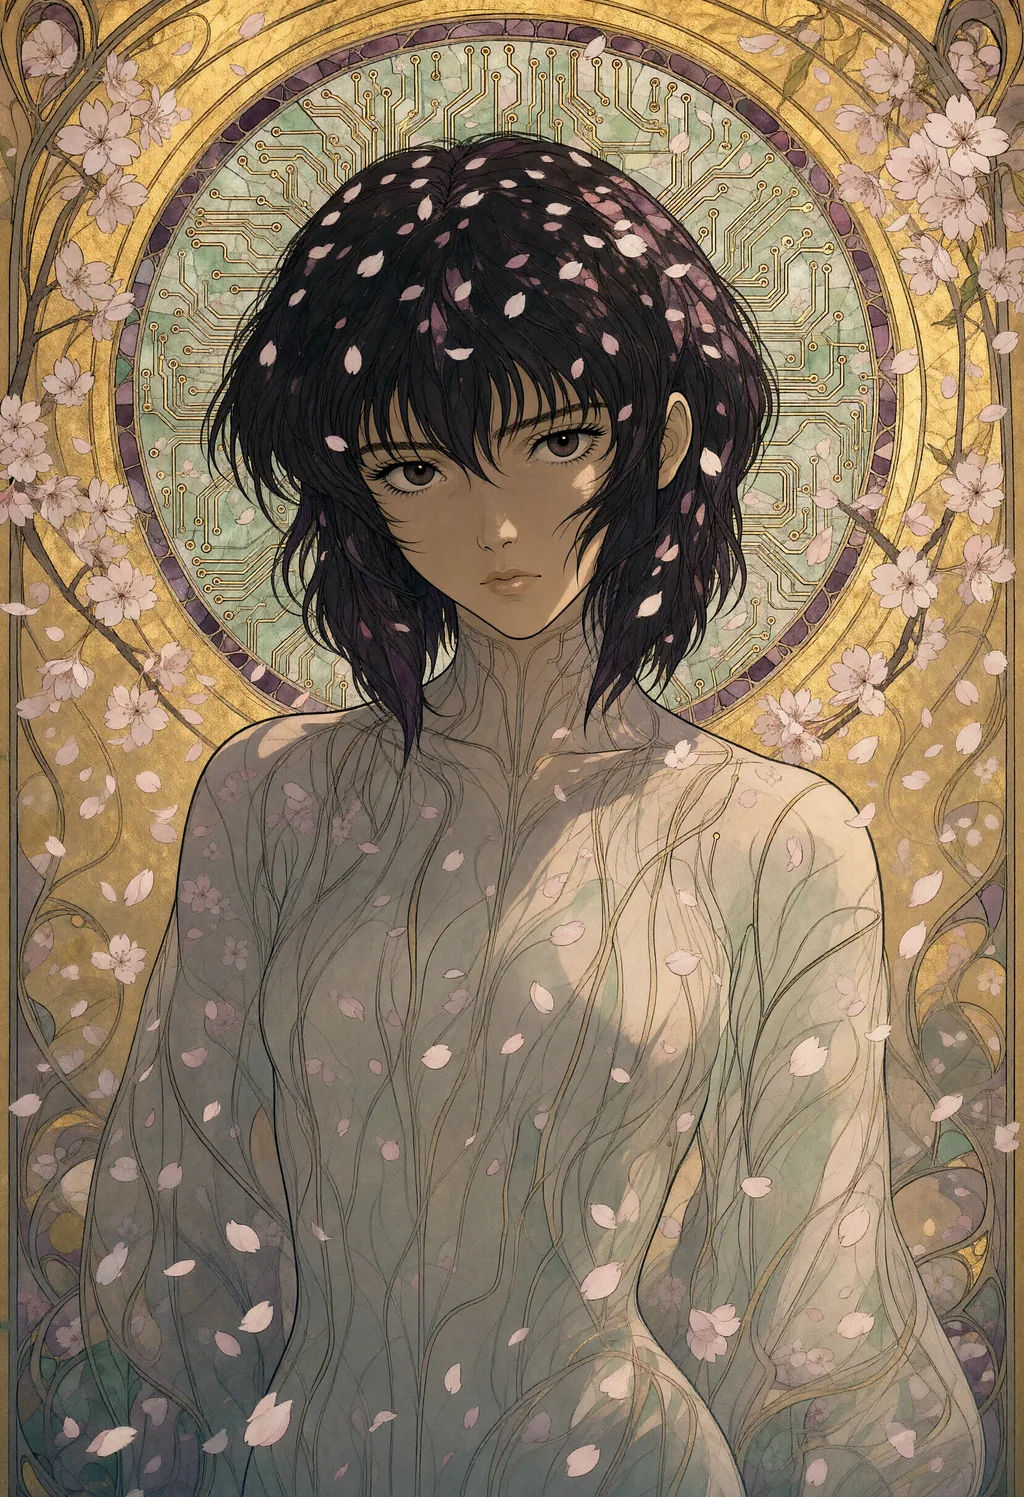
Qwen은 2.1이 질감, 타이포그래피, 인물 조명에서 개선되었다고 소개합니다. 업스케일러 없이 네이티브 2K로 동작합니다. 정사각형은 2048 × 2048, 3:2는 2528 × 1696, 16:9는 2752 × 1536입니다. 프롬프트에서 투명 배경을 요구하면 실제 알파 채널도 출력할 수 있습니다.
대가는 시간입니다. VRAM 16GB의 소비자용 그래픽카드에서 int8 가중치는 1메가픽셀 이미지에 약 40초가 걸립니다. 4메가픽셀 이미지는 아래 설정으로 약 4분 30초가 걸립니다.
내려받기 전에 알아 둘 점이 하나 있습니다. 가중치는 Qwen Research License를 따릅니다. 연구와 평가 용도로만 쓸 수 있습니다. 상업적 이용에는 Qwen에서 별도 라이선스를 받아야 합니다. 2025년 8월에 공개된 첫 Qwen-Image는 Apache 2.0이었습니다. 2.1은 아닙니다.
Qwen-Image 2.1 프롬프트 작성법
태그가 아니라 문장을 쓰세요. 텍스트 인코더는 언어 모델입니다. 어순, 전치사, 따옴표를 읽고 모든 것을 글자 그대로 받아들입니다. "lighthouse cat"은 등대 위에 그려진 고양이가 됩니다.
아래 구조가 약 천 장의 이미지를 거치며 가장 좋은 결과를 냈습니다. 이 순서를 지키세요.
- 매체와 피사체를 먼저: "An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms". 맨 앞에 정한 매체가 그 뒤의 모든 것에 색을 입힙니다.
- 배경: 장소, 시대, 날씨, 또는 공중을 채우는 것. "in falling cherry blossoms", "in the 1980s", "during a blizzard".
- 빛과 그 방향: "lit from the front by soft diffuse light, with gentle shadows". 방향은 지켜집니다. 달랑 "dramatic light"만 쓰면 지켜지지 않습니다.
- 프레이밍: "close-up of the subject, looking at the viewer", 미디엄 숏, 위에서 내려다본 구도, 광활한 풍경 속의 조그만 피사체.
- 재질과 색감: "flowing ink lines, flat gold leaf background, muted jade and plum". 모델이 2K에서 가장 잘 렌더링하는 부분입니다.
- 제한 조건은 프롬프트 안에: "no lettering, no watermark", "five fingers on each hand". 가이던스 1에서는 네거티브 프롬프트가 무시되므로 프롬프트 자체가 이 역할을 맡아야 합니다.
위 일러스트의 전체 프롬프트를 그 순서 그대로 옮기면 이렇습니다: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
글자는 따옴표로 감싸고 위치를 정해 주면 잘 나옵니다. "A banner above the door reads 'OPEN ALL NIGHT'"는 대문자든 아니든 거의 매번 제대로 나옵니다.
반대도 마찬가지입니다. 글자를 요구하지 않은 가게 전면, 식당, 오락실에는 지어낸 간판이 돋아납니다. 그러니 장면에 건물 정면이 있을 때마다 "no lettering"을 쓰세요.
모델이 모르는 캐릭터는 아무 경고 없이 닮은꼴로 바뀝니다. Marsupilami는 원숭이가 되었습니다. 모스라와 Marvin the Martian은 제대로 나왔습니다.
프롬프트 예시 페이지의 Qwen 카드는 모두 이 구조를 따르며 시드, 크기, 설정이 함께 적혀 있습니다.
효과가 있는 설정, 측정 결과
ComfyUI 공식 템플릿은 가이던스(CFG) 1에 25스텝으로 돌아갑니다. 모델 카드는 40스텝을 씁니다. 아래 설정은 CFG 3로 정해졌습니다.
2026년 10월 16일에 같은 시드로 마지막으로 테스트했을 때, 가장 디테일이 풍부하고 가장 충실한 이미지를 낸 설정은 다음과 같습니다.
| 설정 | 값 |
|---|---|
| 가이던스(CFG) | 3, 네거티브 프롬프트와 함께 |
| 네거티브 프롬프트 | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| 모델 패치 | APG(eta 1, norm threshold 10, momentum 0.3) 다음에 FreSca(low 1, high 2, cutoff 8), 샘플러 앞에 |
| 샘플러 | euler, simple 스케줄러 |
| 스텝 | 1메가픽셀에서 25, 2.5와 4메가픽셀에서 20 |
| LoRA | 없음 |
가이던스는 장면을 바꾸지 않는 유일한 설정입니다. 같은 시드와 크기에서 CFG 1과 CFG 3는 구도가 거의 같습니다. 달라지는 것은 렌더링입니다.
CFG 1에서는 이미지가 더 밋밋해지고 미세한 질감이 사라집니다. 자수의 땀은 그냥 천이 됩니다. 만화풍 얼굴은 눈동자와 입을 잃습니다. 금속은 리벳을 잃습니다.
CFG 1을 30스텝으로 늘리면 선명함은 돌아오지만 재질감과 대비는 돌아오지 않습니다. 한 번 시험해 본 2메가픽셀에서는 40스텝이 깨끗한 이미지를 내지만 여전히 밋밋하고, 프롬프트도 덜 안정적으로 읽습니다.
APG는 CFG 3가 과포화되지 않게 막아 줍니다. FreSca는 고주파 디테일을 선명하게 합니다. 둘 다 가이던스가 1보다 클 때만 작동합니다.
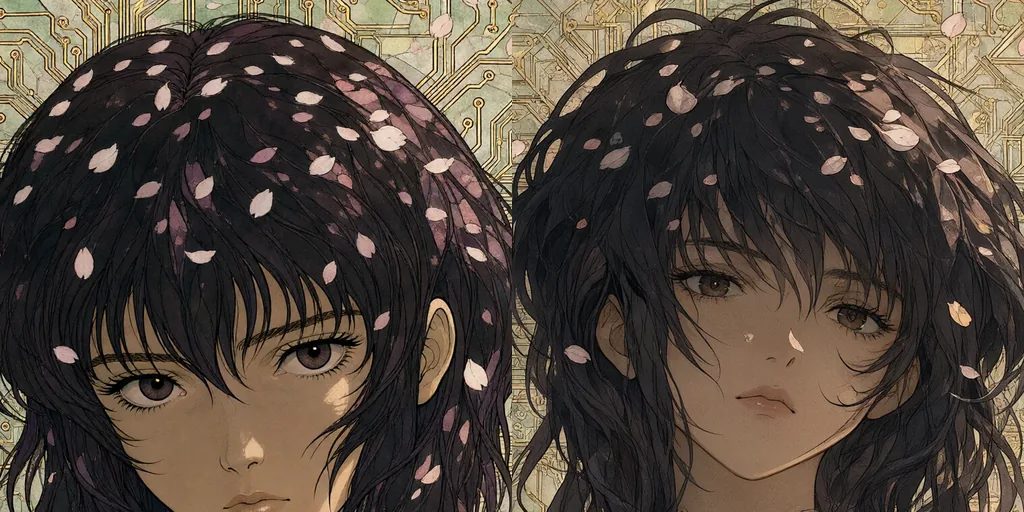
가이던스가 1보다 높으면 스텝마다 한 번 더 계산하므로 CFG 1은 두 배 빠릅니다. 테스트에 쓴 그래픽카드에서 4메가픽셀 이미지는 120~135초 대 255~275초입니다. 테스트한 열 쌍 모두에서 느린 쪽이 그만한 가치가 있었습니다.
해상도와 스텝: 무엇이 이미지를 바꾸나
다른 디퓨전 모델과 마찬가지로 Qwen-Image 2.1은 크기가 바뀌어도 이미지를 확대하거나 축소하지 않습니다. 같은 시드의 다른 테이크가 나오므로, 1메가픽셀에서 찾은 시드는 2K로 이어지지 않습니다.
1메가픽셀에서 2.5나 4로 올리면 테스트한 모든 쌍에서 다른 그림이 나왔습니다. 2.5와 4메가픽셀 사이에서는 열 쌍 중 여덟 쌍에서 구도가 유지되었습니다.
아래 일러스트에서는 디테일만 움직였습니다. 2.5메가픽셀에서는 회로 패턴이 후광을 떠나 머리카락으로 옮겨 갔습니다.
스텝 수도 차이가 커지면 이미지를 바꿉니다. 20스텝과 25스텝은 거의 같은 그림입니다. 16스텝은 달라집니다. 그러니 1메가픽셀로 미리 보고 같은 이미지를 더 크게 렌더링하는 방법은 없습니다. 크기를 먼저 정하고, 그다음에 시드를 고르세요.
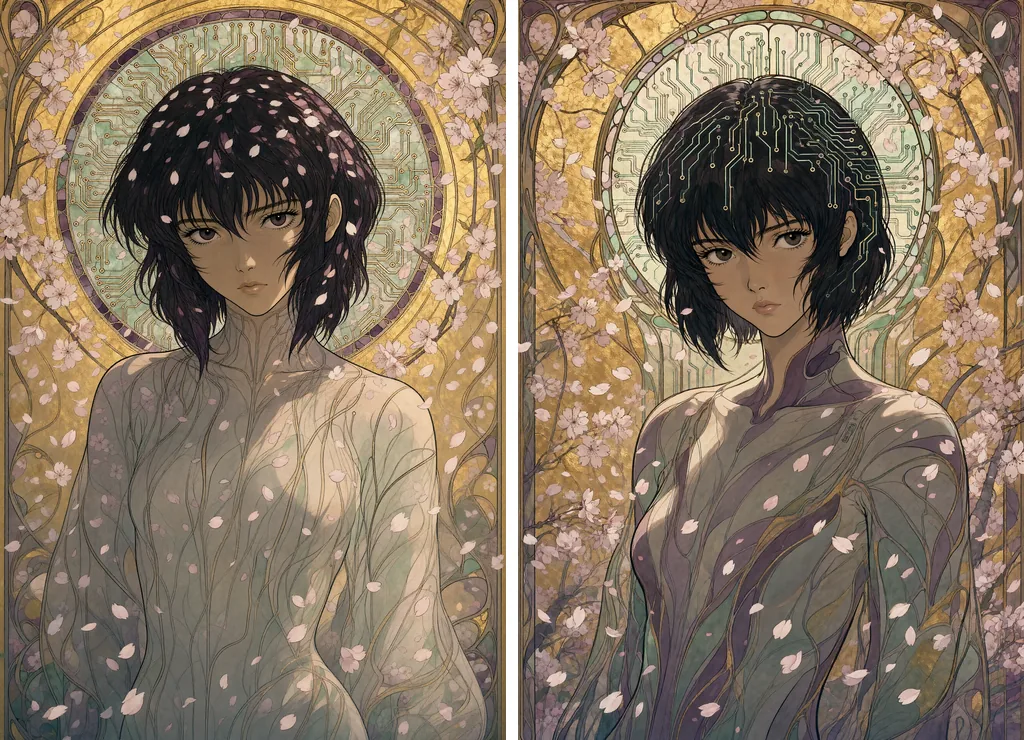
CFG 3, APG와 FreSca, int8 가중치로 16GB 소비자용 그래픽카드 한 장에서, 가로 또는 그에 해당하는 세로 크기로 측정한 시간:
| 크기 | 스텝 | 이미지 한 장당 시간 |
|---|---|---|
| 1메가픽셀(1216 × 832) | 25 | 약 40초 |
| 2.5메가픽셀(1920 × 1312) | 20 | 120~135초 |
| 4메가픽셀(2432 × 1664) | 20 | 255~275초 |
| 4메가픽셀 | 25 | 315~335초 |
2.5메가픽셀은 같은 영역을 100%로 비교하면 4보다 디테일이 조금 부드럽습니다. 하지만 프롬프트의 스타일은 적어도 그만큼 잘 따르고, 열 쌍의 테스트에서는 때로 더 잘 따랐습니다. 자수는 4메가픽셀보다 2.5메가픽셀에서 땀이 더 또렷하게 보였습니다.
1024픽셀로 보여 주는 갤러리라면 2.5메가픽셀에 20스텝이 최적점입니다. 인쇄용이라면 4메가픽셀에 20스텝입니다.
속도 높이기: Turbo, 가이드된 Turbo, 그 밖의 방법
Turbo. Qwen은 2026년 10월 9일 Qwen-Image-2.1-Turbo를 공개했습니다. 고정된 시그마 스케줄로 CFG 1에서 8스텝으로 돌아가는 증류 체크포인트입니다. Comfy-Org가 int8 파일과 베이스 모델용 LoRA로 배포하고, ComfyUI에 자체 템플릿이 있습니다. 10월 17일에 이 가이드의 CFG 3 렌더링과 같은 열 개의 시드와 크기로, 템플릿의 그래프를 그대로 써서 측정했습니다.
| 설정 | 이미지 한 장당 시간 |
|---|---|
| Turbo 체크포인트, 8스텝, CFG 1, 1메가픽셀 | 9~10초 |
| Turbo 체크포인트, 8스텝, CFG 1, 4메가픽셀 | 38~39초 |
| 아래에서 설명하는 가이드된 Turbo: Turbo 체크포인트, 8스텝, APG와 FreSca를 더한 CFG 3, 4메가픽셀 | 66~71초 |
| 베이스 체크포인트에 Turbo LoRA, 8스텝, CFG 1, 4메가픽셀 | 52~55초 |
| 베이스 체크포인트, CFG 3, 20스텝, 4메가픽셀 | 255~275초 |
4메가픽셀에서 일곱 배, 1메가픽셀에서 네 배 빠릅니다. 이미지도 깨끗합니다. 선명하고 조명이 좋으며, 열 개의 시드에서 해부학적 오류가 없고, 베이스 모델과 같은 프롬프트에서 글자도 제대로 나옵니다. 프롬프트의 사물은 빠짐없이 있고, 때로는 베이스 모델보다 낫습니다. 경주용 차를 탄 거북이는 베이스 모델이 렌더링마다 빠뜨렸는데 Turbo에서는 나타났습니다.
잃는 것은 매체입니다. 열 개의 시드 가운데 사진이 아닌 프롬프트마다 증류 모델은 사진 같은 사실주의로 흘러갔습니다. 악어 자수는 악어 사진이 되었습니다. 목탄화는 입자감을 잃었습니다. 종이 공예 Marvin the Martian은 비닐 피규어가 되었습니다. 건물 정면에 지어내는 글자는 베이스 모델과 같습니다.
열 개의 시드에서 베이스 체크포인트에 얹은 LoRA는 Turbo 체크포인트와 같은 이미지를 더 느리게 냈을 뿐입니다. 그러니 내려받을 것은 체크포인트입니다. 시드는 크기를 바꿀 때처럼 베이스 모델과 다른 그림을 냅니다. 라이선스는 같아서 연구와 평가 용도뿐입니다.
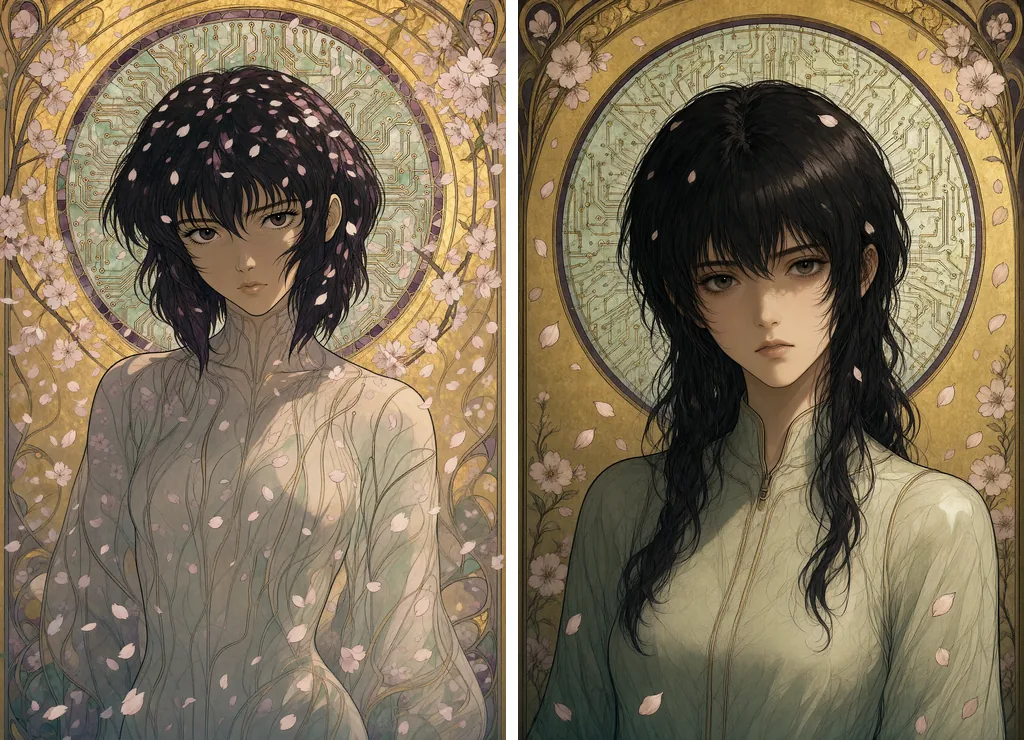
가이드된 Turbo. Turbo는 CFG 1에 묶여 있지 않습니다. 2026년 10월 17일에 같은 열 개의 시드와 이 가이드의 일러스트로 테스트했습니다. Turbo의 체크포인트와 고정된 시그마 8개는 그대로 두고, 베이스 프리셋에서 가이던스 부분만 가져옵니다. CFG 3, 네거티브 프롬프트, APG 다음에 FreSca입니다.
그래프는 Turbo 템플릿 그대로입니다. CFGGuider를 1 대신 3으로 설정하고, 네거티브 프롬프트를 채우고, 로더와 가이더 사이의 모델 경로에 APG 다음 FreSca를 끼워 넣습니다. ManualSigmas 노드와 샘플러는 그대로 둡니다.
결과는 Turbo의 구도를 지키면서 CFG 1이 밋밋하게 만들었던 것을 되찾습니다. 대비, 채도, 미세한 디테일입니다. 이 가이드의 일러스트에서는 후광의 회로 패턴이 또렷하고 금빛으로 돌아오고, 꽃잎도 돌아옵니다. 열 개의 테스트 시드에서도 비늘, 털, 자수 조끼가 같은 식으로 선명해집니다. 되찾지 못하는 것은 매체입니다. 자수는 여전히 악어 사진입니다.
대가는 스텝마다 한 번 더 계산하는 것입니다. 4메가픽셀 이미지에 38~39초 대신 66~71초입니다. 그래도 베이스 모델보다 네 배 가까이 빠릅니다.
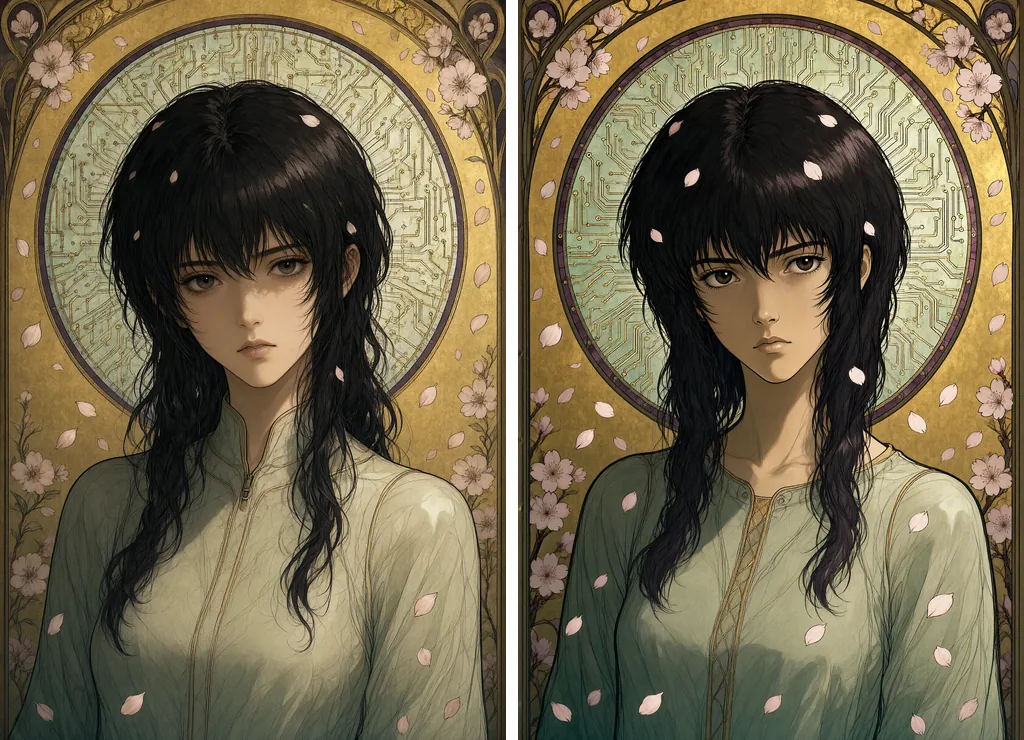
워크플로를 내려받으세요. 가이드된 Turbo의 ComfyUI 워크플로(JSON)는 이 일러스트를 그대로 렌더링합니다: 1664 × 2432, 시드 57658043, APG와 FreSca를 더한 CFG 3, 이 가이드의 네거티브 프롬프트. 파일을 ComfyUI에 끌어다 놓으세요. 마지막 섹션에서 언급한 모델 파일 세 개가 필요합니다. 이 페이지 링크를 달면 CC BY 4.0에 따라 자유롭게 재사용할 수 있습니다.
스텝을 늘려서 Turbo를 도우려 하지 마세요. 베이스 모델인 것처럼 4메가픽셀, CFG 3에서 20스텝과 simple 스케줄러를 주면 과하게 익습니다. 딱딱한 머리카락 가닥, 거친 후광, 밀어붙인 대비가 나옵니다. 게다가 169초가 걸립니다. 증류 체크포인트에는 자체 시그마 8개가 맞습니다.
합리적인 역할 분담은 이렇습니다. 기본 Turbo는 초안 모드로, 고를 후보를 시간당 일곱 배 뽑습니다. 가이드된 Turbo는 사진 같거나 선이 깔끔한 프롬프트에서 디테일이 빨리 필요할 때 씁니다. CFG 3의 베이스 모델은 그림, 드로잉, 공예처럼 매체 자체가 핵심인 모든 것에 씁니다.
다른 증류 모델. LightX2V는 2026년 10월 13일에 2.1용 4스텝 Lightning LoRA를 공개했습니다. 커뮤니티의 8스텝 LoRA인 Turbo8도 있습니다. 둘 다 Turbo처럼 CFG 1에서 돌아갑니다. 여기서는 둘 다 측정하지 않았습니다.
프리픽스 캐시 노드. ComfyUI의 QwenImage21Cache 노드는 모델이 이미 유지하는 캐시의 장치와 정밀도를 정할 뿐입니다. 기본값에서는 아무것도 바꾸지 않습니다. int8 모드는 캐시를 절반으로 줄여서 2K나 참조 이미지 여러 장을 쓰는 편집에서 메모리가 부족할 때 도움이 됩니다. 이번 테스트에서 눈에 띄는 손실은 없었습니다.
스텝 줄이기. 16스텝은 시간을 약 5분의 1 아끼지만 구도를 바꾸고 20스텝보다 선명해지지도 않습니다. 시간이 문제라면 스텝보다 크기를 먼저 낮추세요.
Qwen-Image 2.1을 로컬에서 실행하기
ComfyUI는 이 모델을 네이티브로 지원합니다. 파일 세 개를 평소 폴더에 넣습니다. 디퓨전 모델은 diffusion_models, Qwen3-VL 텍스트 인코더는 text_encoders, VAE는 vae에 넣습니다.
16GB 그래픽카드라면 Comfy-Org가 공개한 int8 버전을 고르세요. bf16 가중치도 돌아가지만 시스템 메모리로 넘쳐서 두 배에서 여섯 배 더 오래 걸리고, 눈에 보이는 이득은 없습니다.
그래프는 짧습니다.
- UNETLoader, 타입이
qwen_image인 CLIPLoader, VAELoader; - 프롬프트와 네거티브 프롬프트를 함께 받아 두 컨디셔닝을 출력하는 TextEncodeQwenImage21;
- 원하는 크기의 빈 잠재 이미지;
- 모델 경로의 APG 다음 FreSca;
- euler와 simple 스케줄러로 CFG 3를 쓰는 KSampler, 그다음 VAEDecode.
투명 이미지를 만들려면 모델 카드가 권장하는 형식으로 피사체를 감쌉니다. "This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent." 그리고 PNG로 저장하세요.
메모리: 1메가픽셀에서 int8 모델, 인코더, VAE는 시스템 메모리를 건드리지 않고 16GB 안에서 돌아갑니다. ComfyUI는 프롬프트 인코딩이 끝나면 인코더를 VRAM에서 내보냅니다. 4메가픽셀에서는 프리픽스 캐시를 int8로 두었고 메모리가 모자란 적은 한 번도 없었습니다. 세션의 첫 이미지는 파일을 불러오는 동안 더 오래 걸립니다.