Qwen-Image 2.1 是什么
Qwen-Image 2.1 用一个检查点做两件事:从文字生成图像,以及用一句话加最多十张参考图来编辑现有图片。生成部分是一个 70 亿参数的扩散 Transformer,搭配 Qwen3-VL 8B 文本编码器,也就是 ComfyUI 为它加载的那个文件。正因为编码器是语言模型,它才能读懂完整的句子、版面指令和引号内的词,而不只是关键词列表;我们的测试也证实了这一点。当提示词要求透明背景时,它还能输出带真正 Alpha 通道的图像。
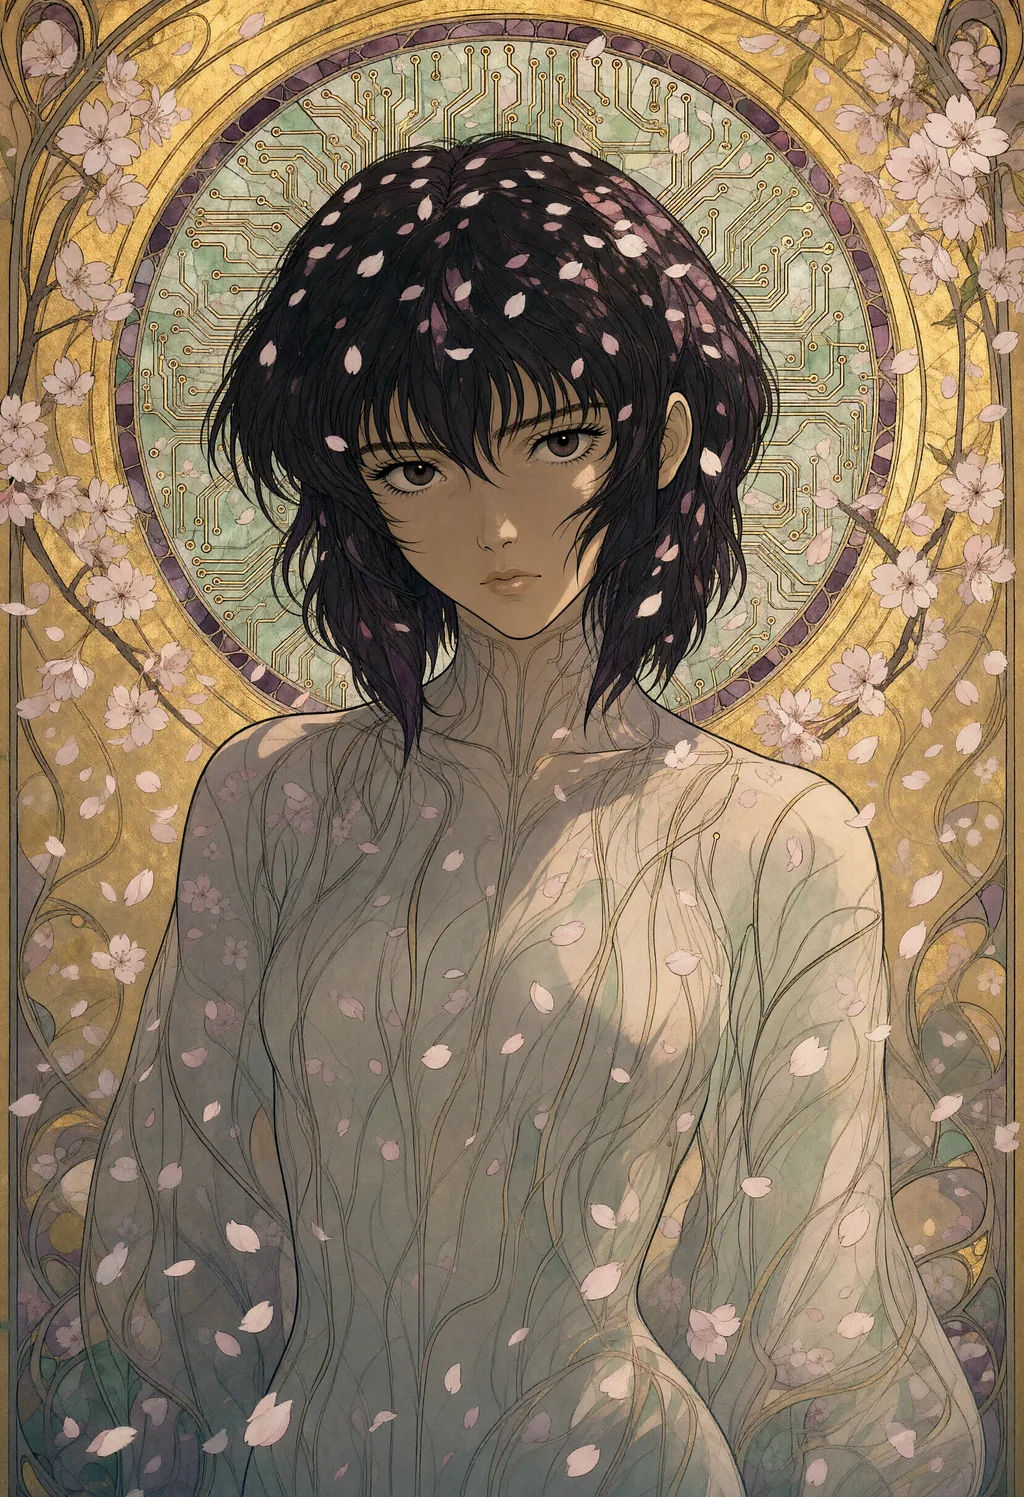
Qwen 称 2.1 在质感、文字排版和人像光照上有所改进,并且能以原生 2K 工作:正方形 2048 × 2048,3:2 为 2528 × 1696,16:9 为 2752 × 1536,无需放大模型。代价是时间。在一张 16 GB 显存的消费级显卡上,用 int8 权重和下文的参数,100 万像素的图约需 40 秒,400 万像素约需四分半钟。
先说最要紧的:权重采用 Qwen Research License,仅限研究和评估,任何商业用途都需要向 Qwen 另行申请许可。2025 年 8 月发布的第一代 Qwen-Image 是 Apache 2.0 许可证;2.1 不是。
如何为 Qwen-Image 2.1 写提示词
写句子,不要写标签。文本编码器是语言模型:它会读词序、介词和引号,并且把一切都照字面理解。“lighthouse cat”会变成一只画在灯塔上的猫。在大约一千张图的测试中,给我们最好结果的结构如下,按此顺序。
- 媒介和主体放最前:“An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”。开头定下的媒介会给后面的一切染上色彩。
- 场景:地点、年代、天气,或是弥漫在空中的东西。“in falling cherry blossoms”、“in the 1980s”、“during a blizzard”。
- 光线及其方向:“lit from the front by soft diffuse light, with gentle shadows”。方向会被遵守;只写一句“dramatic light”则不会。
- 取景:“close-up of the subject, looking at the viewer”、中景、俯视、辽阔风景中的渺小主体。
- 材质与色板:“flowing ink lines, flat gold leaf background, muted jade and plum”。这是模型在 2K 下渲染得最好的部分。
- 限制条件,直接写进提示词:“no lettering, no watermark”、“five fingers on each hand”。引导系数为 1 时负面提示词会被忽略,所以这些要由提示词本身来承担。
上面这幅插画的完整提示词,按原来的顺序:An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
文字只要加引号并指明位置就能成功:“a banner above the door reads 'OPEN ALL NIGHT'”几乎每次都正确,大写与否都一样。反过来也成立:没有要求文字的店面、餐馆或游戏厅会自己长出一块编造的招牌,所以只要场景里有外立面,就写上“no lettering”。模型不认识的角色会被悄悄换成一个相似的替身:Marsupilami 变成了猴子,而 摩斯拉 和 Marvin the Martian 都画对了。本站提示词示例页上的每张 Qwen 卡片都遵循这个结构,并附有种子、尺寸和参数。
有效的参数,实测
ComfyUI 官方模板以引导系数(CFG)1 跑 25 步,模型卡用 40 步。我们选择了更高的引导系数。最近一次测试在 2026 年 10 月 16 日,使用相同的种子,以下参数给出了最细致、也最忠实于提示词的图像:
| 参数 | 值 |
|---|---|
| 引导系数(CFG) | 3,配合负面提示词 |
| 负面提示词 | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| 模型补丁 | 先 APG(eta 1,norm threshold 10,momentum 0.3),再 FreSca(low 1,high 2,cutoff 8),置于采样器之前 |
| 采样器 | euler,simple 调度器 |
| 步数 | 100 万像素 25 步,400 万像素 20 步 |
| LoRA | 无 |
引导系数是唯一不改变场景的参数:相同种子和尺寸下,CFG 1 和 CFG 3 的构图几乎一样,不同的是渲染。CFG 1 的图像更平,丢失细微质感:刺绣的针脚变成一块布,卡通脸失去瞳孔和嘴巴,金属没了铆钉。把 CFG 1 加到 30 步能找回锐度,却找不回材质和对比度;200 万像素跑 40 步画面干净但仍然偏平,对提示词的理解也不那么可靠。APG 防止 CFG 3 过饱和,FreSca 锐化高频细节;两者都只在引导系数高于 1 时起作用。
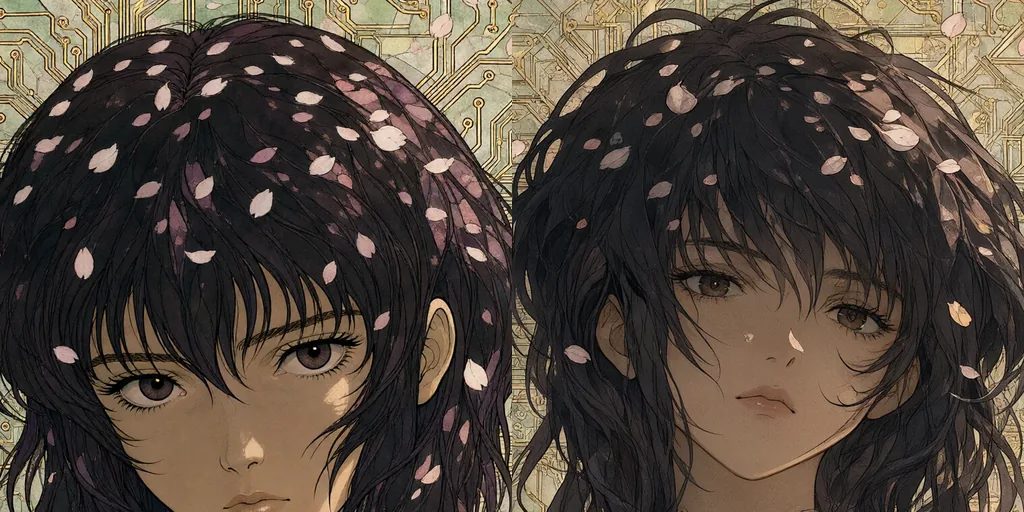
引导系数高于 1 的代价是每一步多算一遍:CFG 1 快一倍。在我们的显卡上,400 万像素的图是 120 到 135 秒对 255 到 275 秒,而在十组测试对里,我们每一组都认为慢的那张值得。
分辨率与步数:什么会改变画面
有两件事出乎我们意料。改变尺寸并不是把图放大缩小,而是得到同一种子的另一次生成。从 100 万像素到 2.5 或 400 万像素,每次都给了我们一张不同的图;2.5 与 400 万像素之间,十组里有八组构图保持不变,下面的插画就是如此,只有细节动了:250 万像素下,电路纹路离开了光环,跑到了头发上。步数变化一旦拉大,也会改变画面:20 步和 25 步几乎是同一张图,16 步就漂移了。所以没有办法先在 100 万像素下预览、再把同一张图放大渲染。先定尺寸,再挑种子。
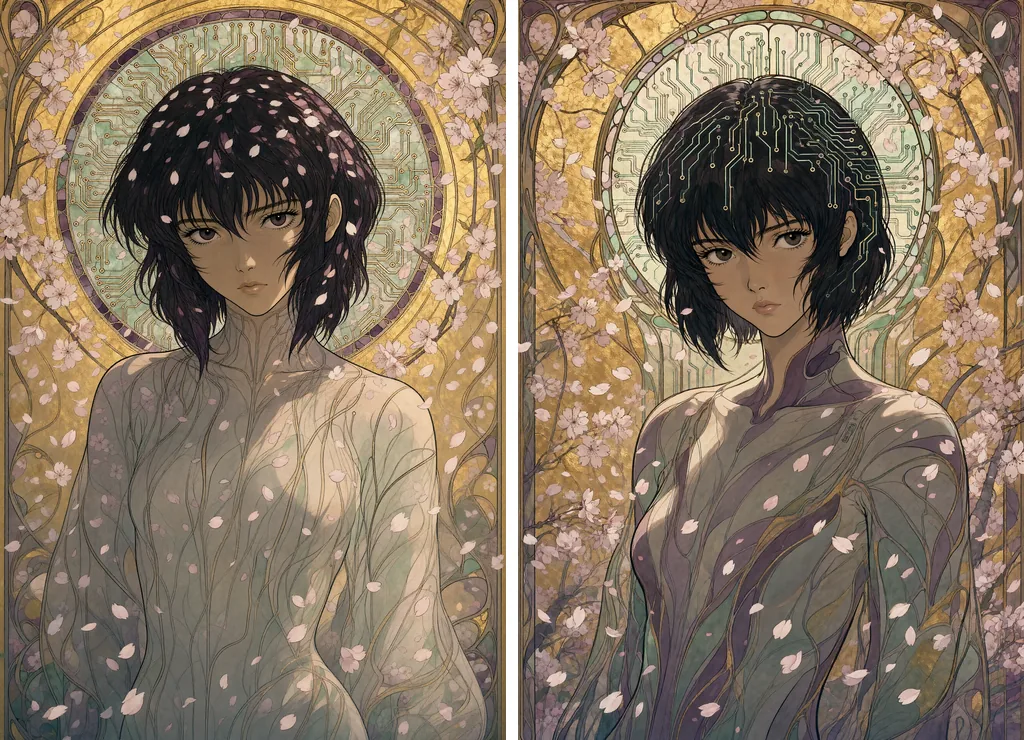
以 CFG 3、APG 和 FreSca、int8 权重,在一张 16 GB 消费级显卡上实测的时间:
| 尺寸 | 步数 | 每张用时 |
|---|---|---|
| 100 万像素(1216 × 832) | 25 | 约 40 秒 |
| 250 万像素(1920 × 1312) | 20 | 120 到 135 秒 |
| 400 万像素(2432 × 1664) | 20 | 255 到 275 秒 |
| 400 万像素 | 25 | 315 到 335 秒 |
在 250 万像素下,以 100% 比较同一区域时细节比 400 万像素稍软,但模型对提示词风格的遵循至少同样好,在我们的十组测试对里有时还更好:一幅刺绣在 250 万像素下保留了可见的针脚,到 400 万像素就变成了照片。对于以 1024 像素展示的图库,250 万像素、20 步是最佳平衡点。要打印的话,400 万像素、20 步。
提速:官方 Turbo 实测
第一代 Lightning LoRA。2025 年的 8 步 Qwen-Image-Lightning LoRA 是在第一代 Qwen-Image 上训练的,其注意力层宽度为 3072。Qwen-Image 2.1 用的是 4096。ComfyUI 会对每个注意力权重报一条错误、跳过它们,然后用裸模型跑 8 步:乍一看够锐,但 LoRA 根本没生效,而未经蒸馏的模型跑 8 步出来的图并不是你想要的。
官方 Turbo。Qwen 于 2026 年 10 月 9 日发布了 Qwen-Image-2.1-Turbo:一个蒸馏检查点,以 CFG 1 跑 8 步、采用固定 sigma 调度,由 Comfy-Org 以 int8 文件和基础模型用的 LoRA 两种形式提供,ComfyUI 中有它自己的模板。我们在 10 月 17 日用与 CFG 3 渲染相同的十个种子和尺寸、按模板的原始图结构做了实测。
| 设置 | 每张用时 |
|---|---|
| Turbo 检查点,8 步,100 万像素 | 9 到 10 秒 |
| Turbo 检查点,8 步,400 万像素 | 38 到 39 秒 |
| 基础检查点加 Turbo LoRA,8 步,400 万像素 | 52 到 55 秒 |
| 我们的参数,CFG 3,20 步,400 万像素 | 255 到 275 秒 |
400 万像素下快七倍,100 万像素下快四倍,而且图像干净:锐利、光照得当,十个种子里没有解剖错误,文字在基础模型能画对的地方同样画对。提示词里的物体都在,有时比基础模型还好:那只开赛车的乌龟,基础模型在我们的每一次渲染里都把它丢了,Turbo 却画了出来。它丢掉的是媒介。无论提示词要求什么,蒸馏模型都会滑向摄影写实:一幅鳄鱼刺绣变成了鳄鱼照片,一张炭笔画失去了颗粒,一个剪纸的 Marvin the Martian 变成了搪胶玩偶。外立面上凭空出现的文字与基础模型相同。基础检查点加 LoRA 给出的图像与 Turbo 检查点一样,只是更慢,所以该下载的是检查点。同一个种子会给出与基础模型不同的画面,就像任何尺寸改变一样;许可证也相同,仅限研究和评估。
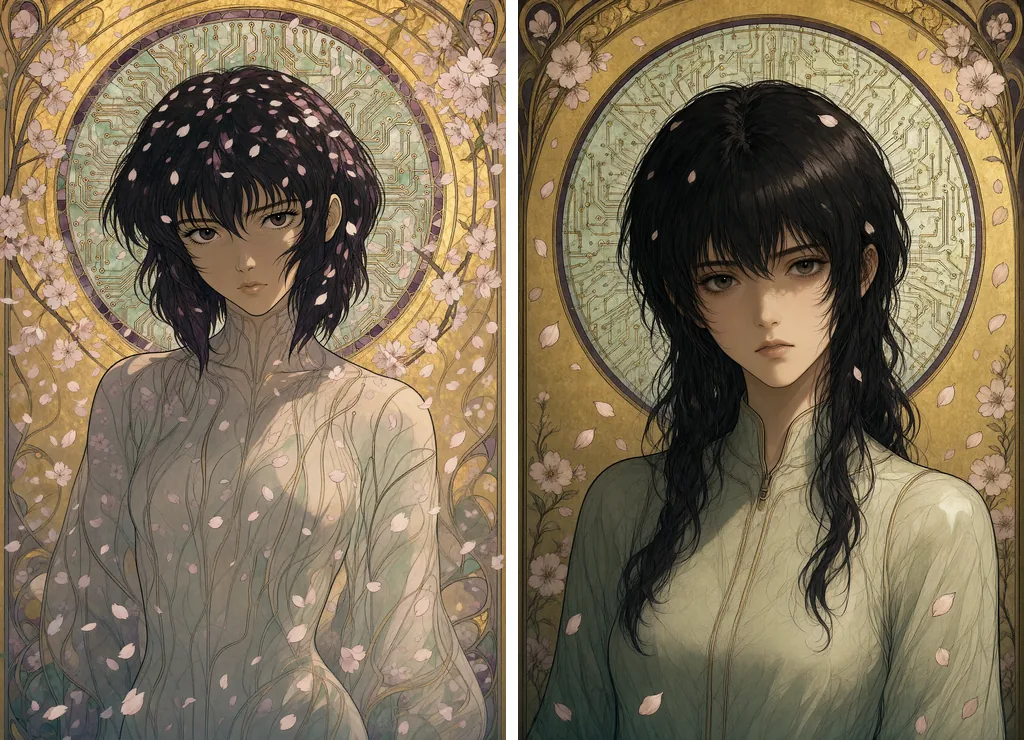
我们的用法:草稿模式。每小时多出七倍的候选图用来筛选,凡是绘画、素描或手工质感的,最终都用 CFG 3 渲染。对于摄影类提示词,Turbo 的结果往往直接就够用。
其他蒸馏版本。LightX2V 于 2026 年 10 月 13 日发布了面向 2.1 的 4 步 Lightning LoRA,社区也有一个 8 步 LoRA,Turbo8;两者都像官方 Turbo 一样以 CFG 1 运行。我们没有实测它们。
前缀缓存节点。ComfyUI 的 QwenImage21Cache 节点只设置模型本就保留的那份缓存的设备和精度;默认值下它什么也不改变。它的 int8 模式把缓存减半,在 2K 或带多张参考图的编辑中显存吃紧时有帮助。我们没有看到可见的损失。
减少步数。16 步省下约五分之一的时间,但会改变构图,锐度也不比 20 步高。如果时间是硬约束,先降尺寸,再降步数。
在本地运行 Qwen-Image 2.1
ComfyUI 原生支持这个模型。三个文件放进惯常的文件夹:扩散模型放 diffusion_models,Qwen3-VL 文本编码器放 text_encoders,VAE 放 vae。16 GB 显卡应选 Comfy-Org 发布的 int8 版本:bf16 权重也能跑,但会溢出到系统内存,生成完全相同的图像要花两到六倍的时间。
图结构很短:UNETLoader,类型为 qwen_image 的 CLIPLoader,VAELoader,TextEncodeQwenImage21 节点(同时接收提示词和负面提示词,输出两个条件),一个所选尺寸的空潜在图像,然后在模型路径上接 APG 和 FreSca,一个 CFG 3、euler 加 simple 调度器的 KSampler,最后是 VAEDecode。要生成透明图像,用模型卡推荐的形式把主体包起来:“This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.”,并保存为 PNG。
显存:int8 模型、编码器和 VAE 在 100 万像素下装进 16 GB 还有富余;我们把前缀缓存设为 int8 跑 400 万像素,从未耗尽显存。一次会话的第一张图会因为加载文件而更慢。