Що таке Qwen-Image 2.1
Qwen-Image 2.1 — це один чекпойнт для двох завдань: генерації зображення з тексту й редагування наявної картинки за реченням і щонайбільше десятьма референсними зображеннями. Генеративна частина — дифузійний трансформер на 7 мільярдів параметрів у парі з текстовим енкодером Qwen3-VL 8B, тим файлом, який ComfyUI завантажує для нього. Саме мовна модель у ролі енкодера дає змогу читати цілі речення, вказівки щодо розташування й слова в лапках, а не списки ключових слів, і наші тести це підтверджують. Коли промпт просить прозорий фон, модель також видає зображення зі справжнім альфа-каналом.
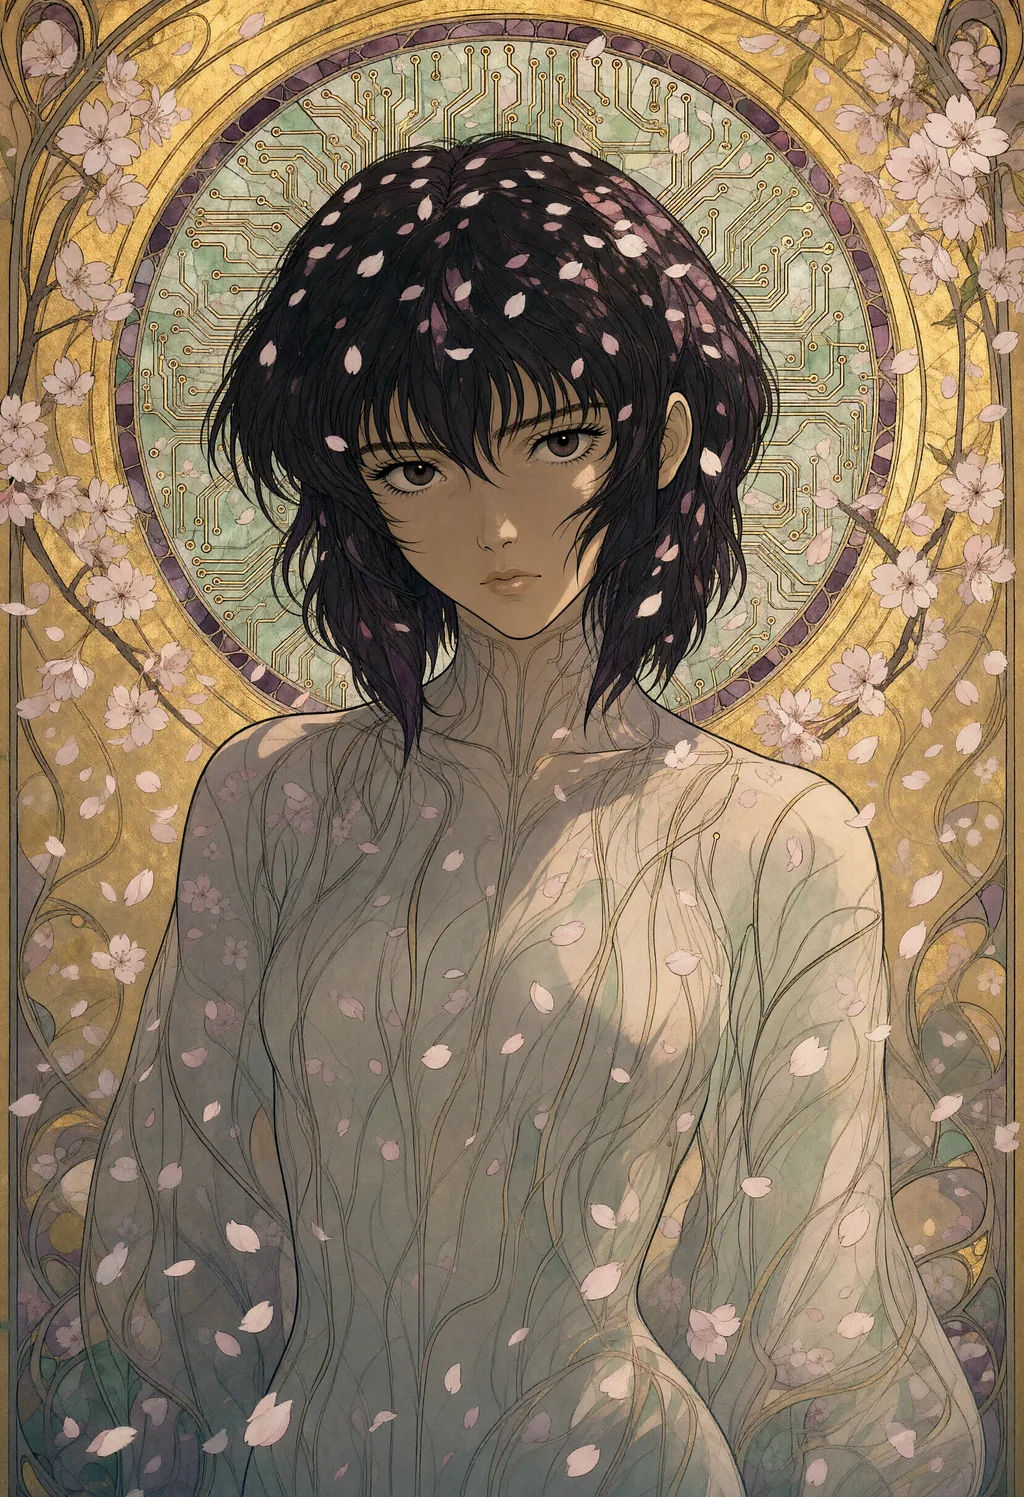
Qwen подає 2.1 як покращену в текстурах, типографіці й освітленні портретів, і вона працює в нативному 2K: 2048 × 2048 для квадрата, 2528 × 1696 для 3:2, 2752 × 1536 для 16:9, без апскейлера. Ціна — час. На споживчій карті з 16 ГБ відеопам’яті ваги int8 дають зображення на 1 мегапіксель приблизно за 40 секунд, а на 4 мегапікселі — приблизно за чотири з половиною хвилини з наведеними нижче налаштуваннями.
Насамперед: ваги поширюються за ліцензією Qwen Research License, лише для досліджень та оцінювання, а будь-яке комерційне використання потребує окремої ліцензії від Qwen. Перша Qwen-Image, випущена в серпні 2025 року, була під Apache 2.0; 2.1 — ні.
Як написати промпт для Qwen-Image 2.1
Пишіть речення, а не теги. Текстовий енкодер — мовна модель: вона читає порядок слів, прийменники й лапки і сприймає все буквально. Промпт «lighthouse cat» перетворюється на кота, намальованого на маяку. Структура, яка дала нам найкращі результати приблизно на тисячі зображень, наведена нижче, саме в такому порядку.
- Спершу техніка й об’єкт: «An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms». Техніка, задана на початку, забарвлює все, що йде далі.
- Обстановка: місце, епоха, погода або те, що наповнює повітря. «in falling cherry blossoms», «in the 1980s», «during a blizzard».
- Світло з його напрямком: «lit from the front by soft diffuse light, with gentle shadows». Напрямок модель виконує; голе «dramatic light» — ні.
- Кадрування: «close-up of the subject, looking at the viewer», середній план, вид згори, крихітний об’єкт у величезному пейзажі.
- Матеріали й палітра: «flowing ink lines, flat gold leaf background, muted jade and plum». Саме це модель рендерить найкраще у 2K.
- Обмеження, вписані в промпт: «no lettering, no watermark», «five fingers on each hand». За guidance 1 негативний промпт ігнорується, тож нести їх має сам промпт.
Увесь промпт ілюстрації вище, саме в такому порядку: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Текст виходить, коли він у лапках і має своє місце: «a banner above the door reads 'OPEN ALL NIGHT'» відтворюється правильно майже щоразу, великими літерами чи ні. Працює і зворотне: вітрина, закусочна чи зал ігрових автоматів, для яких тексту не просили, обростуть вигаданою вивіскою, тож пишіть «no lettering» щоразу, коли в сцені є фасад. Персонажів, яких модель не знає, вона без попередження замінює на двійника: Marsupilami став мавпою, тоді як Mothra і Marvin the Martian вийшли правильно. Кожна картка Qwen на нашій сторінці прикладів промптів дотримується цієї структури, зі своїм seed, розміром і налаштуваннями.
Налаштування, які працюють: виміряно
Офіційний шаблон ComfyUI працює з guidance (CFG) 1 і 25 кроками, а картка моделі використовує 40 кроків. Ми обрали вищий guidance. Під час останнього тесту 16 жовтня 2026 року, на тих самих seed, найдетальніші й найточніші зображення дали такі налаштування:
| Налаштування | Значення |
|---|---|
| Guidance (CFG) | 3, з негативним промптом |
| Негативний промпт | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Патчі моделі | APG (eta 1, norm threshold 10, momentum 0.3), потім FreSca (low 1, high 2, cutoff 8), перед семплером |
| Семплер | euler, планувальник simple |
| Кроки | 25 на 1 мегапікселі, 20 на 4 мегапікселях |
| LoRA | немає |
Guidance — єдине налаштування, яке не змінює сцену: за того самого seed і розміру CFG 1 і CFG 3 дають майже однакову композицію, різниться лише рендеринг. За CFG 1 зображення пласкіше і втрачає дрібну фактуру: стібки вишивки перетворюються на тканину, мультяшне обличчя втрачає зіниці й рот, метал — заклепки. Якщо підняти CFG 1 до 30 кроків, різкість повертається, але не матеріали й не контраст; 40 кроків на 2 мегапікселях дають чисте, але все одно пласкіше зображення, яке до того ж менш надійно читало промпт. APG не дає CFG 3 перенаситити кольори, а FreSca підкреслює високі частоти; обидва діють лише тоді, коли guidance вищий за 1.
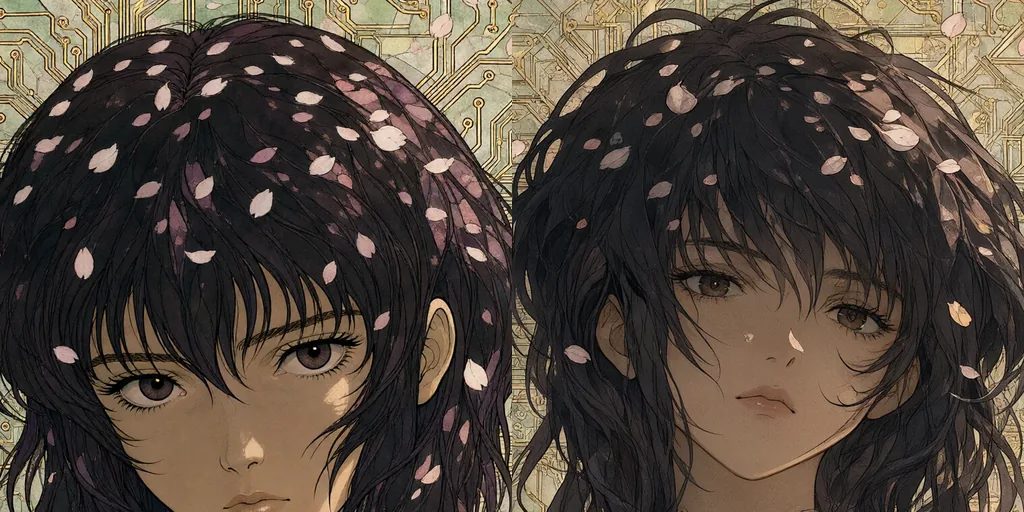
Ціна guidance вище 1 — другий прохід на кожному кроці: CFG 1 удвічі швидший. На нашій карті це 120–135 секунд проти 255–275 для зображення на 4 мегапікселі, і повільніший варіант виявився вартим того в кожній із десяти тестових пар.
Роздільність і кроки: що змінює зображення
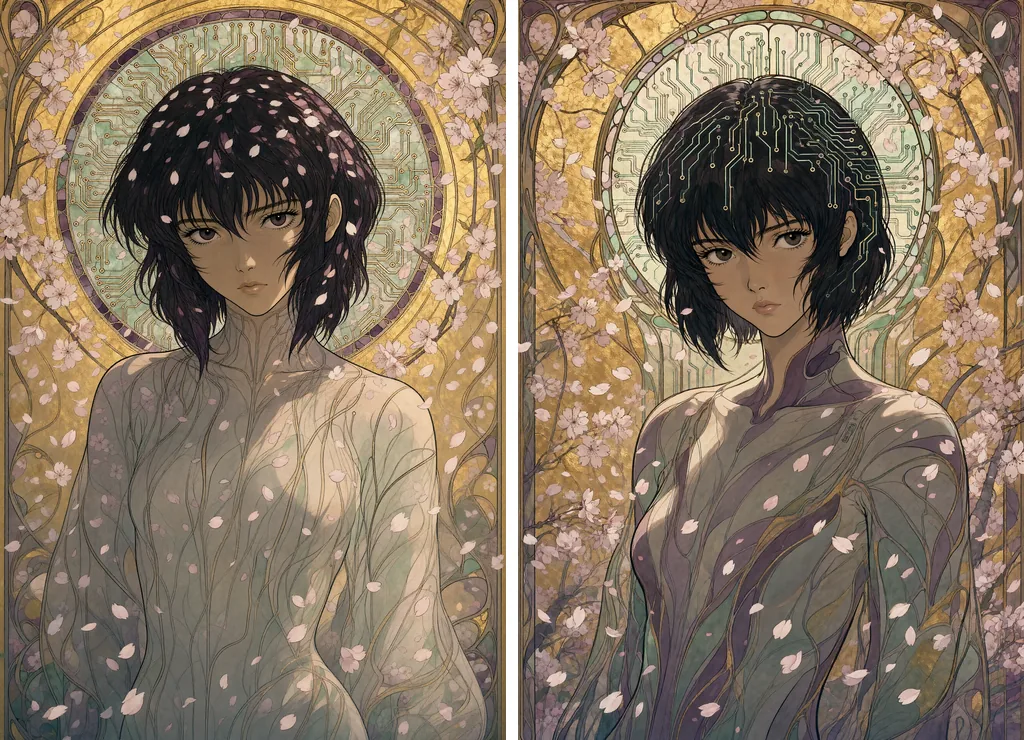
Дві речі нас здивували. Зміна розміру не масштабує зображення, а дає інший дубль того самого seed. Перехід від 1 мегапікселя до 2.5 чи 4 щоразу давав нам іншу картинку; між 2.5 і 4 мегапікселями композиція втрималася у восьми парах із десяти, як на ілюстрації нижче, де зрушили лише деталі: на 2.5 мегапікселя провідні доріжки перейшли з ореолу у волосся. Зміна кількості кроків теж змінює зображення, щойно розрив стає великим: 20 і 25 кроків дають майже ту саму картинку, 16 кроків — уже іншу. Тож немає способу зробити прев’ю на 1 мегапікселі й відрендерити те саме зображення більшим. Спершу виберіть розмір, потім seed.
Час, виміряний із CFG 3, APG і FreSca, вагами int8, на одній споживчій карті з 16 ГБ:
| Розмір | Кроки | Час на зображення |
|---|---|---|
| 1 мегапіксель (1216 × 832) | 25 | близько 40 с |
| 2.5 мегапікселя (1920 × 1312) | 20 | 120–135 с |
| 4 мегапікселі (2432 × 1664) | 20 | 255–275 с |
| 4 мегапікселі | 25 | 315–335 с |
На 2.5 мегапікселя деталі трохи м’якші, ніж на 4, якщо порівнювати ту саму ділянку у 100 %, але стилю промпту модель дотримується щонайменше так само добре, а в наших десяти тестових парах подекуди й краще: вишивка зберегла помітні стібки на 2.5 мегапікселя і перетворилася на фотографію на 4. Для галереї, яку віддають у 1024 пікселях, оптимум — 2.5 мегапікселя за 20 кроків. Для друку — 4 мегапікселі за 20 кроків.
Прискорення: офіційний Turbo, виміряний
Перша Lightning LoRA. 8-крокова Qwen-Image-Lightning LoRA 2025 року навчалася на першій Qwen-Image, шари уваги якої мають ширину 3072. Qwen-Image 2.1 використовує 4096. ComfyUI виводить по одній помилці на кожну вагу уваги, пропускає їх і рендерить голу модель за 8 кроків: на перший погляд досить різко, але LoRA ви не отримуєте, а 8-крокове зображення від недистильованої моделі — не те, чого ви хотіли.
Офіційний Turbo. 9 жовтня 2026 року Qwen випустила Qwen-Image-2.1-Turbo: дистильований чекпойнт, який працює за 8 кроків із CFG 1 і фіксованим розкладом сигм; Comfy-Org постачає його як файл int8 і як LoRA для базової моделі, з власними шаблонами в ComfyUI. Ми виміряли його 17 жовтня на тих самих десяти seed і розмірах, що й наші рендери з CFG 3, із точним графом шаблону.
| Налаштування | Час на зображення |
|---|---|
| Чекпойнт Turbo, 8 кроків, 1 мегапіксель | 9–10 с |
| Чекпойнт Turbo, 8 кроків, 4 мегапікселі | 38–39 с |
| Базовий чекпойнт плюс LoRA Turbo, 8 кроків, 4 мегапікселі | 52–55 с |
| Наше налаштування, CFG 3, 20 кроків, 4 мегапікселі | 255–275 с |
Усемеро швидше на 4 мегапікселях, учетверо — на 1, і зображення чисті: різкі, добре освітлені, без анатомічних похибок на наших десяти seed, текст правильний там, де його правильно відтворює й базова модель. Об’єкти з промпту на місці, подекуди навіть краще, ніж у базової моделі: черепаха у своєму гоночному авто, яку базова модель губила в кожному нашому рендері, з Turbo з’явилася. Втрачає він техніку. Дистильована модель дрейфує до фотографічного реалізму, хай чого просить промпт: вишивка з крокодилом стала фотографією крокодила, вугільний малюнок втратив зерно, Marvin the Martian у техніці витинанки перетворився на вінілову іграшку. Вигадані написи на фасадах такі самі, як у базової моделі. LoRA на базовому чекпойнті дає ті самі зображення, що й чекпойнт Turbo, лише повільніше, тож завантажувати варто саме чекпойнт. Seed дає іншу картинку, ніж у базової моделі, як і за будь-якої зміни розміру, а ліцензія та сама — лише дослідження та оцінювання.
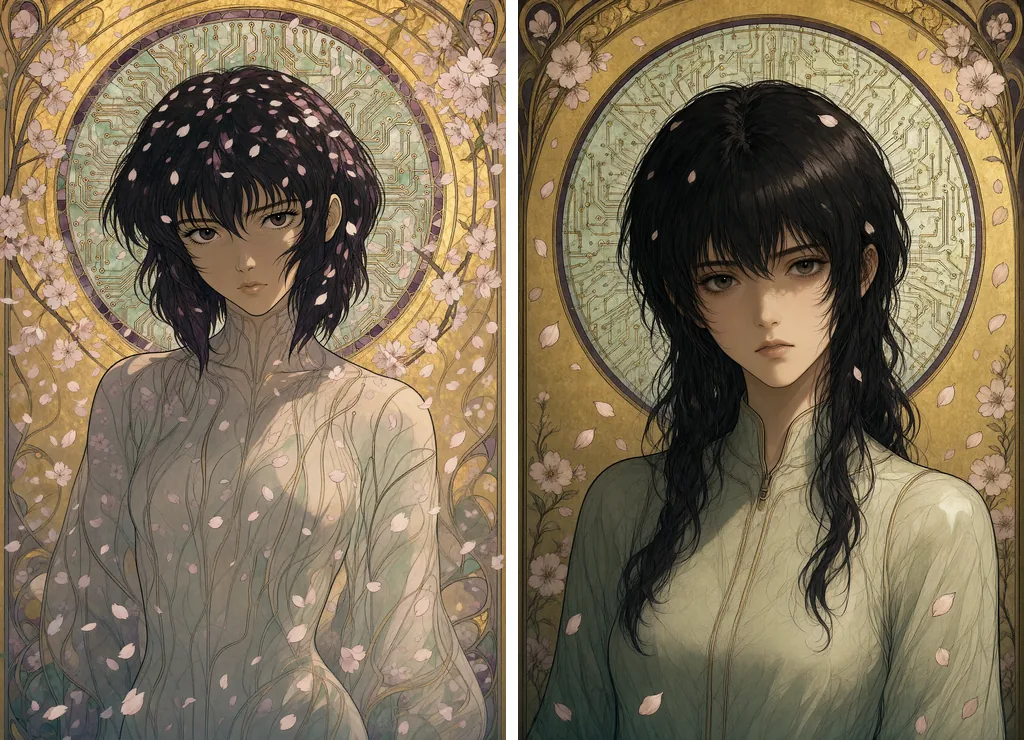
Як ми його використовуємо: як чорновий режим. Усемеро більше кандидатів на годину для відбору, а фінальний рендер із CFG 3 — для всього мальованого, рисованого чи рукотворного. Для фотографічних промптів результат Turbo часто досить добрий і так.
Інші дистиляції. LightX2V опублікувала 4-крокову Lightning LoRA для 2.1 13 жовтня 2026 року, існує й спільнотна 8-крокова LoRA, Turbo8; обидві працюють із CFG 1, як і офіційний Turbo. Ми їх не вимірювали.
Вузол кешу префікса. Вузол QwenImage21Cache у ComfyUI лише задає пристрій і точність кешу, який модель і так веде; з типовими значеннями він нічого не змінює. Його режим int8 удвічі зменшує кеш і допомагає, коли бракує пам’яті у 2K або в редагуванні з кількома референсними зображеннями. Помітних втрат із ним ми не побачили.
Менше кроків. 16 кроків економлять приблизно п’яту частину часу, але змінюють композицію і не додають різкості порівняно з 20. Якщо обмеження — час, спершу зменшуйте розмір, а вже потім кроки.
Як запустити Qwen-Image 2.1 локально
ComfyUI підтримує модель нативно. Три файли кладуть у звичні теки: дифузійну модель — у diffusion_models, текстовий енкодер Qwen3-VL — у text_encoders, VAE — у vae. На карті з 16 ГБ беріть версії int8, опубліковані Comfy-Org: ваги bf16 теж працюють, але виливаються в системну пам’ять і потребують у два–шість разів більше часу на ідентичні зображення.
Граф короткий: UNETLoader, CLIPLoader із типом qwen_image, VAELoader, вузол TextEncodeQwenImage21, який приймає промпт і негативний промпт разом і видає обидва кондиціонування, порожній латент потрібного розміру, далі APG і FreSca на шляху моделі, KSampler із CFG 3, euler і планувальником simple, і VAEDecode. Для прозорого зображення обгорніть об’єкт у рекомендовану карткою моделі форму: «This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.» — і збережіть як PNG.
Пам’ять: модель int8, енкодер і VAE вміщуються в 16 ГБ на 1 мегапікселі із запасом; 4 мегапікселі ми рендерили з кешем префікса, встановленим в int8, і пам’ять не закінчилася жодного разу. Перше зображення в сеансі триває довше, поки завантажуються файли.