Was Qwen-Image 2.1 ist
Qwen-Image 2.1 ist ein einziger Checkpoint für zwei Aufgaben. Es erzeugt ein Bild aus Text, und es bearbeitet ein vorhandenes Bild anhand eines Satzes und bis zu zehn Referenzbildern. Der Erzeugungsteil ist ein Diffusions-Transformer mit 7 Milliarden Parametern. Er ist mit einem Qwen3-VL-8B-Text-Encoder gekoppelt, der in ComfyUI als separate Datei geladen wird.
Ein Sprachmodell als Encoder ist der Grund, warum es ganze Sätze, Layout-Anweisungen und Wörter in Anführungszeichen liest statt Stichwortlisten.
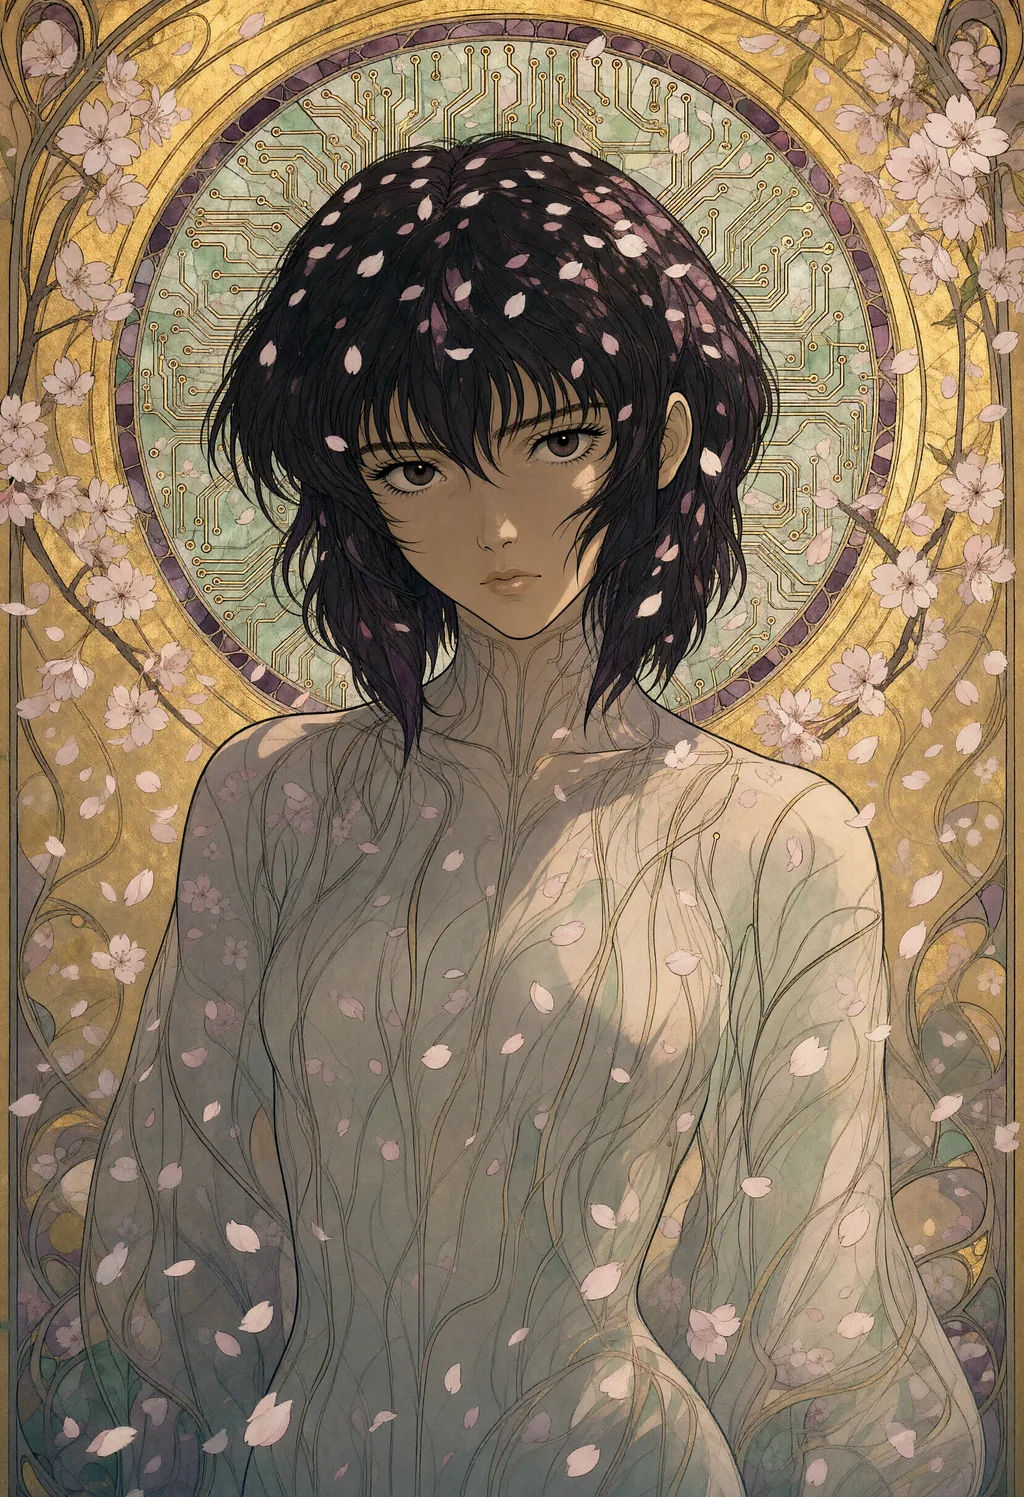
Qwen präsentiert 2.1 als besser bei Texturen, Typografie und Porträtlicht. Es arbeitet in nativem 2K ohne Hochskalierung: 2048 × 2048 für ein Quadrat, 2528 × 1696 für 3:2, 2752 × 1536 für 16:9. Es kann außerdem einen echten Alphakanal ausgeben, wenn der Prompt einen transparenten Hintergrund verlangt.
Der Preis ist Zeit. Auf einer Consumer-Karte mit 16 GB Videospeicher brauchen die int8-Gewichte etwa 40 Sekunden für ein 1-Megapixel-Bild. Ein 4-Megapixel-Bild dauert mit den Einstellungen unten etwa viereinhalb Minuten.
Eines sollte man vor dem Herunterladen wissen. Die Gewichte stehen unter der Qwen Research License: nur Forschung und Evaluation. Jede kommerzielle Nutzung braucht eine separate Lizenz von Qwen. Das erste Qwen-Image, veröffentlicht im August 2025, war Apache 2.0. Version 2.1 ist es nicht.
So schreibt man einen Prompt für Qwen-Image 2.1
Schreiben Sie Sätze, keine Tags. Der Text-Encoder ist ein Sprachmodell. Er liest Wortstellung, Präpositionen und Anführungszeichen, und er nimmt alles wörtlich. Aus einer „lighthouse cat“ wird eine Katze, die auf einen Leuchtturm gemalt ist.
Die Struktur unten brachte über etwa tausend Bilder die besten Ergebnisse. Behalten Sie diese Reihenfolge bei.
- Medium und Motiv zuerst: „An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms“. Das am Anfang gesetzte Medium färbt alles, was danach kommt.
- Umgebung: Ort, Epoche, Wetter oder das, was die Luft erfüllt. „in falling cherry blossoms“, „in the 1980s“, „during a blizzard“.
- Licht mit Richtung: „lit from the front by soft diffuse light, with gentle shadows“. Der Richtung wird gefolgt. Einem bloßen „dramatic light“ nicht.
- Bildausschnitt: „close-up of the subject, looking at the viewer“, Halbnah, von oben gesehen, das Motiv winzig in einer weiten Landschaft.
- Materialien und Palette: „flowing ink lines, flat gold leaf background, muted jade and plum“. Das ist es, was das Modell in 2K am besten rendert.
- Einschränkungen, in den Prompt geschrieben: „no lettering, no watermark“, „five fingers on each hand“. Bei Guidance 1 wird der Negativ-Prompt ignoriert, also muss der Prompt selbst sie tragen.
Der gesamte Prompt der Illustration oben, in dieser Reihenfolge: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Text funktioniert, wenn er in Anführungszeichen steht und platziert wird. „A banner above the door reads 'OPEN ALL NIGHT'“ kommt fast jedes Mal richtig heraus, in Großbuchstaben oder nicht.
Das Umgekehrte gilt auch. Eine Ladenfront, ein Diner oder eine Spielhalle ohne angeforderten Text bekommt ein erfundenes Schild. Sagen Sie also „no lettering“, sobald die Szene eine Fassade enthält.
Figuren, die das Modell nicht kennt, werden ohne Vorwarnung durch einen Doppelgänger ersetzt. Aus dem Marsupilami wurde ein Affe. Mothra und Marvin the Martian kamen richtig heraus.
Jede Qwen-Karte auf der Seite mit Prompt-Beispielen folgt dieser Struktur, mit Seed, Größe und Einstellungen.
Einstellungen, die funktionieren, gemessen
Das offizielle ComfyUI-Template läuft mit einer Guidance (CFG) von 1 und 25 Schritten. Die Modellkarte nutzt 40 Schritte. Die Einstellungen unten haben sich bei CFG 3 eingependelt.
Beim letzten Test am 16. Oktober 2026 lieferten diese Einstellungen auf denselben Seeds die detailliertesten und treuesten Bilder:
| Einstellung | Wert |
|---|---|
| Guidance (CFG) | 3, mit Negativ-Prompt |
| Negativ-Prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Modell-Patches | APG (eta 1, norm threshold 10, momentum 0,3), dann FreSca (low 1, high 2, cutoff 8), vor dem Sampler |
| Sampler | euler, Scheduler simple |
| Schritte | 25 bei 1 Megapixel, 20 bei 2,5 und 4 Megapixeln |
| LoRA | keines |
Die Guidance ist die einzige Einstellung, die die Szene nicht verändert. Bei gleichem Seed und gleicher Größe ergeben CFG 1 und CFG 3 fast dieselbe Komposition. Was sich unterscheidet, ist das Rendering.
Bei CFG 1 ist das Bild flacher und verliert feine Textur. Stickstiche werden zu Stoff. Ein Cartoon-Gesicht verliert Pupillen und Mund. Metall verliert seine Nieten.
CFG 1 auf 30 Schritte zu treiben, bringt die Schärfe zurück, aber weder die Materialien noch den Kontrast. Bei 2 Megapixeln, einer einmal getesteten Größe, ergeben 40 Schritte ein sauberes Bild, das immer noch flacher ist, und der Prompt wird weniger zuverlässig gelesen.
APG hält CFG 3 davon ab, zu übersättigen. FreSca schärft die hohen Frequenzen. Beide wirken nur, wenn die Guidance über 1 liegt.
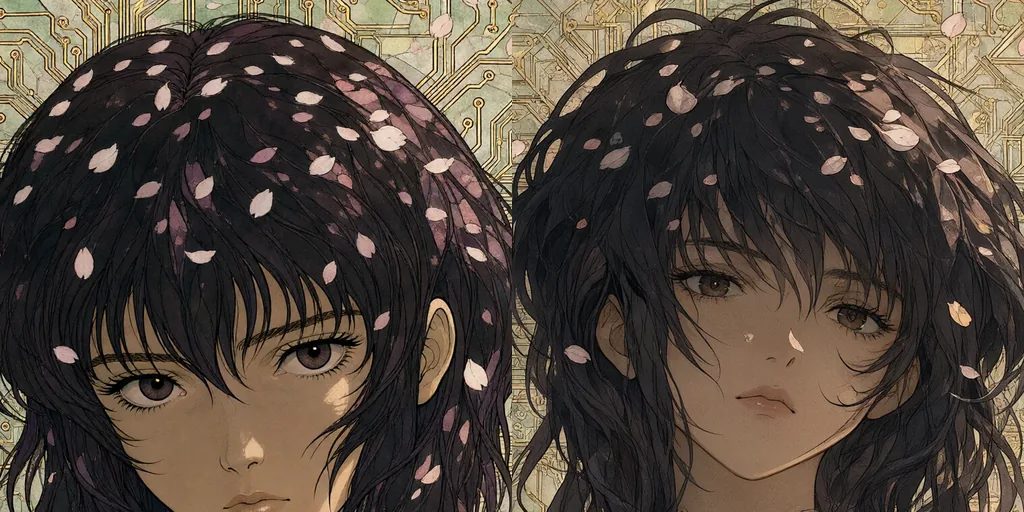
Eine Guidance über 1 kostet einen zweiten Durchlauf pro Schritt, CFG 1 ist also doppelt so schnell. Auf der Testkarte sind das 120 bis 135 Sekunden gegenüber 255 bis 275 für ein 4-Megapixel-Bild. Das langsamere Bild war bei jedem einzelnen von zehn Testpaaren die Mühe wert.
Auflösung und Schritte: Was das Bild verändert
Wie jedes Diffusionsmodell skaliert Qwen-Image 2.1 das Bild nicht, wenn sich die Größe ändert. Es entsteht eine andere Version desselben Seeds, ein bei 1 Megapixel gefundener Seed lässt sich also nicht auf 2K übertragen.
Von 1 Megapixel auf 2,5 oder 4 zu gehen, ergab in jedem getesteten Paar ein anderes Bild. Zwischen 2,5 und 4 Megapixeln hielt die Komposition in acht von zehn Paaren.
In der Illustration unten haben sich nur die Details verschoben. Bei 2,5 Megapixeln sind die Leiterbahnen vom Heiligenschein ins Haar gewandert.
Auch die Zahl der Schritte verändert das Bild, sobald der Abstand groß ist. 20 und 25 Schritte ergeben fast dasselbe Bild. 16 Schritte driften ab. Es gibt also keinen Weg, bei 1 Megapixel eine Vorschau zu machen und dasselbe Bild größer zu rendern. Wählen Sie zuerst die Größe, dann den Seed.
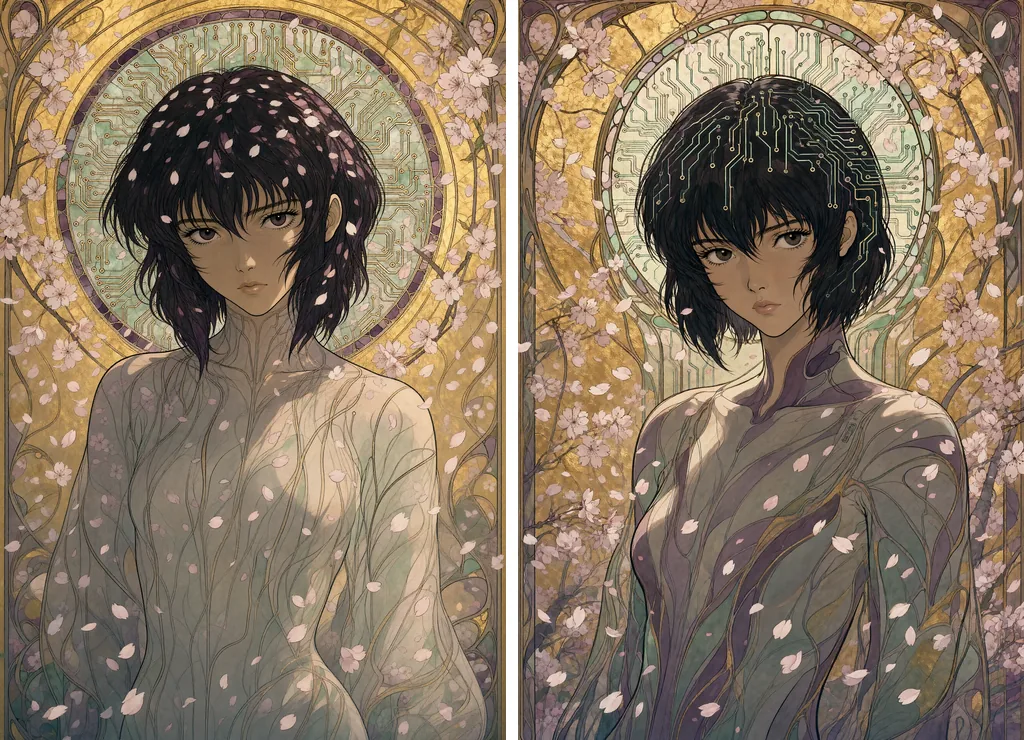
Zeiten gemessen mit CFG 3, APG und FreSca, int8-Gewichten, auf einer einzelnen 16-GB-Consumer-Karte, im Querformat oder dem entsprechenden Hochformat:
| Größe | Schritte | Zeit pro Bild |
|---|---|---|
| 1 Megapixel (1216 × 832) | 25 | etwa 40 s |
| 2,5 Megapixel (1920 × 1312) | 20 | 120 bis 135 s |
| 4 Megapixel (2432 × 1664) | 20 | 255 bis 275 s |
| 4 Megapixel | 25 | 315 bis 335 s |
Bei 2,5 Megapixeln sind die Details etwas weicher als bei 4, wenn man denselben Bereich bei 100 % vergleicht. Aber das Modell folgt dem Stil des Prompts mindestens ebenso gut, und bei den zehn Testpaaren manchmal besser. Eine Stickerei zeigte ihre Stiche bei 2,5 Megapixeln deutlicher als bei 4.
Für eine Galerie, die mit 1024 Pixeln ausgeliefert wird, sind 2,5 Megapixel bei 20 Schritten der beste Kompromiss. Für einen Druck 4 Megapixel bei 20 Schritten.
Beschleunigung: Turbo, Turbo mit Guidance und der Rest
Das Turbo. Qwen hat Qwen-Image-2.1-Turbo am 9. Oktober 2026 veröffentlicht. Es ist ein destillierter Checkpoint, der in 8 Schritten bei CFG 1 mit einem festen Sigma-Schedule läuft. Comfy-Org liefert ihn als int8-Datei und als LoRA für das Basismodell aus, mit eigenen Templates in ComfyUI. Gemessen wurde am 17. Oktober auf denselben zehn Seeds und Größen wie die CFG-3-Renderings dieses Guides, mit dem exakten Graphen des Templates.
| Einstellung | Zeit pro Bild |
|---|---|
| Turbo-Checkpoint, 8 Schritte, CFG 1, 1 Megapixel | 9 bis 10 s |
| Turbo-Checkpoint, 8 Schritte, CFG 1, 4 Megapixel | 38 bis 39 s |
| Turbo mit Guidance, unten beschrieben: Turbo-Checkpoint, 8 Schritte, CFG 3 mit APG und FreSca, 4 Megapixel | 66 bis 71 s |
| Basis-Checkpoint plus Turbo-LoRA, 8 Schritte, CFG 1, 4 Megapixel | 52 bis 55 s |
| Basis-Checkpoint, CFG 3, 20 Schritte, 4 Megapixel | 255 bis 275 s |
Siebenmal schneller bei 4 Megapixeln, viermal bei 1. Die Bilder sind sauber: scharf, gut ausgeleuchtet, keine Anatomiefehler auf den zehn Seeds, Schriftzüge richtig bei denselben Prompts wie beim Basismodell. Die Objekte des Prompts sind da, manchmal besser als beim Basismodell. Die Schildkröte in ihrem Rennwagen, die das Basismodell in jedem Rendering weggelassen hatte, erschien mit Turbo.
Was verloren geht, ist das Medium. Bei jedem nicht fotografischen Prompt der zehn Seeds driftete das destillierte Modell zum fotografischen Realismus. Eine Stickerei eines Krokodils wurde zum Foto eines Krokodils. Eine Kohlezeichnung verlor ihre Körnung. Ein Marvin the Martian aus Scherenschnitt wurde zur Vinylfigur. Erfundene Schriftzüge auf Fassaden sind dieselben wie beim Basismodell.
Auf den zehn Seeds lieferte das LoRA auf dem Basis-Checkpoint dieselben Bilder wie der Turbo-Checkpoint, nur langsamer. Herunterladen sollte man also den Checkpoint. Ein Seed ergibt ein anderes Bild als beim Basismodell, wie bei jeder Größenänderung. Die Lizenz ist dieselbe: nur Forschung und Evaluation.
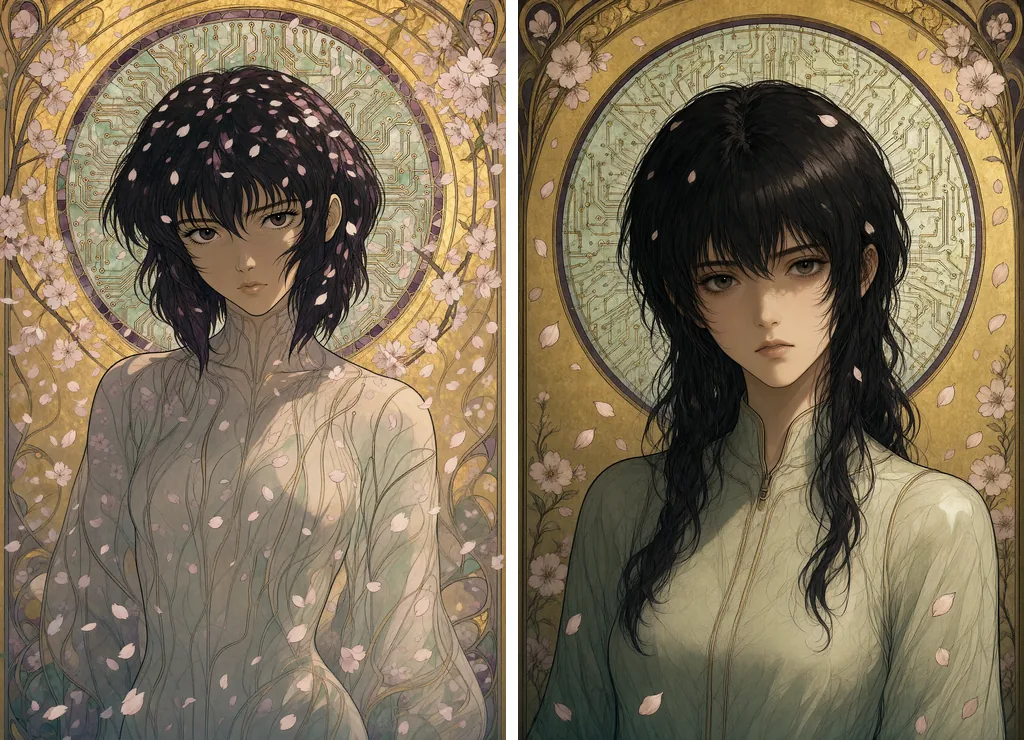
Das Turbo mit Guidance. Das Turbo ist nicht auf CFG 1 festgelegt. Getestet am 17. Oktober 2026 auf denselben zehn Seeds plus der Illustration dieses Guides. Behalten Sie seinen Checkpoint und seine 8 festen Sigmas, und übernehmen Sie nur den Guidance-Block des Basis-Presets: CFG 3, den Negativ-Prompt, APG, dann FreSca.
Der Graph ist das Turbo-Template selbst. Setzen Sie seinen CFGGuider auf 3 statt 1, tragen Sie den Negativ-Prompt ein, und fügen Sie APG, dann FreSca auf dem Modellpfad zwischen Loader und Guider ein. Der Knoten ManualSigmas und der Sampler bleiben, wie sie sind.
Das Ergebnis behält die Komposition des Turbo und holt zurück, was CFG 1 verflacht hatte: Kontrast, Sättigung und feine Details. In der Illustration dieses Guides kommen die Leiterbahnen des Heiligenscheins scharf und vergoldet zurück, und die Blütenblätter kehren wieder. Auf den zehn Test-Seeds werden Schuppen, Fell und die bestickte Weste auf dieselbe Weise schärfer. Was es nicht zurückholt, ist das Medium. Die Stickerei bleibt ein Foto eines Krokodils.
Der Preis ist der zweite Durchlauf pro Schritt: 66 bis 71 Sekunden für ein 4-Megapixel-Bild gegenüber 38 bis 39. Das ist immer noch fast viermal schneller als das Basismodell.
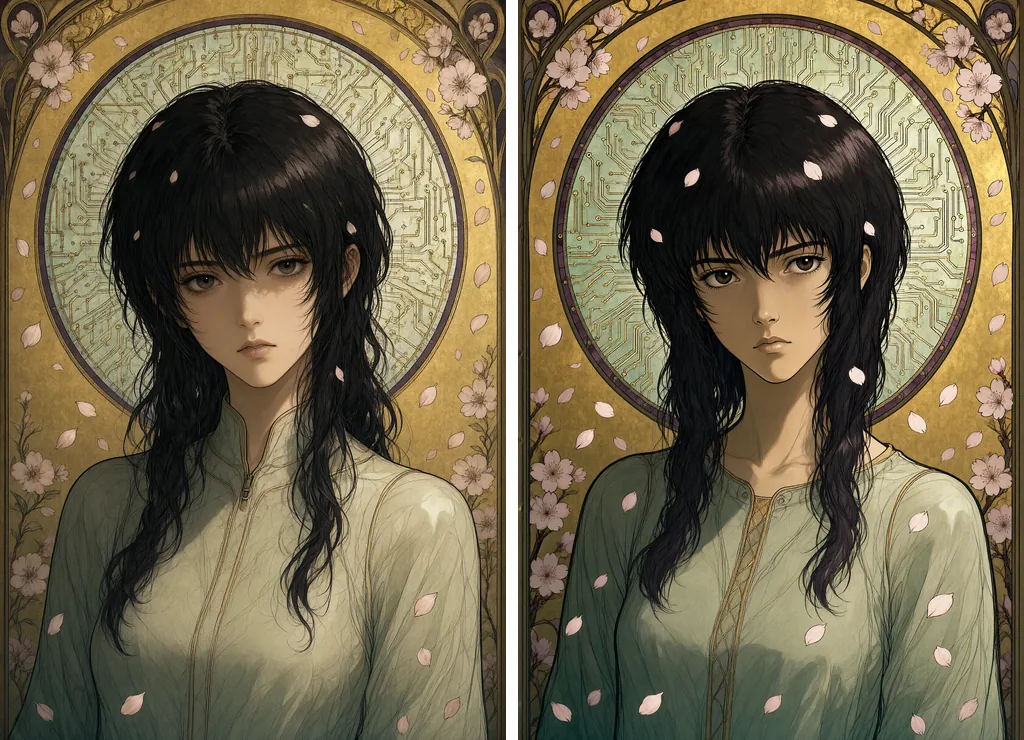
Workflow herunterladen. Der ComfyUI-Workflow des Turbo mit Guidance (JSON) rendert diese Illustration genau so: 1664 × 2432, Seed 57658043, CFG 3 mit APG und FreSca, der Negativ-Prompt dieses Guides. Die Datei in ComfyUI ziehen; sie erwartet die drei Modelldateien, die im letzten Abschnitt genannt sind. Frei weiterverwendbar unter CC BY 4.0, mit einem Link auf diese Seite.
Versuchen Sie nicht, dem Turbo mit mehr Schritten zu helfen. Mit 20 Schritten und dem Scheduler simple bei 4 Megapixeln und CFG 3, als wäre es das Basismodell, übertreibt es: harte Haarsträhnen, ein körniger Heiligenschein, überzogener Kontrast. Und es dauert 169 Sekunden. Der destillierte Checkpoint will seine 8 Sigmas.
Eine sinnvolle Aufteilung. Das reine Turbo als Entwurfsmodus, mit siebenmal mehr Kandidaten pro Stunde für die Auswahl. Das Turbo mit Guidance, wenn ein fotografischer oder klar gezeichneter Prompt schnell Details braucht. Das Basismodell bei CFG 3 für alles Gemalte, Gezeichnete oder Handgemachte, wo es um das Medium selbst geht.
Andere Destillationen. LightX2V hat am 13. Oktober 2026 ein 4-Schritt-Lightning-LoRA für 2.1 veröffentlicht. Es gibt auch ein 8-Schritt-LoRA aus der Community, Turbo8. Beide laufen wie das Turbo mit CFG 1. Keines von beiden wurde hier gemessen.
Der Prefix-Cache-Knoten. ComfyUIs Knoten QwenImage21Cache legt nur Gerät und Präzision des Caches fest, den das Modell ohnehin führt. Mit seinen Standardwerten ändert er nichts. Sein int8-Modus halbiert den Cache, was hilft, wenn der Speicher in 2K oder beim Bearbeiten mit mehreren Referenzbildern knapp wird. In diesen Tests kam damit kein sichtbarer Verlust.
Weniger Schritte. 16 Schritte sparen etwa ein Fünftel der Zeit, verändern aber die Komposition und gewinnen gegenüber 20 keine Schärfe. Wenn die Zeit die Grenze ist, senken Sie zuerst die Größe, dann die Schritte.
Qwen-Image 2.1 lokal ausführen
ComfyUI unterstützt das Modell nativ. Drei Dateien kommen in die üblichen Ordner: das Diffusionsmodell nach diffusion_models, der Qwen3-VL-Text-Encoder nach text_encoders, die VAE nach vae.
Auf einer 16-GB-Karte nehmen Sie die von Comfy-Org veröffentlichten int8-Versionen. Die bf16-Gewichte funktionieren auch, laufen aber in den Systemspeicher über und brauchen zwei- bis sechsmal so lang, ohne sichtbaren Gewinn.
Der Graph ist kurz:
- UNETLoader, CLIPLoader mit dem Typ
qwen_image, VAELoader; - TextEncodeQwenImage21, der Prompt und Negativ-Prompt zusammen entgegennimmt und beide Conditionings ausgibt;
- ein leeres Latent in der gewählten Größe;
- APG, dann FreSca auf dem Modellpfad;
- ein KSampler mit CFG 3, euler und dem Scheduler simple, dann VAEDecode.
Für ein transparentes Bild betten Sie das Motiv in die von der Modellkarte empfohlene Form ein: „This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.“ Dann als PNG speichern.
Speicher: Bei 1 Megapixel laufen das int8-Modell, der Encoder und die VAE in 16 GB, ohne den Systemspeicher anzurühren. ComfyUI lagert den Encoder aus dem Videospeicher aus, sobald der Prompt kodiert ist. Bei 4 Megapixeln war der Prefix-Cache auf int8 gesetzt, und der Speicher ging nie aus. Das erste Bild einer Sitzung dauert länger, während die Dateien geladen werden.