Stable Diffusion online
Künstliche Intelligenz für alle zugänglich
Erstellen Sie KI-Bilder kostenlos, direkt in Ihrem Browser.
Geben Sie einen Prompt ein. Unsere Tools erstellen einzigartige Bilder in Sekunden. Kein Konto, keine GPU, keine Installation erforderlich.
Kostenlose Online-Tools zur Bildgenerierung
 Stable Diffusion 3
Text-zu-Bild mit Stable Diffusion 3, ohne Konto
 Inpainting Beliebt
Beliebigen Bildbereich per Text-Prompt neu malen
 Upscaling Beliebt
Ein Bild bis zu 2x vergrößern, mit schärferen Details
 Stable Diffusion XL demo
Kostenlose Online-Demo von Stable Diffusion XL 1.0, ohne Konto
Kostenloses KI-Toolkit
Von der Community erstellte Bilder
 a llama wearing a knitted sweater it clearly made itself sitting with yarn embroidery style
 a baltic half timber from a passing train low poly
 a hammam dome with star skylights during a festival watercolor
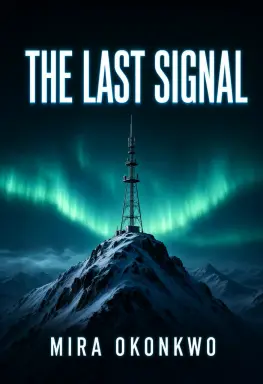 a science fiction book cover the title the last signal is at the top centre in bold condensed white letters
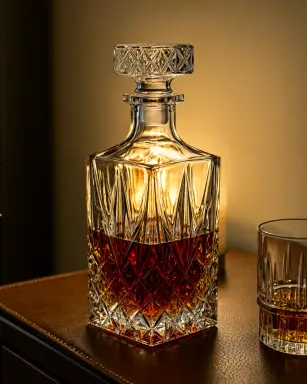 a product photograph of a crystal whisky decanter half full on a leather topped desk next to a tumbler lit
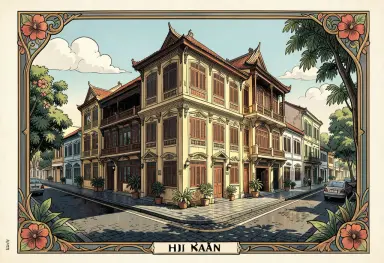 hoi an art nouveau illustration at midday with hard shadows
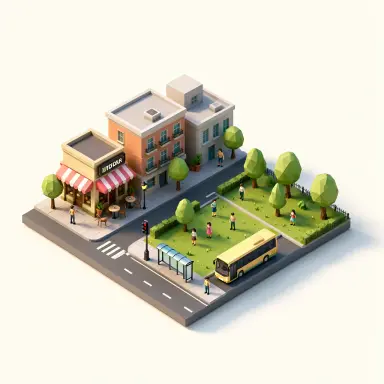 an isometric 3d render of a tiny city block with a caf a park a bus stop and little people lit from the top
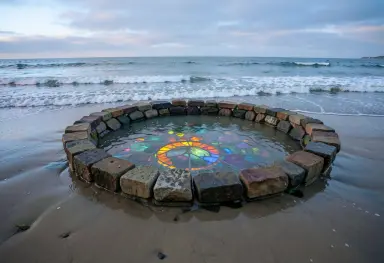 a stone circle at high tide stained glass
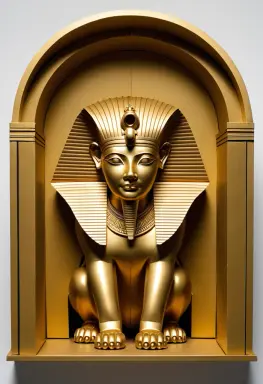 a sphinx riddle gate made of folded paper luminist painting
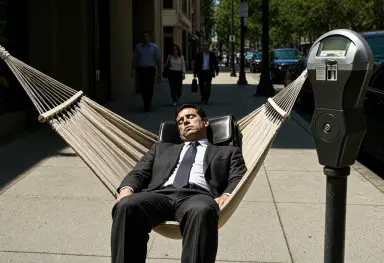 a photograph of a man in a business suit asleep in a hammock strung between two parking meters on a sunny
 a product launch banner for headphones a pair of sleek black headphones floating with soundwave light ribbons
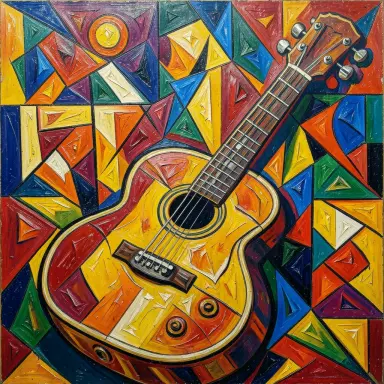 cubist painting of a guitar
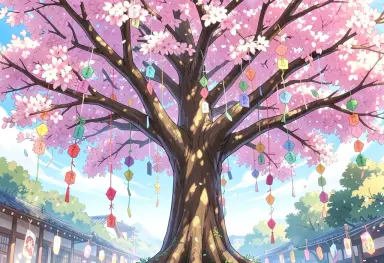 anime background a tanabata wish tree
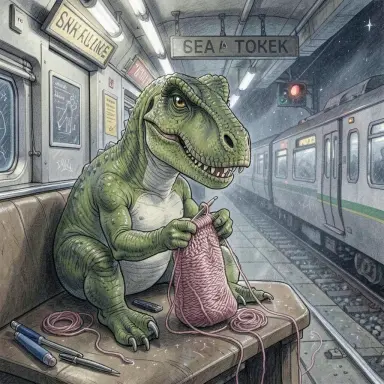 a dinosaur knitting during a train delay chalk drawing
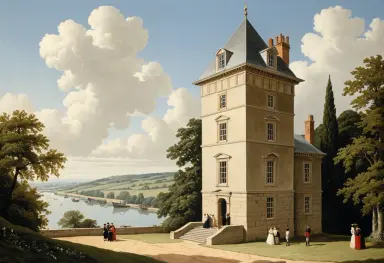 a georgian tower house on a bank holiday academic painting in the style of michael parkes
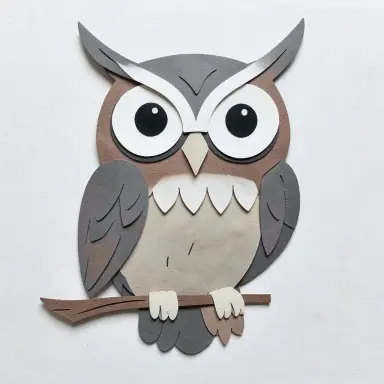 papercut art of an owl
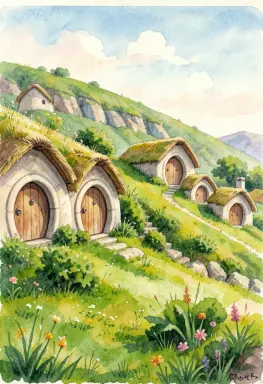 a village of hobbit holes with round doors on a green hillside gouache painting cozy
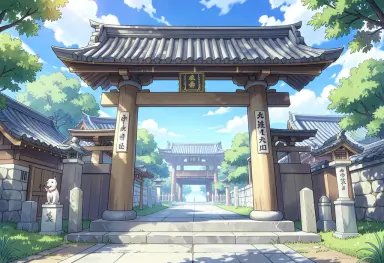 anime background of a shrine gate
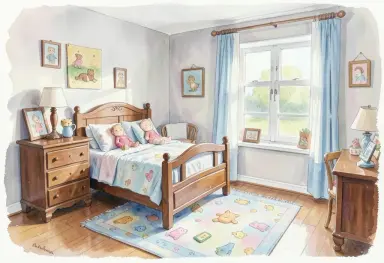 gouache painting of a child s bedroom
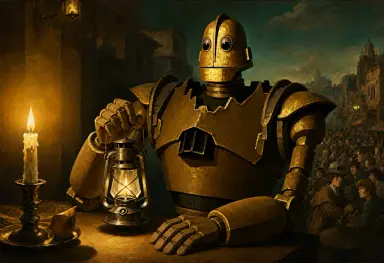 iron giant holding a lantern in the 1980s rendered as a vanitas painting lit by candlelight from the left
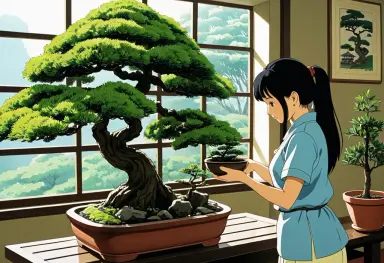 anime style a woman tending bonsai in the style of hayao miyazaki
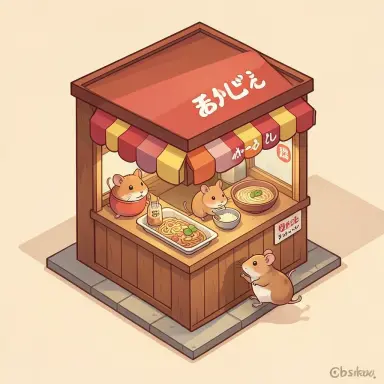 a hamster running a tiny ramen stand for mice isometric illustration warm colours
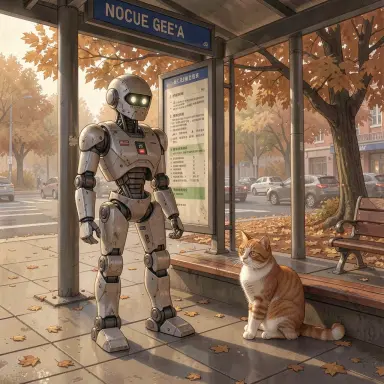 a robot and a cat at a bus stop in autumn browns
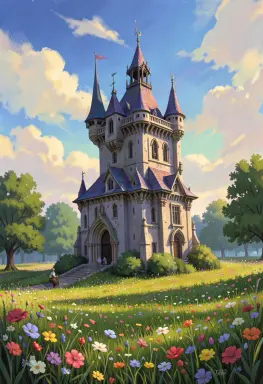 a wizard tower in a flower meadow painting
Was ist Stable Diffusion?
Stable Diffusion ist eine KI, die Bilder aus Text erstellt. Tippe, was du willst — sie generiert das Bild.
Entwickelt von StabilityAI , sie ist Open Source. Sie läuft auf einer normalen GPU — keine Cloud nötig. Die Community ist sehr aktiv. Viele Modelle und Add-ons sind kostenlos. Du kannst sie sogar mit eigenen Bildern trainieren!
Sie wurde mit Millionen von Bildern trainiert. Nutze sie für digitale Kunst, Fotobearbeitung, Animationen und mehr.
Beispiele finden Sie in unserer Prompt-Sammlung, Bildergalerie und mit dem Bildbrowser .Häufig gestellte Fragen
Ist Stable Diffusion kostenlos?
Ja. Stable Diffusion ist ein Open-Source-Modell, das Sie kostenlos herunterladen und auf dem eigenen Computer ausführen können. Auch alle Werkzeuge dieser Website sind kostenlos: Die Online-Demos, Inpainting, Upscaling und der Prompt-Generator funktionieren ohne Konto, und Text-zu-Bild auf unserer eigenen GPU erfordert nur ein kostenloses Konto. Keine Credits, kein Abo.
Brauche ich ein Konto, um Bilder zu generieren?
Für die Online-Demos, Inpainting, Bild-Upscaling und den Prompt-Generator ist kein Konto nötig: Seite öffnen und loslegen. Ein kostenloses Konto, das mit einer E-Mail-Adresse erstellt wird, schaltet Text-zu-Bild auf unserer eigenen GPU mit Stable Diffusion 1.5 und SDXL 1.0 frei, mit voller Kontrolle über Steps, CFG-Skala, Seed und Bildgröße.
Wie benutze ich Stable Diffusion online?
Öffnen Sie die kostenlose Demo, beschreiben Sie das gewünschte Bild und klicken Sie auf Generate. Das Bild erscheint nach wenigen Sekunden und lässt sich herunterladen. Für bessere Ergebnisse ergänzen Sie Angaben zu Stil und Licht, schreiben einen negativen Prompt oder ändern den Seed, um Varianten zu erkunden. Es muss nichts installiert werden.
Ist das die offizielle Website von Stable Diffusion?
Nein. Stable Diffusion wird von Stability AI entwickelt, dessen offizielle Website stability.ai ist. stablediffusion.fr ist eine unabhängige Website, seit 2022 online, die kostenlose Werkzeuge bietet, um Stable Diffusion und andere offene Modelle im Browser zu nutzen, dazu Anleitungen, Prompt-Beispiele und Künstlerreferenzen. Sie ist nicht mit Stability AI verbunden.
Was ist ein Prompt?
Ein Prompt ist eine Textbeschreibung, die die KI leitet. Er kann Motiv, Kunststil, Beleuchtung, Stimmung und Medium enthalten — zum Beispiel: 'ein mittelalterlicher Ritter in einem dunklen Wald, Ölgemälde, dramatische Beleuchtung, kinematografisch'. Je präziser Ihr Prompt, desto näher das Ergebnis Ihrer Vorstellung. Halten Sie ihn unter 350 Zeichen für beste Ergebnisse.
Ein negativer Prompt sagt der KI, was nicht im Bild erscheinen soll.
Den ganzen Ratgeber lesen: Wie schreibt man einen Stable Diffusion Prompt? →
Was ist ein negativer Prompt?
Ein negativer Prompt sagt der KI, was sie NICHT zeigen soll. Typische Beispiele: 'blurry, low quality, watermark, text, deformed hands'. So vermeidest du typische KI-Fehler.
Negative Prompts verbessern die Bildqualität schnell. Füge Gewichte hinzu — z. B. '(blurry:1.4)' — um sie zu verstärken.
Was bedeutet 'Seed'?
Der Seed ist eine Zahl, die den Zufallsprozess der Bildgenerierung initialisiert. Jedes Bild beginnt aus Rauschen, und der Seed bestimmt, wie dieses Ausgangsrauschen aussieht. Lassen Sie ihn auf -1, um bei jeder Generierung einen zufälligen Seed — und ein anderes Bild — zu erhalten.
Fixieren Sie den Seed, um exakt dasselbe Bild zu reproduzieren. Dies ist nützlich für Experimente: Halten Sie den Seed konstant, während Sie nur den Prompt oder die Einstellungen ändern, um Variationen präzise zu vergleichen. So können Sie später auch ein Lieblingsergebnis neu erstellen.
Den ganzen Ratgeber lesen: Was macht der Seed in Stable Diffusion? →
Was ist eine LoRA?
LoRA steht für Low-Rank Adaptation. Es ist eine kleine Add-on-Datei (typischerweise 50–150 MB), die ein Basismodell für einen bestimmten Stil, eine Figur oder ein Motiv feinabstimmt — ohne das gesamte Modell neu zu trainieren.
Laden Sie ein LoRA, um Bilder in einem bestimmten Kunststil zu generieren, eine bestimmte Figur zu reproduzieren oder ein Referenzkonzept zu treffen. Sie können mehrere LoRAs in einem Prompt mit Gewichtungen kombinieren: <lora:my-style:0.8>. Tausende kostenlose LoRAs sind auf Civitai und Hugging Face verfügbar.
Den ganzen Ratgeber lesen: Was ist ein LoRA in Stable Diffusion? →
Wie installiert man Stable Diffusion lokal?
Die lokale Ausführung von Stable Diffusion erfordert eine aktuelle NVIDIA GPU mit mindestens 6 GB VRAM. AMD GPUs funktionieren mit ROCm-Treibern unter Linux. Apple Silicon (M1/M2/M3) wird über das MPS-Backend ebenfalls unterstützt. Wenn Sie keine kompatible GPU haben, läuft unser kostenloses Online-Tool direkt in Ihrem Browser — keine Installation erforderlich.
Lade zunächst das base model und das refiner von Stability AI herunter.Installiere dann Python 3.10 und Git.
Richte das webUI ein über Automatic1111.
Lege beide Modelle in den Ordner models/Stable-diffusion .
Startewebui.bat per Doppelklick.
Öffne deinen Browser unter localhost:7860.
Den ganzen Ratgeber lesen: Wie installiert man Stable Diffusion lokal? →
Wie viel VRAM brauche ich für Stable Diffusion?
Du brauchst mindestens 4 GB VRAM, um Stable Diffusion zu betreiben. 6 GB ist das empfohlene Minimum für SDXL-Modelle. Mit 8 GB oder mehr kannst du größere Bilder generieren und mehr Funktionen nutzen.
Ohne GPU kannst du Stable Diffusion noch auf der CPU nutzen — aber es ist viel langsamer. Du kannst auch unsere kostenlose Online-Demo ohne GPU verwenden.
Was ist img2img?
Img2img erlaubt es dir, ein vorhandenes Bild als Ausgangspunkt zu nutzen. Du gibst ein Quellbild und einen Prompt an. Stable Diffusion transformiert das Bild dann nach deinen Anweisungen.
Nutze es, um den Stil eines Fotos zu ändern, ein generiertes Bild zu verbessern oder eine grobe Skizze zu verfeinern. Die Denoising-Stärke steuert, wie stark die KI das Original verändert.
Darf ich Stable Diffusion Bilder kommerziell nutzen?
Das hängt vom Modell ab. Die Basis-Modelle von Stable Diffusion verwenden die CreativeML Open RAIL-M Lizenz. Diese erlaubt kommerzielle Nutzung, aber mit Einschränkungen — du darfst die Bilder nicht einsetzen, um Menschen zu schaden oder zu täuschen.
Prüfe immer die Lizenz des verwendeten Checkpoints. Manche Community-Modelle schränken die kommerzielle Nutzung ein. Wenn du KI-generierte Bilder verkaufst oder veröffentlichst, halte das Modell und seine Lizenz fest.
Was ist ControlNet?
ControlNet ist eine Erweiterung für Stable Diffusion, die dir präzise Kontrolle über die Bildkomposition gibt. Du gibst ein Referenzbild an — eine Pose, eine Kantenkarte oder eine Tiefenkarte — und die KI folgt dieser Struktur.
Nutze ControlNet, um die genaue Pose einer Person beizubehalten, ein Szenenlayout zu kopieren oder eine Skizze exakt nachzuzeichnen. Es arbeitet mit deinem Prompt zusammen und steuert Inhalt und Struktur des Bildes.
Was ist ein Checkpoint?
Ein Checkpoint ist eine gespeicherte KI-Modelldatei. Sie enthält alles, was das Modell während des Trainings gelernt hat. Du lädst einen Checkpoint, um den Stil und das Motiv deiner Bilder festzulegen.
Verschiedene Checkpoints liefern sehr unterschiedliche Ergebnisse. Manche sind für realistische Fotos trainiert, andere für Anime oder Illustration. Kostenlose Checkpoints kannst du von Hugging Face oder Civitai herunterladen.
Was ist ComfyUI?
ComfyUI ist eine kostenlose, knotenbasierte Oberfläche für Stable Diffusion. Du erstellst Bild-Workflows, indem du Blöcke verbindest, die Nodes heißen. Jeder Node macht einen Schritt — Modell laden, Prompt hinzufügen oder Bild speichern.
ComfyUI gibt dir volle Kontrolle über jeden Schritt. Es ist schneller und leichter als Automatic1111. Power-User bevorzugen es für komplexe Workflows. Du kannst Workflows als JSON-Dateien teilen.
Was ist Flux?
Flux ist eine Familie von Text-zu-Bild-Modellen von Black Forest Labs, gegründet von ehemaligen Stability AI-Forschern. Die neueste Version mit offenen Gewichten ist FLUX 3 Image Klein, veröffentlicht am 15. Oktober 2026: 5,6 Milliarden Parameter, native 4K-Generierung, Bearbeitung mit bis zu zehn Referenzbildern und eine int8-Variante, die auf einer Grafikkarte mit 8 GB läuft.
FLUX 3 Image Klein erscheint unter der FLUX Kommunity License: kostenlose kommerzielle Nutzung für Privatpersonen und Unternehmen unter 5 Millionen Dollar Jahresumsatz; größere Organisationen brauchen eine kommerzielle Lizenz von Black Forest Labs. FLUX.2, erschienen im November 2025, ist weiterhin aktuell in fünf Varianten: drei gehostete, [max], [pro] und [flex], und zwei mit offenen Gewichten, [dev] und [klein]. Die Demo dieser Website läuft mit FLUX.2 [dev], und die Kunststil-Seite wurde mit FLUX.2 [klein] gerendert.
Was ist Qwen-Image 2.1?
Qwen-Image 2.1 ist ein Text-zu-Bild- und Bildbearbeitungsmodell mit offenen Gewichten von Alibabas Qwen-Team, erschienen im September 2026. Es folgt ganzen Sätzen statt Stichwortlisten, schreibt lesbaren Text ins Bild und rendert natives 2K, 2048 × 2048 für ein Quadrat, ohne Hochskalierung. Zum Bearbeiten nimmt es einen Satz und bis zu zehn Referenzbilder.
Sie können es kostenlos in der Qwen-Image 2.1-Demo dieser Website ausprobieren, ohne Konto. Es läuft zu Hause in ComfyUI; die int8-Gewichte passen auf eine Grafikkarte mit 16 GB. Die Gewichte stehen unter der Qwen Research License: nur Forschung und Evaluation, und jede kommerzielle Nutzung braucht eine separate Lizenz von Qwen. Das erste Qwen-Image, veröffentlicht im August 2025, war Apache 2.0.
Den ganzen Ratgeber lesen: Was Qwen-Image ist, was es kann und wie es funktioniert →
Was ist die neueste Version von Stable Diffusion?
Die neueste Version ist Stable Diffusion 3.5 , erschienen im Oktober 2024. Es erzeugt schärfere Bilder mit deutlich besserem Textrendering, reicheren Farben und verbesserten Feindetails. Es gibt drei Größen: Large (8 Milliarden Parameter), Large Turbo für schnelle Generierung und Medium — alle lokal mit moderatem VRAM ausführbar.
Den ganzen Ratgeber lesen: SDXL vs Stable Diffusion 3 vs SD 1.5: welches sollten Sie nutzen? →