Was ist Qwen-Image, kurz gesagt
Qwen-Image ist die Bildgenerierungs-Linie von Qwen, der Modellfamilie von Alibabas Cloud-Sparte. Es erschien im August 2025 als Modell mit 20 Milliarden Parametern unter der Apache-2.0-Lizenz, mit einem technischen Bericht. Aufgefallen ist es durch seinen Text. Absätze, Schilder und Etiketten kamen lesbar heraus, auf Englisch und vor allem auf Chinesisch, wo Stable Diffusion 1.5 und SDXL Gekrakel produzierten und die Modelle von 2024 bestenfalls ein paar englische Wörter schafften.
Die aktuelle offene Version ist Qwen-Image 2.1, veröffentlicht am 20. September 2026. Es ist ein kleineres und schnelleres Modell: 7 Milliarden Parameter für den Bildgenerator plus ein Vision-Language-Encoder mit 8 Milliarden Parametern. Ein Checkpoint erledigt zwei Aufgaben. Er erzeugt ein Bild aus Text, und er bearbeitet ein vorhandenes Bild anhand eines Satzes und bis zu zehn Referenzbildern. Er liefert natives 2K und echte transparente Bilder. Die Lizenz ist nicht mehr Apache: nur noch Forschung und Evaluation.
Wie Stable Diffusion und FLUX ist es ein Diffusionsmodell, das in ComfyUI auf einer Consumer-Grafikkarte läuft, und es liest dieselbe Art von Prompt. Der Unterschied steckt im Inneren, und genau den erklärt der Abschnitt zur Funktionsweise.
Was Qwen-Image 2.1 kann
Text-zu-Bild in nativem 2K. Das Modell rendert Quadrate mit 2048 × 2048, 2528 × 1696 in 3:2 und 2752 × 1536 in 16:9 direkt, ohne Upscaler. Es liest den Prompt als Text, also funktionieren Sätze, Präpositionen und Layout-Anweisungen, und Wörter in Anführungszeichen erscheinen wie geschrieben: „a banner above the door reads ‘OPEN ALL NIGHT’“ kommt in den Testprompts des Einstellungs-Guides genau so heraus. Der Guide zu den Einstellungen zeigt den Prompt-Aufbau, der am besten funktioniert, und die gemessenen Einstellungen.
Bearbeiten mit demselben Checkpoint. Geben Sie ihm ein Bild und einen Satz, und es verändert das Bild: ein Objekt ersetzen, eine Szene umstylen, Text hinzufügen. Geben Sie ihm bis zu zehn Referenzbilder, und es setzt sie zusammen, wobei eine Figur oder ein Produkt über mehrere Aufnahmen hinweg gleich bleibt. Bereiche lassen sich mit einer Maske oder einem gezeichneten Kreis markieren. Für lokale Änderungen braucht es keinen separaten Inpainting-Checkpoint: Dasselbe Modell nimmt den Bereich als Hinweis.
Transparente Ausgabe. Verlangen Sie ein RGBA-Bild mit transparentem Hintergrund, und das Modell erzeugt einen echten Alphakanal, keinen Freisteller: Die VAE kodiert und dekodiert vier Pixelkanäle statt drei. Logos, Sticker und Assets für Ebenen kommen fertig zum Platzieren heraus.
Prompt-Umschreibung. Qwen liefert zwei Begleitmodelle mit, Fine-Tunes von Qwen3.5-VL 9B, die einen kurzen Prompt zu der ausführlichen Form erweitern, die der Generator bevorzugt, eines fürs Erzeugen und eines fürs Bearbeiten. ComfyUI bietet sie in seinen Templates als Option an, standardmäßig aus; nötig sind sie nicht.
Geschwindigkeit. Auf einer 16-GB-Consumer-Karte brauchen die int8-Gewichte etwa 40 Sekunden für ein 1-Megapixel-Bild und vier bis fünf Minuten für 4 Megapixel mit den Qualitätseinstellungen des Einstellungs-Guides. Ein destillierter Turbo-Checkpoint, veröffentlicht am 9. Oktober 2026, rendert in 8 Schritten, etwa siebenmal schneller bei 4 Megapixeln, auf Kosten des Mediums: Zeichnungen, Stickereien und Scherenschnitte driften in Richtung Fotografie.
Qwen-Image vs. Stable Diffusion: Wie es funktioniert
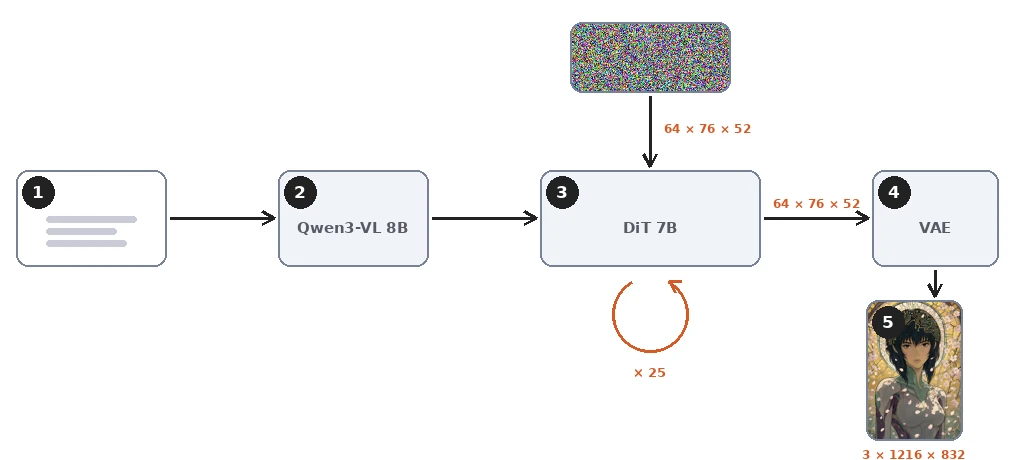
Qwen-Image 2.1 ist ein Diffusionsmodell, die im Stable-Diffusion-Guide erklärte Mechanik gilt also auch hier. Ein Text-Encoder liest den Prompt. Ein Entrauscher arbeitet über eine Reihe von Schritten auf einem komprimierten Latent. Ein Decoder macht aus dem Latent Pixel. Was sich unterscheidet, ist die Wahl für jeden der drei Teile. Das Repository des Modells liefert die Fakten unten; einen technischen Bericht zu 2.1 hat Qwen nicht veröffentlicht.
Ein Vision-Language-Modell statt CLIP
Stable Diffusion 1.5 und SDXL lesen den Prompt mit CLIP, einem Netz, das darauf trainiert wurde, kurze Bildunterschriften Bildern zuzuordnen. Qwen-Image 2.1 liest ihn mit Qwen3-VL 8B, einem vollständigen Vision-Language-Modell mit acht Milliarden Parametern, mehr als der Bildgenerator selbst. Derselbe Encoder liest beim Bearbeiten die Referenzbilder. Deshalb funktioniert der Prompt-Aufbau des Einstellungs-Guides. Sätze, Präpositionen, Text in Anführungszeichen und Layout-Anweisungen sind genau das, wofür ein Sprachmodell gebaut ist. Ein CLIP-Encoder drückt sie eher zu einem Sack voller Konzepte zusammen.
Ein Single-Stream-Transformer statt eines U-Net
Der Entrauscher ist ein Diffusions-Transformer mit 32 Schichten und 7 Milliarden Parametern. SDXL verwendet ein U-Net, Faltungsblöcke mit Attention-Schichten dazwischen. Stable Diffusion 3 ist ebenfalls zu einem Transformer übergegangen, dem MMDiT, in dem Text- und Bild-Tokens in zwei Strömen mit getrennten Gewichten laufen und sich nur in der Attention jeder Schicht treffen. Qwen-Image 2.1 geht einen Schritt weiter: Text- und Bild-Tokens bilden eine einzige Sequenz und durchlaufen dieselben Gewichte, das ist mit „Single-Stream“ gemeint. Das erste Qwen-Image von 2025 war ein Double-Stream-MMDiT mit 20 Milliarden Parametern; 2.1 hat etwa ein Drittel dieser Größe.
Zwei Details seiner Attention sind in der Praxis wichtig. Text-Tokens werden kausal gelesen, wie in einem Sprachmodell, und jedes Bild, ob Referenz oder erzeugt, ist ein Block, dessen Tokens sich alle gegenseitig sehen. Die Reihenfolge: zuerst der Prompt, dann die Referenzbilder, zuletzt das erzeugte Bild, und ein Token schaut nie auf das, was nach ihm kommt. Der Prompt und die Referenzbilder sehen das entstehende Bild also nie, und der Teil der Berechnung, der zu ihnen gehört, der Präfix, ist in jedem Schritt identisch: Er wird einmal berechnet und über die Denoising-Schritte hinweg gecacht. Der Knoten QwenImage21Cache in ComfyUI legt nur fest, wo dieser Cache liegt, in welcher Präzision, oder ob er überhaupt genutzt wird.
Ein 64-Kanal-Latent, sechzehnfach komprimiert
Die VAE von Stable Diffusion verkleinert ein Bild um den Faktor acht pro Seite in 4 Kanäle, 16 in Version 3. Die VAE von Qwen-Image 2.1 verkleinert es um den Faktor sechzehn pro Seite, in 64 Kanäle. Sie kodiert und dekodiert außerdem vier Pixelkanäle, Rot, Grün, Blau und Alpha, statt drei, und so gibt das Modell aus demselben 64-Kanal-Latent echte RGBA-Bilder aus. Für ein Bild mit 832 × 1216 misst das Latent 64 Kanäle von 52 × 76: etwa 253.000 Zahlen für 3 Millionen Pixelwerte, zwölfmal weniger.
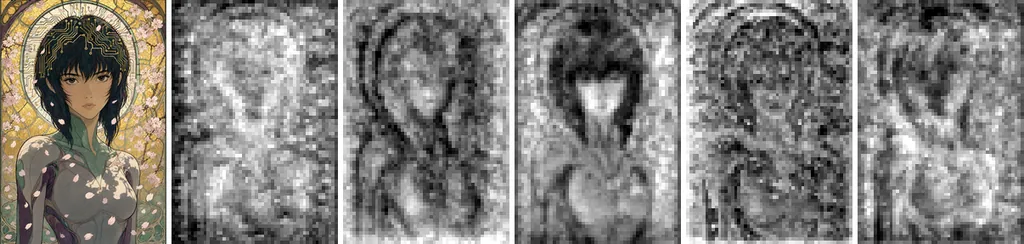
Jede Latent-Position ist ein Token für den Transformer, ein 1-Megapixel-Bild sind also 3.952 Tokens und ein 4-Megapixel-Bild 15.808. Dieses Raster ist nicht gröber als das von Stable Diffusion 3 oder dem ersten Qwen-Image, die ihr 8-fach komprimiertes Latent vor dem Transformer zu 2 × 2 Patches zusammenfassen. Was 2.1 ändert: Die VAE übernimmt dieses Zusammenfassen selbst, in 64 Kanälen. Die Kosten der Attention wachsen mit dem Quadrat der Token-Zahl, und deshalb kosten 4 Megapixel weit mehr als viermal 1 Megapixel.
Flow Matching statt Rauschvorhersage
Stable Diffusion 1.5 und SDXL wurden darauf trainiert, das einem Bild hinzugefügte Rauschen vorherzusagen. Qwen-Image wird wie Stable Diffusion 3 und FLUX mit Flow Matching trainiert. Das Netz sagt die Richtung vom verrauschten Latent zum sauberen voraus, entlang einer geraden Linie. Der Sampler folgt dieser Richtung dann mit Euler-Schritten. Das Repository nennt diesen Scheduler: Flow Matching mit diskreten Euler-Schritten und einem dynamischen Shift. Der erste Qwen-Image-Bericht beschreibt das Trainingsziel, eine Zielgeschwindigkeit entlang gerader Pfade, und der Scheduler von 2.1 lässt darauf schließen, dass es unverändert ist.
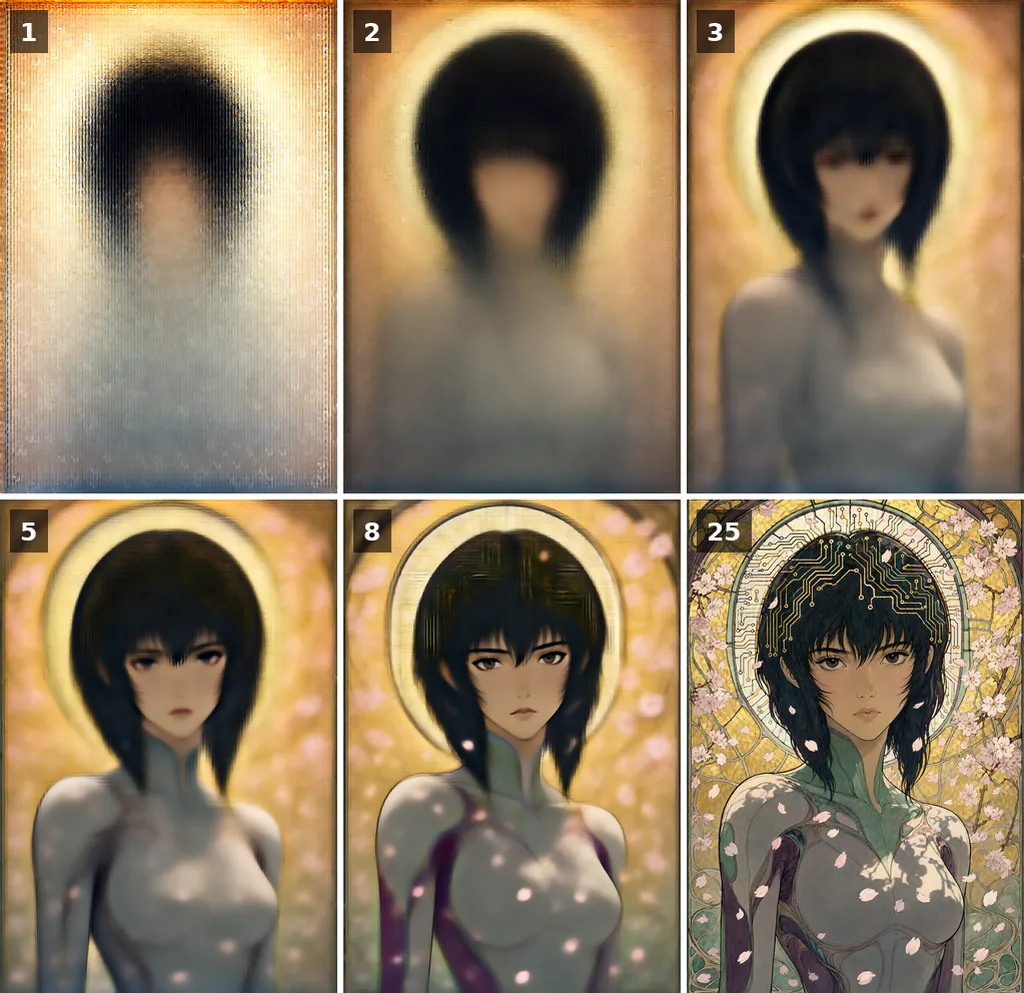
Die Abbildung unten zeigt, wie die Schätzung des Modells für das fertige Bild unterwegs aussieht. Die Komposition steht in den ersten Schritten fest, die Details kommen später. Diese Reihenfolge von grob nach fein ist allen Diffusionsmodellen gemeinsam; Flow Matching ändert vor allem, wie die Schritte verteilt sind, und genau das stellt der dynamische Shift ein.
Nebeneinander
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Text-Encoder | CLIP ViT-L und OpenCLIP bigG | Zwei CLIP-Encoder und T5-XXL | Qwen3-VL 8B, ein Vision-Language-Modell |
| Entrauscher | U-Net, 2,6 Milliarden Parameter | Double-Stream-MMDiT, 8 Milliarden | Single-Stream-Diffusions-Transformer, 7 Milliarden, 32 Schichten |
| Latent | 4 Kanäle, 8× Kompression | 16 Kanäle, 8× | 64 Kanäle, 16×, mit Alpha |
| Trainingsziel | Rauschvorhersage | Flow Matching (Rectified Flow) | Flow Matching (Rectified Flow) |
| Native Größe | 1024 px | 1024 px | 2048 px |
| Bearbeiten | Inpainting-Modell von Dritten | Kein offizielles Bearbeitungsmodell, nur ControlNets | Derselbe Checkpoint, bis zu 10 Referenzbilder |
| Lizenz | OpenRAIL++-M | Community License | Qwen Research License |
Nichts davon ändert, wie man das Modell steuert. Guidance, Schritte, Seed und Größe verhalten sich wie bei jedem Diffusionsmodell; nur die Werte, die am besten funktionieren, sind andere, und der Einstellungs-Guide misst sie.
Die Versionen, von Qwen-Image bis 2.1
Die Nummerierung ist verwirrend, weil sie der Architektur folgt, nicht dem Veröffentlichungsweg. Qwen-Image 2.0, im Februar 2026 angekündigt und nie als Gewichte veröffentlicht, führte das leichtere Design ein, das 2.1 jetzt offen ausliefert. Qwen-Image 3.0, im Juli 2026 angekündigt, ist ein größeres Flaggschiff, das nur über Alibabas API bereitsteht. Qwen hat das Schema nicht erklärt; die Daten unten stammen aus den Repositories des Projekts und, für 3.0, aus Qwens Ankündigung.
| Version | Datum | Was es ist | Gewichte |
|---|---|---|---|
| Qwen-Image | 4. August 2025 | Double-Stream-MMDiT mit 20 Milliarden Parametern und einem Qwen2.5-VL-7B-Encoder; Text-zu-Bild | Offen, Apache 2.0 |
| Qwen-Image-Edit, dann Edit-2509 und Edit-2511 | August bis Dezember 2025 | Bearbeitungsmodelle auf derselben Basis; mehrere Referenzbilder ab 2509; ein Modell mit RGBA-Ebenen, Qwen-Image-Layered, im Dezember | Offen, Apache 2.0 |
| Qwen-Image-2512 | 31. Dezember 2025 | Letzte Text-zu-Bild-Version der 20-Milliarden-Linie | Offen, Apache 2.0 |
| Qwen-Image 2.0 | 10. Februar 2026 | Das Design, das 2.1 erbt: Qwen3-VL-Encoder, 64-Kanal-VAE, natives 2K, Anweisungen bis 1.000 Tokens; technischer Bericht im Mai 2026 | Nicht veröffentlicht |
| Qwen-Image 3.0 | 21. Juli 2026 | Flaggschiff hinter Alibabas API: Prompts bis 4.500 Tokens, Infografiken und Storyboards in einem Durchgang | Nur API |
| Qwen-Image 2.1 | 20. September 2026 | Single-Stream-Transformer mit 7 Milliarden Parametern und einem Qwen3-VL-8B-Encoder; Erzeugen und Bearbeiten in einem Checkpoint, RGBA, 2K | Offen, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9. Oktober 2026 | Destilliertes 2.1, 8 Schritte | Offen, Qwen Research License |
Auf einer Download-Seite ist „Qwen-Image“ ohne Nummer also das 20-Milliarden-Modell von 2025, weiterhin verfügbar mit seinen Updates 2512 und Edit. Das aktuelle offene Modell ist 2.1, und 3.0 ist das Modell hinter Alibabas Bezahldienst. 2.1 und 3.0 teilen eine Abstammung, aber nicht ihre Gewichte.
Die Qwen-Image-Lizenz: offene Gewichte, nur für Forschung
Das erste Qwen-Image und seine Bearbeitungsmodelle standen unter Apache 2.0: frei für alles, kommerzielle Nutzung eingeschlossen. Qwen-Image 2.1 und sein Turbo stehen unter dem Qwen Research License Agreement. Die Gewichte dürfen heruntergeladen, untersucht, ausgeführt und feingetunt werden, aber nur für Forschung und Evaluation. Jede kommerzielle Nutzung braucht eine separate Lizenz von Qwen.
Damit steht 2.1 anders da als Stable Diffusion, dessen Lizenzen für 1.5 und SDXL die kommerzielle Nutzung mit einer Liste verbotener Verwendungen erlauben und dessen 3.5-Lizenz sie unterhalb von einer Million Dollar Jahresumsatz erlaubt, und anders als FLUX 3 Klein, kommerziell frei unterhalb von fünf Millionen. Für Studierende oder ein Labor ändert sich nichts. Für ein Studio bleiben die kostenpflichtige API oder eine bei Qwen beantragte kommerzielle Lizenz die offenen Wege.
Qwen-Image ausprobieren und weitergehen
Der schnellste Weg ist die kostenlose Qwen-Image-2.1-Seite dieser Website: kein Konto, Erzeugen und Bearbeiten mit Referenzbildern, die Warteschlange live angezeigt.
Um es zu Hause auszuführen: ComfyUI unterstützt das Modell nativ. Drei Dateien aus dem Comfy-Org-Repackaging kommen in die üblichen Ordner: das Diffusionsmodell, der Qwen3-VL-Text-Encoder und die VAE, als int8-Versionen für eine 16-GB-Karte. Der Guide zu den Einstellungen behandelt den Graphen, den Prompt-Aufbau, die Guidance und die Größen, die auf genau dieser Karte gemessen wurden, dazu das Turbo und das Turbo mit Guidance.
Für die Grundlagen, die all diese Modelle teilen, Rauschen, latenter Raum, Guidance und Seed, lesen Sie Was ist Stable Diffusion?; die Erklärungen gelten weiter, nur die Zahlen ändern sich.