מה זה Qwen-Image, בקצרה
Qwen-Image הוא קו יצירת התמונות של Qwen, משפחת המודלים של חטיבת הענן של Alibaba. הוא הגיע באוגוסט 2025 כמודל של 20 מיליארד פרמטרים תחת רישיון Apache 2.0, עם דוח טכני. הוא בלט בטקסט. פסקאות, שלטים ותוויות יצאו קריאים, באנגלית ובעיקר בסינית, שבה Stable Diffusion 1.5 ו-SDXL הפיקו שרבוטים והמודלים של 2024 הסתדרו לכל היותר עם כמה מילים באנגלית.
הגרסה הפתוחה הנוכחית היא Qwen-Image 2.1, שפורסמה ב-20 בספטמבר 2026. זהו מודל קטן ומהיר יותר: 7 מיליארד פרמטרים למחולל התמונות, ועוד מקודד ראייה-שפה של 8 מיליארד פרמטרים. checkpoint אחד עושה שתי עבודות. הוא יוצר תמונה מטקסט, והוא עורך תמונה קיימת לפי משפט ועד עשר תמונות ייחוס. הוא מוציא 2K מקורי ותמונות שקופות אמיתיות. הרישיון שלו כבר אינו Apache: מחקר והערכה בלבד.
כמו Stable Diffusion ו-FLUX, זהו מודל דיפוזיה שרץ ב-ComfyUI על כרטיס מסך ביתי, והוא קורא אותו סוג של פרומפט. ההבדל הוא בפנים, וזה מה שהסעיף על איך זה עובד מסביר.
מה Qwen-Image 2.1 יודע לעשות
טקסט לתמונה ב-2K מקורי. המודל מרנדר ריבועים של 2048 × 2048, 2528 × 1696 ב-3:2 ו-2752 × 1536 ב-16:9 ישירות, בלי upscaler. הוא קורא את הפרומפט כטקסט, ולכן משפטים, מילות יחס והוראות פריסה עובדים, ומילים במירכאות מופיעות כפי שנכתבו: “a banner above the door reads ‘OPEN ALL NIGHT’” יוצא בדיוק כך בפרומפטי הבדיקה של מדריך ההגדרות. מדריך ההגדרות נותן את מבנה הפרומפט שעובד הכי טוב ואת ההגדרות שנמדדו.
עריכה עם אותו checkpoint. תנו לו תמונה ומשפט והוא משנה את התמונה: מחליף אובייקט, משנה סגנון של סצנה, מוסיף טקסט. תנו לו עד עשר תמונות ייחוס והוא מרכיב אותן, ושומר על דמות או מוצר עקביים בין צילומים. אפשר להצביע על אזורים עם מסכה או עיגול מצויר. לא צריך checkpoint נפרד ל-inpainting בשביל עריכות מקומיות: אותו מודל לוקח את האזור כרמז.
פלט שקוף. בקשו תמונת RGBA עם רקע שקוף והמודל מפיק ערוץ אלפא אמיתי, לא גזירה: ה-VAE מקודד ומפענח ארבעה ערוצי פיקסל במקום שלושה. לוגואים, מדבקות ונכסים בשכבות יוצאים מוכנים להצבה.
שכתוב פרומפט. Qwen מספקת שני מודלים נלווים, fine-tunes של Qwen3.5-VL 9B, שמרחיבים פרומפט קצר לצורה המפורטת שהמחולל מעדיף, אחד ליצירה ואחד לעריכה. ComfyUI מציע אותם כאפשרות בתבניות שלו, כבויה כברירת מחדל; הם לא הכרחיים.
מהירות. על כרטיס ביתי של 16 GB, משקולות ה-int8 לוקחות כ-40 שניות לתמונה של 1 מגה-פיקסל וארבע עד חמש דקות ל-4 מגה-פיקסל בהגדרות האיכות של מדריך ההגדרות. checkpoint Turbo מזוקק, ששוחרר ב-9 באוקטובר 2026, מרנדר ב-8 צעדים, מהר פי שבעה בערך ב-4 מגה-פיקסל, במחיר המדיום: רישומים, רקמה ונייר גזור נסחפים לכיוון צילומים.
Qwen-Image מול Stable Diffusion: איך זה עובד
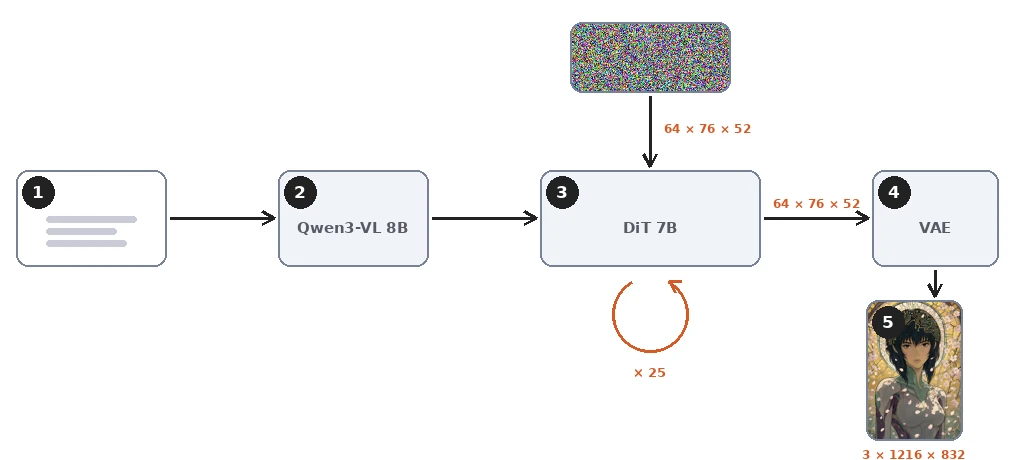
Qwen-Image 2.1 הוא מודל דיפוזיה, ולכן המכניקה שמוסברת במדריך Stable Diffusion חלה עליו. מקודד טקסט קורא את הפרומפט. denoiser עובד על latent דחוס לאורך מספר צעדים. מפענח הופך את ה-latent לפיקסלים. מה ששונה הוא הבחירה שנעשתה בכל אחד משלושת החלקים. המאגר של המודל נותן את העובדות שלמטה; Qwen לא פרסמה דוח טכני ל-2.1.
מודל ראייה-שפה במקום CLIP
Stable Diffusion 1.5 ו-SDXL קוראים את הפרומפט עם CLIP, רשת שאומנה להתאים כיתובים קצרים לתמונות. Qwen-Image 2.1 קורא אותו עם Qwen3-VL 8B, מודל ראייה-שפה מלא של שמונה מיליארד פרמטרים, יותר ממחולל התמונות עצמו. אותו מקודד קורא את תמונות הייחוס בעריכה. זו הסיבה שמבנה הפרומפט של מדריך ההגדרות עובד. משפטים, מילות יחס, טקסט במירכאות והוראות פריסה הם בדיוק מה שמודל שפה בנוי לנתח. מקודד CLIP נוטה לשטח אותם לערימה של מושגים.
טרנספורמר בזרם יחיד במקום U-Net
ה-denoiser הוא diffusion transformer של 32 שכבות ו-7 מיליארד פרמטרים. SDXL משתמש ב-U-Net, בלוקי קונבולוציה עם שכבות קשב ביניהם. גם Stable Diffusion 3 עבר לטרנספורמר, ה-MMDiT, שבו טוקני הטקסט וטוקני התמונה נעים בשני זרמים עם משקולות נפרדות ונפגשים רק בקשב של כל שכבה. Qwen-Image 2.1 הולך צעד אחד הלאה: טוקני הטקסט והתמונה יוצרים רצף אחד ועוברים דרך אותן משקולות, וזה מה ש"זרם יחיד" אומר. ה-Qwen-Image הראשון של 2025 היה MMDiT בשני זרמים של 20 מיליארד פרמטרים; 2.1 הוא בערך שליש מהגודל הזה.
שני פרטים בקשב שלו חשובים בפועל. טוקני הטקסט נקראים באופן סיבתי, כמו במודל שפה, וכל תמונה, ייחוס או מיוצרת, היא בלוק אחד שכל הטוקנים שלו רואים זה את זה. הסדר הוא פרומפט קודם, תמונות ייחוס אחריו, התמונה המיוצרת אחרונה, וטוקן אף פעם לא מסתכל על מה שבא אחריו. כך הפרומפט ותמונות הייחוס אף פעם לא רואים את התמונה שנוצרת, וחלק החישוב ששייך להם, הקידומת, זהה בכל צעד: הוא מחושב פעם אחת ונשמר במטמון לאורך צעדי הסרת הרעש. הצומת QwenImage21Cache של ComfyUI רק בוחר איפה המטמון הזה יושב, באיזה דיוק, או אם משתמשים בו בכלל.
latent של 64 ערוצים, דחוס פי שש-עשרה
ה-VAE של Stable Diffusion מכווץ תמונה בפקטור שמונה בכל ציר ל-4 ערוצים, 16 בגרסה 3. ה-VAE של Qwen-Image 2.1 מכווץ אותה פי שש-עשרה בכל ציר, ל-64 ערוצים. הוא גם מקודד ומפענח ארבעה ערוצי פיקסל, אדום, ירוק, כחול ואלפא, במקום שלושה, וכך המודל מוציא תמונות RGBA אמיתיות מאותו latent של 64 ערוצים. לתמונה של 832 × 1216 ה-latent מודד 64 ערוצים של 52 × 76: כ-253,000 מספרים עבור 3 מיליון ערכי פיקסל, פי שנים-עשר פחות.
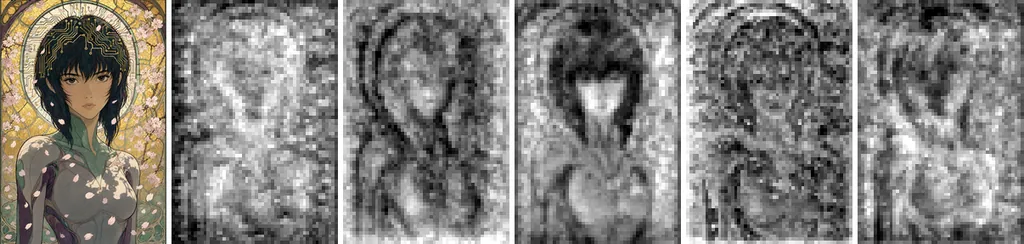
כל מיקום ב-latent הוא טוקן אחד לטרנספורמר, כך שתמונה של 1 מגה-פיקסל היא 3,952 טוקנים ותמונה של 4 מגה-פיקסל 15,808. הרשת הזאת לא גסה יותר מזו של Stable Diffusion 3 או של ה-Qwen-Image הראשון, שמקבצים את ה-latent שלהם, הדחוס פי 8, לריבועים של 2 × 2 לפני הטרנספורמר. מה ש-2.1 משנה הוא שה-VAE עושה את הקיבוץ הזה בעצמו, ב-64 ערוצים. עלות הקשב גדלה עם ריבוע מספר הטוקנים, ולכן 4 מגה-פיקסל עולים הרבה יותר מפי ארבעה מ-1 מגה-פיקסל.
flow matching במקום ניבוי רעש
Stable Diffusion 1.5 ו-SDXL אומנו לנבא את הרעש שנוסף לתמונה. Qwen-Image, כמו Stable Diffusion 3 ו-FLUX, מאומן עם flow matching. הרשת מנבאת את הכיוון מה-latent הרועש אל הנקי, לאורך קו ישר. ה-sampler עוקב אחרי הכיוון הזה בצעדי Euler. המאגר מציין את ה-scheduler הזה בשמו: flow matching עם צעדי Euler בדידים ו-shift דינמי. הדוח של ה-Qwen-Image הראשון מתאר את המטרה, יעד מהירות לאורך מסלולים ישרים, וה-scheduler של 2.1 מרמז שהיא לא השתנתה.
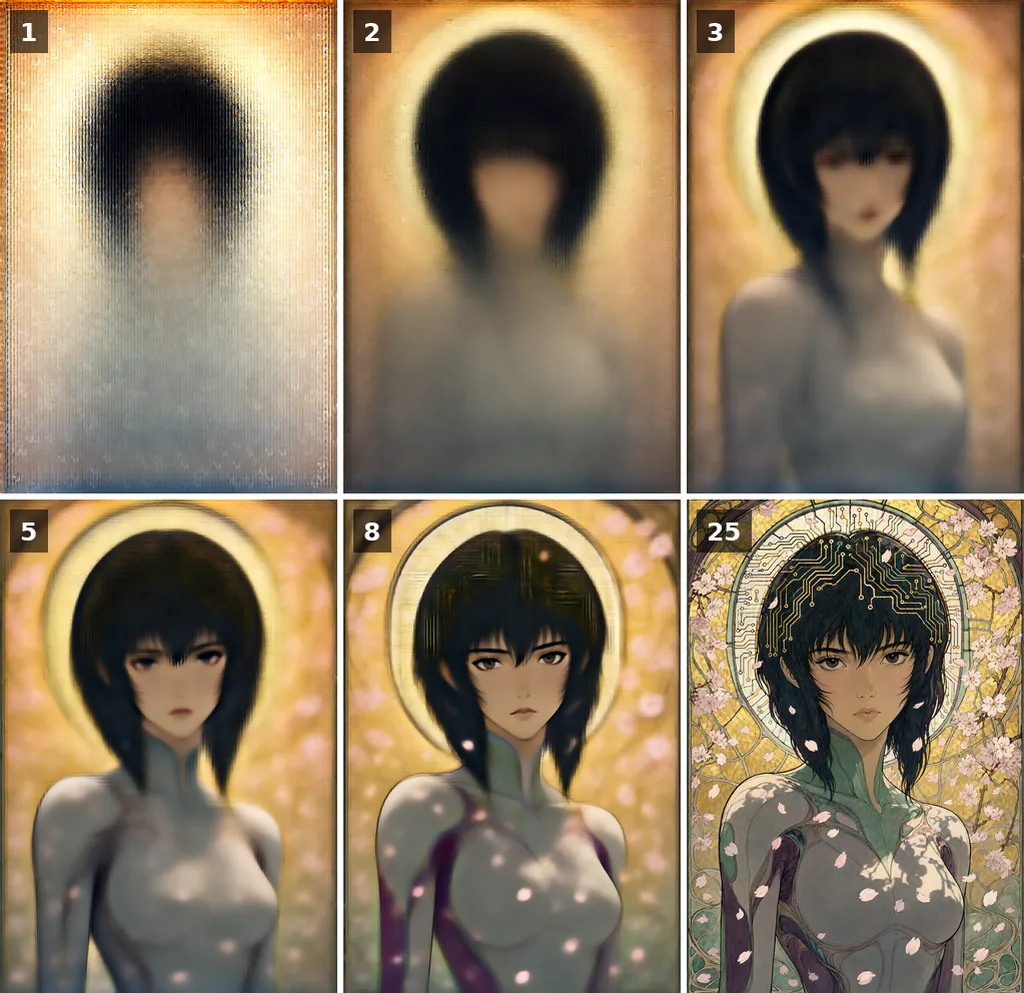
האיור שלמטה מראה איך נראית הערכת המודל לתמונה המוגמרת לאורך הדרך. הקומפוזיציה נקבעת בצעדים הראשונים והפרטים מגיעים אחר כך. הסדר הזה, מהגס אל העדין, משותף לכל מודלי הדיפוזיה; flow matching משנה בעיקר את המרווחים בין הצעדים, וזה מה שה-shift הדינמי מכוונן.
זה לצד זה
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| מקודד טקסט | CLIP ViT-L ו-OpenCLIP bigG | שני מקודדי CLIP ו-T5-XXL | Qwen3-VL 8B, מודל ראייה-שפה |
| Denoiser | U-Net, 2.6 מיליארד פרמטרים | MMDiT בשני זרמים, 8 מיליארד | diffusion transformer בזרם יחיד, 7 מיליארד, 32 שכבות |
| Latent | 4 ערוצים, דחיסה 8× | 16 ערוצים, 8× | 64 ערוצים, 16×, עם אלפא |
| יעד האימון | ניבוי רעש | Flow matching (rectified flow) | Flow matching (rectified flow) |
| גודל מקורי | 1024 px | 1024 px | 2048 px |
| עריכה | מודל inpainting של צד שלישי | אין מודל עריכה רשמי, רק ControlNets | אותו checkpoint, עד 10 תמונות ייחוס |
| רישיון | OpenRAIL++-M | Community License | Qwen Research License |
שום דבר מזה לא משנה את האופן שבו מפעילים את המודל. Guidance, צעדים, seed וגודל מתנהגים כמו בכל מודל דיפוזיה; רק המספרים שעובדים הכי טוב שונים, ומדריך ההגדרות מודד אותם.
הגרסאות, מ-Qwen-Image ועד 2.1
המספור מבלבל כי הוא עוקב אחרי הארכיטקטורה, לא אחרי ערוץ השחרור. Qwen-Image 2.0, שהוכרז בפברואר 2026 ומעולם לא שוחרר כמשקולות, הציג את העיצוב הקל יותר ש-2.1 מספק עכשיו בפתוח. Qwen-Image 3.0, שהוכרז ביולי 2026, הוא ספינת דגל גדולה יותר שמוגשת רק דרך ה-API של Alibaba. Qwen לא הסבירה את השיטה; התאריכים שלמטה לקוחים ממאגרי הפרויקט, ולגבי 3.0, מההכרזה של Qwen.
| גרסה | תאריך | מה זה | משקולות |
|---|---|---|---|
| Qwen-Image | 4 באוגוסט 2025 | MMDiT בשני זרמים של 20 מיליארד פרמטרים עם מקודד Qwen2.5-VL 7B; טקסט לתמונה | פתוחות, Apache 2.0 |
| Qwen-Image-Edit, ואז Edit-2509 ו-Edit-2511 | אוגוסט עד דצמבר 2025 | מודלי עריכה על אותו בסיס; כמה תמונות ייחוס החל מ-2509; מודל RGBA בשכבות, Qwen-Image-Layered, בדצמבר | פתוחות, Apache 2.0 |
| Qwen-Image-2512 | 31 בדצמבר 2025 | השחרור האחרון של טקסט לתמונה בקו ה-20 מיליארד | פתוחות, Apache 2.0 |
| Qwen-Image 2.0 | 10 בפברואר 2026 | העיצוב ש-2.1 יורש: מקודד Qwen3-VL, VAE של 64 ערוצים, 2K מקורי, הוראות עד 1,000 טוקנים; דוח טכני במאי 2026 | לא פורסמו |
| Qwen-Image 3.0 | 21 ביולי 2026 | ספינת הדגל מאחורי ה-API של Alibaba: פרומפטים עד 4,500 טוקנים, אינפוגרפיקות וסטוריבורדים שמרונדרים במעבר אחד | API בלבד |
| Qwen-Image 2.1 | 20 בספטמבר 2026 | טרנספורמר בזרם יחיד של 7 מיליארד פרמטרים עם מקודד Qwen3-VL 8B; יצירה ועריכה ב-checkpoint אחד, RGBA, 2K | פתוחות, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 באוקטובר 2026 | 2.1 מזוקק, 8 צעדים | פתוחות, Qwen Research License |
אז בדף הורדה, "Qwen-Image" בלי מספר הוא המודל של 20 מיליארד מ-2025, שעדיין זמין עם עדכוני 2512 ו-Edit שלו. המודל הפתוח הנוכחי הוא 2.1, ו-3.0 הוא המודל מאחורי השירות בתשלום של Alibaba. 2.1 ו-3.0 חולקים שושלת אבל לא משקולות.
הרישיון של Qwen-Image: משקולות פתוחות, למחקר בלבד
ה-Qwen-Image הראשון ומודלי העריכה שלו היו Apache 2.0: חופשיים לכל דבר, כולל שימוש מסחרי. Qwen-Image 2.1 וה-Turbo שלו נמצאים תחת Qwen Research License Agreement. אפשר להוריד את המשקולות, ללמוד אותן, להריץ אותן ולעשות להן fine-tune, אבל למחקר ולהערכה בלבד. כל שימוש מסחרי דורש רישיון נפרד מ-Qwen.
זה מציב את 2.1 במקום אחר מ-Stable Diffusion, שרישיונות 1.5 ו-SDXL שלו מתירים שימוש מסחרי עם רשימת שימושים אסורים ורישיון 3.5 שלו מתיר אותו מתחת למיליון דולר הכנסה שנתית, ומ-FLUX 3 Klein, חופשי לשימוש מסחרי מתחת לחמישה מיליון. לסטודנט או למעבדה שום דבר לא משתנה. לסטודיו, ה-API בתשלום או רישיון מסחרי שמבקשים מ-Qwen הם הדרכים שנשארות פתוחות.
לנסות את Qwen-Image ולהמשיך הלאה
הדרך המהירה ביותר היא דף Qwen-Image 2.1 החינמי של האתר הזה: בלי חשבון, יצירה ועריכה עם תמונות ייחוס, והתור מוצג בזמן אמת.
כדי להריץ אותו בבית, ComfyUI תומך במודל באופן מובנה. שלושה קבצים מהאריזה מחדש של Comfy-Org נכנסים לתיקיות הרגילות: מודל הדיפוזיה, מקודד הטקסט Qwen3-VL וה-VAE, בגרסאות int8 לכרטיס של 16 GB. מדריך ההגדרות מכסה את הגרף, את מבנה הפרומפט, את ה-guidance ואת הגדלים שנמדדו בדיוק על הכרטיס הזה, ועוד את ה-Turbo ואת ה-Turbo המונחה.
לעקרונות המשותפים לכל המודלים האלה, רעש, מרחב לטנטי, guidance ו-seed, קראו את מה זה Stable Diffusion?; ההסברים תקפים גם כאן, רק המספרים משתנים.