ما هو Qwen-Image باختصار
Qwen-Image هو خط توليد الصور في Qwen، عائلة النماذج التابعة للقسم السحابي في علي بابا. ظهر في أغسطس 2025 كنموذج بـ 20 مليار معامل تحت رخصة Apache 2.0، مع تقرير تقني. وتميّز بالنص. فالفقرات واللافتات والملصقات خرجت مقروءة، بالإنجليزية وبالصينية خصوصًا، حيث كان Stable Diffusion 1.5 وSDXL ينتجان خربشات، وكانت نماذج 2024 تنجح في بضع كلمات إنجليزية على الأكثر.
الإصدار المفتوح الحالي هو Qwen-Image 2.1، الصادر في 20 سبتمبر 2026. وهو نموذج أصغر وأسرع: 7 مليارات معامل لمولّد الصور، إضافة إلى مشفّر رؤية ولغة بـ 8 مليارات معامل. نقطة تحقق واحدة لمهمتين. فهو يولّد صورة من نص، ويعدّل صورة موجودة انطلاقًا من جملة وحتى عشر صور مرجعية. ويُخرج دقة 2K أصلية وصورًا شفافة حقيقية. أما رخصته فلم تعد Apache: البحث والتقييم فقط.
مثل Stable Diffusion وFLUX، هو نموذج انتشار يعمل في ComfyUI على بطاقة رسومات استهلاكية، ويقرأ النوع نفسه من البرومبت. والاختلاف في الداخل، وهو ما يشرحه قسم كيف يعمل.
ما الذي يستطيع Qwen-Image 2.1 فعله
من النص إلى الصورة بدقة 2K أصلية. يرسم النموذج مربعات 2048 × 2048، و2528 × 1696 بنسبة 3:2، و2752 × 1536 بنسبة 16:9 مباشرة، دون مكبّر. ويقرأ البرومبت كنص، لذلك تنجح الجمل وحروف الجر وتعليمات التخطيط، وتظهر الكلمات المقتبسة كما كُتبت: «a banner above the door reads ‘OPEN ALL NIGHT’» تخرج حرفيًا في برومبتات اختبار دليل الإعدادات. ويقدّم دليل الإعدادات بنية البرومبت الأنجح والإعدادات المقيسة.
التعديل بنقطة التحقق نفسها. أعطه صورة وجملة فيغيّر الصورة: استبدال عنصر، أو تغيير أسلوب مشهد، أو إضافة نص. أعطه حتى عشر صور مرجعية فيركّبها، محافظًا على اتساق شخصية أو منتج عبر اللقطات. ويمكن تحديد المناطق بقناع أو بدائرة مرسومة. ولا حاجة إلى نقطة تحقق منفصلة لـ inpainting في التعديلات الموضعية: فالنموذج نفسه يأخذ المنطقة كتلميح.
إخراج شفاف. اطلب صورة RGBA بخلفية شفافة فينتج النموذج قناة ألفا حقيقية، لا قصاصة: إذ يرمّز VAE ويفكّ أربع قنوات بكسل بدل ثلاث. فتخرج الشعارات والملصقات والعناصر متعددة الطبقات جاهزة للوضع.
إعادة كتابة البرومبت. تقدّم Qwen نموذجين مرافقين، وهما نسختان مضبوطتان بدقة من Qwen3.5-VL 9B، يوسّعان البرومبت القصير إلى الصيغة المفصّلة التي يفضّلها المولّد، أحدهما للتوليد والآخر للتعديل. ويعرضهما ComfyUI كخيار في قوالبه، معطّلًا افتراضيًا؛ وهما غير ضروريين.
السرعة. على بطاقة استهلاكية بسعة 16 جيجابايت، تستغرق أوزان int8 نحو 40 ثانية لصورة بـ 1 ميجابكسل، ومن أربع إلى خمس دقائق لـ 4 ميجابكسل بإعدادات الجودة في دليل الإعدادات. أما نقطة تحقق Turbo المقطّرة، الصادرة في 9 أكتوبر 2026، فترسم في 8 خطوات، أي أسرع بنحو سبع مرات عند 4 ميجابكسل، على حساب الوسيط: فالرسوم والتطريز والورق المقصوص تنجرف نحو الصور الفوتوغرافية.
Qwen-Image مقابل Stable Diffusion: كيف يعمل
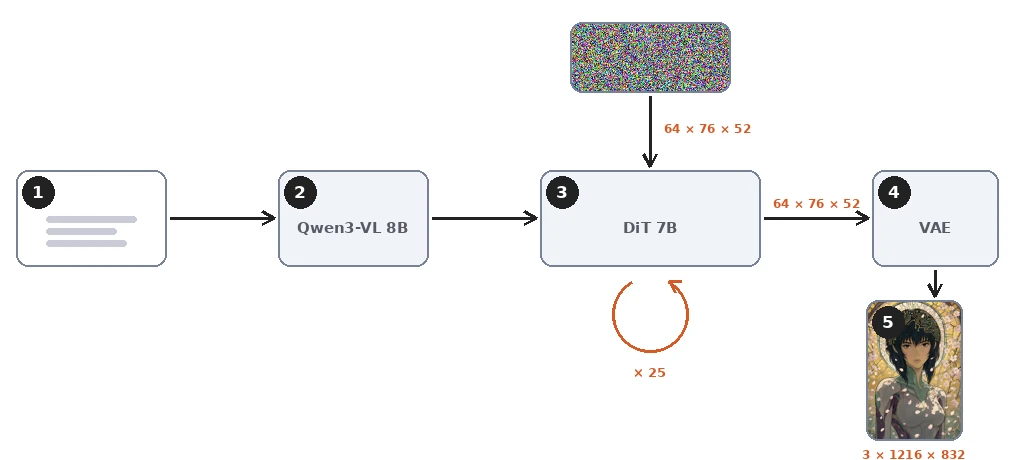
Qwen-Image 2.1 نموذج انتشار، لذلك تنطبق عليه الآلية المشروحة في دليل Stable Diffusion. مشفّر نصوص يقرأ البرومبت. ومزيل ضجيج يعمل على صورة كامنة مضغوطة على مدى عدد من الخطوات. ومفكّك يحوّل الصورة الكامنة إلى بكسلات. والاختلاف في الخيار المتّخذ لكل جزء من الأجزاء الثلاثة. ويقدّم مستودع النموذج الوقائع أدناه؛ فلم تنشر Qwen تقريرًا تقنيًا للإصدار 2.1.
نموذج رؤية ولغة بدل CLIP
يقرأ Stable Diffusion 1.5 وSDXL البرومبت بـ CLIP، وهو شبكة دُرّبت على مطابقة تعليقات قصيرة بالصور. أما Qwen-Image 2.1 فيقرأه بـ Qwen3-VL 8B، وهو نموذج رؤية ولغة كامل بثمانية مليارات معامل، أي أكثر من مولّد الصور نفسه. والمشفّر نفسه يقرأ الصور المرجعية في التعديل. ولهذا تنجح بنية البرومبت في دليل الإعدادات. فالجمل وحروف الجر والنص المقتبس وتعليمات التخطيط هي ما بُني النموذج اللغوي لتحليله. أما مشفّر CLIP فيميل إلى تسطيحها في كومة من المفاهيم.
محوّل أحادي التدفق بدل U-Net
مزيل الضجيج محوّل انتشار من 32 طبقة و7 مليارات معامل. يستخدم SDXL شبكة U-Net، أي كتل التفاف تتخللها طبقات انتباه. وانتقل Stable Diffusion 3 أيضًا إلى محوّل، هو MMDiT، حيث تسير رموز النص ورموز الصورة في تدفقين بأوزان منفصلة ولا تلتقي إلا في الانتباه داخل كل طبقة. ويذهب Qwen-Image 2.1 خطوة أبعد: تشكّل رموز النص والصورة تسلسلًا واحدًا وتمر عبر الأوزان نفسها، وهذا هو معنى «أحادي التدفق». وكان Qwen-Image الأول لعام 2025 نموذج MMDiT ثنائي التدفق بـ 20 مليار معامل؛ أما 2.1 فنحو ثلث ذلك الحجم.
وتفصيلان في انتباهه مهمان عمليًا. تُقرأ رموز النص سببيًا، كما في نموذج لغوي، وكل صورة، مرجعية كانت أم مولَّدة، كتلة واحدة ترى رموزها بعضها بعضًا. والترتيب: البرومبت أولًا، ثم الصور المرجعية، ثم الصورة المولَّدة أخيرًا، ولا ينظر أي رمز إلى ما يأتي بعده. وبذلك لا يرى البرومبت والصور المرجعية الصورة الجاري توليدها أبدًا، والجزء الخاص بها من الحساب، أي البادئة، متطابق في كل خطوة: فيُحسب مرة واحدة ويُخزَّن مؤقتًا عبر خطوات إزالة الضجيج. ولا تختار عقدة QwenImage21Cache في ComfyUI سوى مكان تلك الذاكرة المؤقتة، وبأي دقة، أو ما إذا كانت تُستخدم أصلًا.
صورة كامنة بـ 64 قناة، مضغوطة ست عشرة مرة
يقلّص VAE في Stable Diffusion الصورة بعامل ثمانية على كل ضلع إلى 4 قنوات، و16 قناة في الإصدار 3. أما VAE في Qwen-Image 2.1 فيقلّصها ست عشرة مرة على كل ضلع، إلى 64 قناة. كما يرمّز ويفكّ أربع قنوات بكسل، الأحمر والأخضر والأزرق وألفا، بدل ثلاث، وهكذا يُخرج النموذج صور RGBA حقيقية من الصورة الكامنة نفسها ذات 64 قناة. ولصورة بحجم 832 × 1216 تقيس الصورة الكامنة 64 قناة بحجم 52 × 76: نحو 253,000 رقم مقابل 3 ملايين قيمة بكسل، أي أقل باثنتي عشرة مرة.
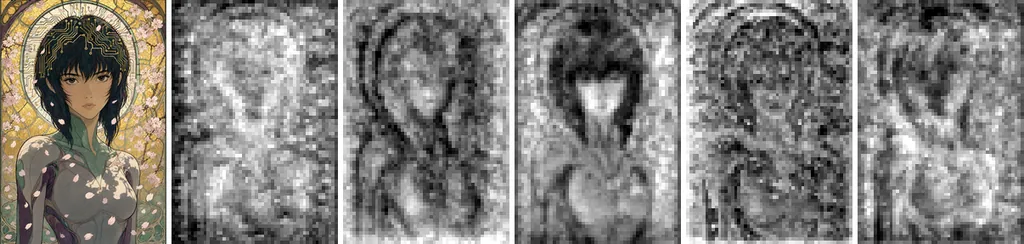
كل موضع في الصورة الكامنة رمز واحد للمحوّل، فصورة بـ 1 ميجابكسل هي 3,952 رمزًا، وصورة بـ 4 ميجابكسل 15,808 رموز. وهذه الشبكة ليست أخشن من شبكة Stable Diffusion 3 أو Qwen-Image الأول، اللذين يجمّعان صورتهما الكامنة المضغوطة 8 مرات في رقع 2 × 2 قبل المحوّل. وما يغيّره 2.1 هو أن VAE يقوم بذلك التجميع بنفسه، في 64 قناة. وتنمو كلفة الانتباه مع مربّع عدد الرموز، ولهذا تكلّف 4 ميجابكسل أكثر بكثير من أربعة أضعاف 1 ميجابكسل.
مطابقة التدفق بدل التنبؤ بالضجيج
دُرّب Stable Diffusion 1.5 وSDXL على التنبؤ بالضجيج المضاف إلى الصورة. أما Qwen-Image، مثل Stable Diffusion 3 وFLUX، فمدرَّب بـ مطابقة التدفق (flow matching). تتنبأ الشبكة بالاتجاه من الصورة الكامنة المشوشة نحو النظيفة، على خط مستقيم. ثم تتبع أداة أخذ العينات ذلك الاتجاه بخطوات Euler. ويسمّي المستودع ذلك المجدول: مطابقة تدفق بخطوات Euler منفصلة وإزاحة ديناميكية. ويصف تقرير Qwen-Image الأول الهدف، وهو هدف سرعة على مسارات مستقيمة، ويوحي مجدول 2.1 بأنه لم يتغير.
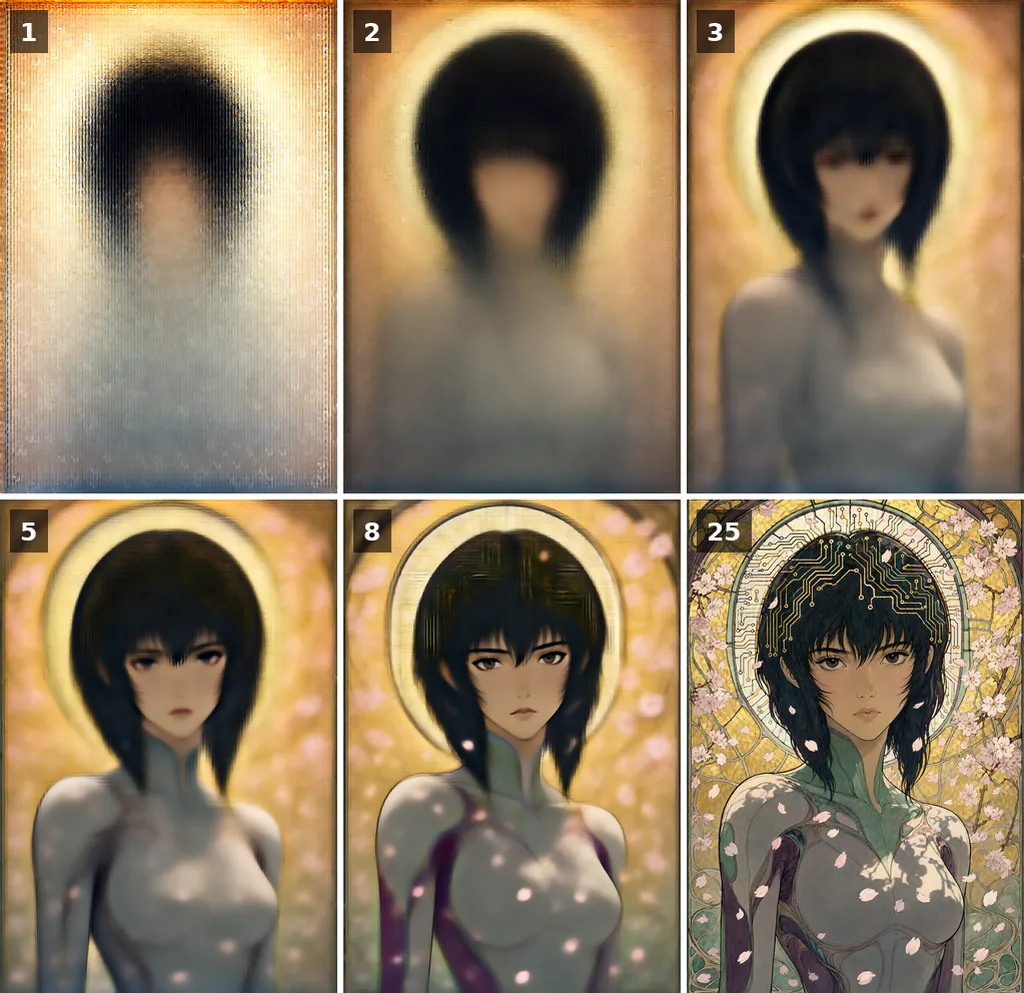
يُظهر الشكل أدناه كيف يبدو تقدير النموذج للصورة النهائية على طول الطريق. يتثبّت التكوين في الخطوات الأولى وتأتي التفاصيل لاحقًا. وهذا الترتيب من الخشن إلى الدقيق مشترك بين كل نماذج الانتشار؛ وما تغيّره مطابقة التدفق أساسًا هو كيفية توزيع الخطوات، وهو ما تضبطه الإزاحة الديناميكية.
جنبًا إلى جنب
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| مشفّر النص | CLIP ViT-L وOpenCLIP bigG | مشفّرا CLIP وT5-XXL | Qwen3-VL 8B، نموذج رؤية ولغة |
| مزيل الضجيج | U-Net، 2.6 مليار معامل | MMDiT ثنائي التدفق، 8 مليارات | محوّل انتشار أحادي التدفق، 7 مليارات، 32 طبقة |
| الصورة الكامنة | 4 قنوات، ضغط 8× | 16 قناة، 8× | 64 قناة، 16×، مع ألفا |
| هدف التدريب | التنبؤ بالضجيج | مطابقة التدفق (rectified flow) | مطابقة التدفق (rectified flow) |
| الحجم الأصلي | 1024 بكسل | 1024 بكسل | 2048 بكسل |
| التعديل | نموذج inpainting من طرف ثالث | لا نموذج تعديل رسمي، ControlNet فقط | نقطة التحقق نفسها، حتى 10 صور مرجعية |
| الرخصة | OpenRAIL++-M | Community License | Qwen Research License |
لا يغيّر شيء من هذا طريقة قيادة النموذج. فالتوجيه والخطوات والسييد والحجم تتصرف كما في أي نموذج انتشار؛ ولا تختلف سوى الأرقام الأنجح، ويقيسها دليل الإعدادات.
الإصدارات، من Qwen-Image إلى 2.1
الترقيم مربك لأنه يتبع البنية المعمارية لا قناة الإصدار. فقد قدّم Qwen-Image 2.0، المعلن عنه في فبراير 2026 والذي لم تُنشر أوزانه قط، التصميم الأخف الذي يقدّمه 2.1 اليوم مفتوحًا. أما Qwen-Image 3.0، المعلن عنه في يوليو 2026، فنموذج رائد أكبر يُقدَّم عبر API علي بابا فقط. ولم تشرح Qwen هذا النظام؛ والتواريخ أدناه مأخوذة من مستودعات المشروع، ومن إعلان Qwen بالنسبة إلى 3.0.
| الإصدار | التاريخ | ما هو | الأوزان |
|---|---|---|---|
| Qwen-Image | 4 أغسطس 2025 | MMDiT ثنائي التدفق بـ 20 مليار معامل مع مشفّر Qwen2.5-VL 7B؛ من النص إلى الصورة | مفتوحة، Apache 2.0 |
| Qwen-Image-Edit، ثم Edit-2509 وEdit-2511 | من أغسطس إلى ديسمبر 2025 | نماذج تعديل على الأساس نفسه؛ عدة صور مرجعية منذ 2509؛ ونموذج RGBA متعدد الطبقات، Qwen-Image-Layered، في ديسمبر | مفتوحة، Apache 2.0 |
| Qwen-Image-2512 | 31 ديسمبر 2025 | آخر إصدار من النص إلى الصورة في خط الـ 20 مليارًا | مفتوحة، Apache 2.0 |
| Qwen-Image 2.0 | 10 فبراير 2026 | التصميم الذي يرثه 2.1: مشفّر Qwen3-VL، وVAE بـ 64 قناة، ودقة 2K أصلية، وتعليمات حتى 1,000 رمز؛ تقرير تقني في مايو 2026 | غير منشورة |
| Qwen-Image 3.0 | 21 يوليو 2026 | النموذج الرائد خلف API علي بابا: برومبتات حتى 4,500 رمز، ورسوم معلوماتية ولوحات قصصية تُرسم في تمريرة واحدة | عبر API فقط |
| Qwen-Image 2.1 | 20 سبتمبر 2026 | محوّل أحادي التدفق بـ 7 مليارات معامل مع مشفّر Qwen3-VL 8B؛ التوليد والتعديل في نقطة تحقق واحدة، RGBA، 2K | مفتوحة، Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 أكتوبر 2026 | نسخة مقطّرة من 2.1، 8 خطوات | مفتوحة، Qwen Research License |
وهكذا، على صفحة تنزيل، «Qwen-Image» دون رقم هو نموذج 2025 ذو الـ 20 مليار معامل، وما زال متاحًا مع تحديثاته 2512 وEdit. أما النموذج المفتوح الحالي فهو 2.1، و3.0 هو النموذج خلف خدمة علي بابا المدفوعة. ويتشارك 2.1 و3.0 النسب لا الأوزان.
رخصة Qwen-Image: أوزان مفتوحة، للبحث فقط
كان Qwen-Image الأول ونماذج تعديله تحت رخصة Apache 2.0: متاحة لأي غرض، بما في ذلك الاستخدام التجاري. أما Qwen-Image 2.1 ونسخته Turbo فتحت Qwen Research License Agreement. يمكن تنزيل الأوزان ودراستها وتشغيلها وضبطها بدقة، لكن للبحث والتقييم فقط. وأي استخدام تجاري يحتاج إلى رخصة منفصلة من Qwen.
وهذا يضع 2.1 في موضع مختلف عن Stable Diffusion، الذي تسمح رخصتا 1.5 وSDXL فيه بالاستخدام التجاري مع قائمة استخدامات محظورة، وتسمح به رخصة 3.5 دون مليون دولار من الإيرادات السنوية، وعن FLUX 3 Klein، المجاني للاستخدام التجاري دون خمسة ملايين. فبالنسبة إلى طالب أو مختبر، لا شيء يتغير. أما بالنسبة إلى استوديو، فالمساران المفتوحان هما API المدفوعة أو رخصة تجارية تُطلب من Qwen.
تجربة Qwen-Image والمضي أبعد
أسرع طريقة هي صفحة Qwen-Image 2.1 المجانية في هذا الموقع: دون حساب، توليد وتعديل بصور مرجعية، وطابور الانتظار معروض مباشرة.
ولتشغيله في المنزل، يدعم ComfyUI النموذج أصلًا. ثلاثة ملفات من إعادة تغليف Comfy-Org توضع في المجلدات المعتادة: نموذج الانتشار، ومشفّر النص Qwen3-VL، وVAE، بإصدارات int8 لبطاقة 16 جيجابايت. ويغطي دليل الإعدادات المخطط وبنية البرومبت والتوجيه والأحجام التي قيست على تلك البطاقة بالضبط، إضافة إلى Turbo وTurbo الموجَّه.
وللمبادئ المشتركة بين كل هذه النماذج، الضجيج والفضاء الكامن والتوجيه والسييد، اقرأ ما هو Stable Diffusion؟؛ فالشروح تنطبق هنا أيضًا، ولا تتغير سوى الأرقام.