Qwen-Image란, 한마디로
Qwen-Image는 알리바바 클라우드 부문의 모델 계열인 Qwen의 이미지 생성 라인입니다. 2025년 8월에 Apache 2.0 라이선스의 20B 파라미터 모델로 등장했고, 기술 보고서도 함께 나왔습니다. 돋보인 것은 글자였습니다. 문단, 간판, 라벨이 읽히는 글자로 나왔습니다. 영어도 그랬고, 특히 중국어가 그랬습니다. Stable Diffusion 1.5와 SDXL은 꼬불꼬불한 선을 그렸고, 2024년의 모델들은 기껏해야 영어 단어 몇 개를 맞혔습니다.
현재 공개된 버전은 2026년 9월 20일에 나온 Qwen-Image 2.1입니다. 더 작고 빠른 모델입니다. 이미지 생성기는 7B 파라미터이고, 여기에 8B 파라미터의 비전 언어 인코더가 붙습니다. 체크포인트 하나가 두 가지 일을 합니다. 텍스트에서 이미지를 생성하고, 문장 하나와 최대 열 장의 참조 이미지로 기존 그림을 편집합니다. 네이티브 2K와 진짜 투명 이미지를 출력합니다. 라이선스는 더 이상 Apache가 아닙니다. 연구와 평가 용도로만 쓸 수 있습니다.
Stable Diffusion이나 FLUX처럼 소비자용 그래픽카드의 ComfyUI에서 돌아가는 디퓨전 모델이고, 같은 종류의 프롬프트를 읽습니다. 다른 점은 내부에 있습니다. 그것을 작동 원리 섹션에서 설명합니다.
Qwen-Image 2.1이 할 수 있는 일
네이티브 2K 텍스트 투 이미지. 정사각형 2048 × 2048, 3:2의 2528 × 1696, 16:9의 2752 × 1536을 업스케일러 없이 바로 렌더링합니다. 프롬프트를 글로 읽기 때문에 문장, 전치사, 레이아웃 지시가 통하고, 따옴표 안의 단어는 쓴 그대로 나타납니다. 설정 가이드의 테스트 프롬프트에서 “a banner above the door reads ‘OPEN ALL NIGHT’”는 적힌 그대로 나왔습니다. 설정 가이드에 가장 잘 통하는 프롬프트 구조와 측정한 설정이 있습니다.
같은 체크포인트로 편집. 그림 한 장과 문장 하나를 주면 그림을 바꿉니다. 물체를 바꾸고, 장면의 스타일을 바꾸고, 글자를 넣습니다. 최대 열 장의 참조 이미지를 주면 이들을 합성해 캐릭터나 제품을 여러 컷에서 일관되게 유지합니다. 영역은 마스크나 손으로 그린 원으로 가리킬 수 있습니다. 부분 편집에 별도의 인페인팅 체크포인트는 필요 없습니다. 같은 모델이 영역을 힌트로 받습니다.
투명 출력. 투명 배경의 RGBA 이미지를 요청하면 모델은 오려낸 그림이 아니라 진짜 알파 채널을 만듭니다. VAE가 픽셀 채널을 세 개가 아니라 네 개 인코딩하고 디코딩하기 때문입니다. 로고, 스티커, 레이어 소재가 바로 쓸 수 있는 상태로 나옵니다.
프롬프트 다시 쓰기. Qwen은 짧은 프롬프트를 생성기가 선호하는 상세한 형태로 늘려 주는 보조 모델 두 개를 함께 냈습니다. Qwen3.5-VL 9B를 파인튜닝한 것으로, 하나는 생성용, 하나는 편집용입니다. ComfyUI 템플릿에는 옵션으로 들어 있고 기본값은 꺼짐입니다. 필수는 아닙니다.
속도. 16GB 소비자용 그래픽카드에서 int8 가중치는 설정 가이드의 품질 설정으로 1메가픽셀 이미지에 약 40초, 4메가픽셀에 네다섯 분이 걸립니다. 2026년 10월 9일에 공개된 증류 버전 Turbo 체크포인트는 8스텝으로 렌더링하며 4메가픽셀에서 약 일곱 배 빠릅니다. 대가는 매체입니다. 드로잉, 자수, 종이 공예가 사진 쪽으로 흘러갑니다.
Qwen-Image와 Stable Diffusion의 차이: 작동 원리
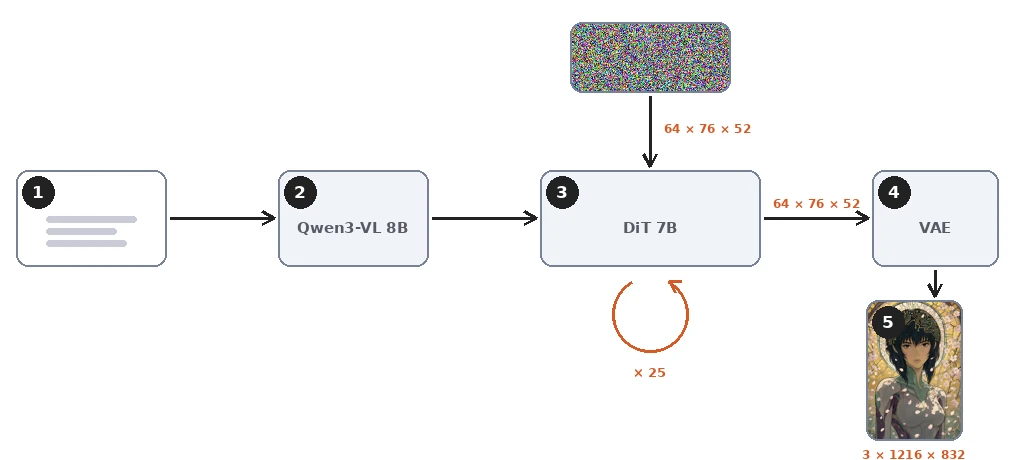
Qwen-Image 2.1은 디퓨전 모델이므로 Stable Diffusion 가이드에서 설명한 원리가 그대로 적용됩니다. 텍스트 인코더가 프롬프트를 읽습니다. 디노이저가 압축된 잠재 표현을 여러 스텝에 걸쳐 다듬습니다. 디코더가 잠재 표현을 픽셀로 바꿉니다. 다른 것은 이 세 부품 각각에서 내린 선택입니다. 아래 사실은 모델 저장소에서 가져왔습니다. Qwen은 2.1의 기술 보고서를 내지 않았습니다.
CLIP 대신 비전 언어 모델
Stable Diffusion 1.5와 SDXL은 짧은 캡션을 이미지와 짝짓도록 학습된 네트워크인 CLIP으로 프롬프트를 읽습니다. Qwen-Image 2.1은 Qwen3-VL 8B로 읽습니다. 80억 파라미터의 본격적인 비전 언어 모델이며, 파라미터 수가 이미지 생성기보다 많습니다. 편집에서는 같은 인코더가 참조 이미지도 읽습니다. 설정 가이드의 프롬프트 구조가 통하는 이유가 여기에 있습니다. 문장, 전치사, 따옴표 안의 글자, 레이아웃 지시는 언어 모델이 애초에 해석하도록 만들어진 것들입니다. CLIP 인코더는 이것들을 개념 더미로 뭉개 버리는 경향이 있습니다.
U-Net 대신 단일 스트림 트랜스포머
디노이저는 32층, 7B 파라미터의 디퓨전 트랜스포머입니다. SDXL은 U-Net, 즉 컨볼루션 블록 사이에 어텐션 층을 끼운 구조를 씁니다. Stable Diffusion 3도 트랜스포머인 MMDiT로 옮겨 갔는데, 거기서는 텍스트 토큰과 이미지 토큰이 가중치가 분리된 두 스트림을 따로 지나가고 각 층의 어텐션에서만 만납니다. Qwen-Image 2.1은 한 걸음 더 나아갑니다. 텍스트 토큰과 이미지 토큰이 하나의 시퀀스를 이루어 같은 가중치를 지나갑니다. “단일 스트림”이란 바로 그 뜻입니다. 2025년의 첫 Qwen-Image는 20B 파라미터의 이중 스트림 MMDiT였습니다. 2.1은 그 크기의 약 삼분의 일입니다.
이 어텐션에는 실전에서 중요한 세부 사항이 두 가지 있습니다. 텍스트 토큰은 언어 모델에서처럼 인과적으로 읽힙니다. 그리고 참조 이미지든 생성 이미지든 각 이미지는 토큰들이 서로를 모두 보는 하나의 블록입니다. 순서는 프롬프트, 참조 이미지, 생성 이미지 순이고, 토큰은 자기 뒤에 오는 것을 절대 보지 않습니다. 그래서 프롬프트와 참조 이미지는 생성 중인 이미지를 보지 못하며, 이들에 속하는 계산 부분인 프리픽스는 모든 스텝에서 똑같습니다. 한 번만 계산해 디노이징 스텝 전체에 걸쳐 캐시합니다. ComfyUI의 QwenImage21Cache 노드는 그 캐시를 어디에, 어떤 정밀도로 둘지, 아니면 아예 쓰지 않을지만 고릅니다.
열여섯 배 압축된 64채널 잠재 표현
Stable Diffusion의 VAE는 이미지를 각 변 팔분의 일로 줄여 4채널로 만듭니다. 버전 3에서는 16채널입니다. Qwen-Image 2.1의 VAE는 각 변 십육분의 일로 줄여 64채널로 만듭니다. 또 빨강, 초록, 파랑에 알파를 더한 네 개의 픽셀 채널을 인코딩하고 디코딩합니다. 같은 64채널 잠재 표현에서 진짜 RGBA 이미지가 나오는 것은 그 덕분입니다. 832 × 1216 이미지라면 잠재 표현은 52 × 76의 64채널, 약 253,000개의 숫자입니다. 픽셀 값은 약 3,000,000개이니 십이분의 일입니다.
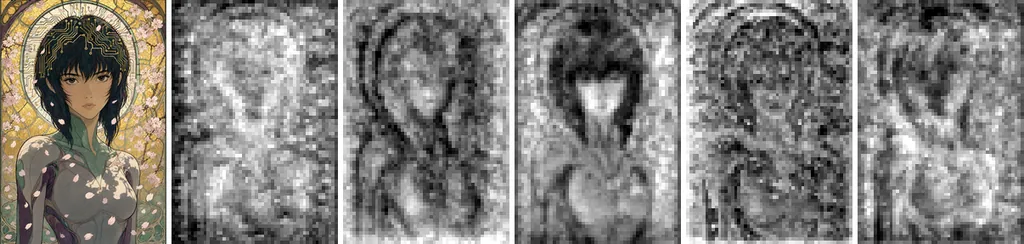
잠재 표현의 위치 하나가 트랜스포머의 토큰 하나이므로, 1메가픽셀 이미지는 3,952 토큰이고 4메가픽셀은 15,808 토큰입니다. 이 격자는 Stable Diffusion 3나 첫 Qwen-Image보다 거칠지 않습니다. 그 모델들은 8배 압축한 잠재 표현을 트랜스포머에 넣기 전에 2 × 2 패치로 묶습니다. 2.1이 바꾼 것은 그 묶음을 VAE가 직접 64채널로 해 버린다는 점입니다. 어텐션 비용은 토큰 수의 제곱으로 늘기 때문에, 4메가픽셀은 1메가픽셀의 네 배를 훌쩍 넘는 비용이 듭니다.
노이즈 예측 대신 플로우 매칭
Stable Diffusion 1.5와 SDXL은 이미지에 더해진 노이즈를 예측하도록 학습되었습니다. Qwen-Image는 Stable Diffusion 3나 FLUX처럼 플로우 매칭으로 학습됩니다. 네트워크는 노이즈 낀 잠재 표현에서 깨끗한 잠재 표현으로 향하는 방향을 직선을 따라 예측합니다. 샘플러는 그 방향을 Euler 스텝으로 따라갑니다. 저장소는 그 스케줄러를 Euler 이산 스텝과 동적 shift를 쓰는 플로우 매칭이라고 명시합니다. 첫 Qwen-Image 보고서는 학습 목표를 직선 경로를 따르는 속도 타깃으로 설명하는데, 2.1의 스케줄러로 보아 그것은 바뀌지 않은 것으로 보입니다.
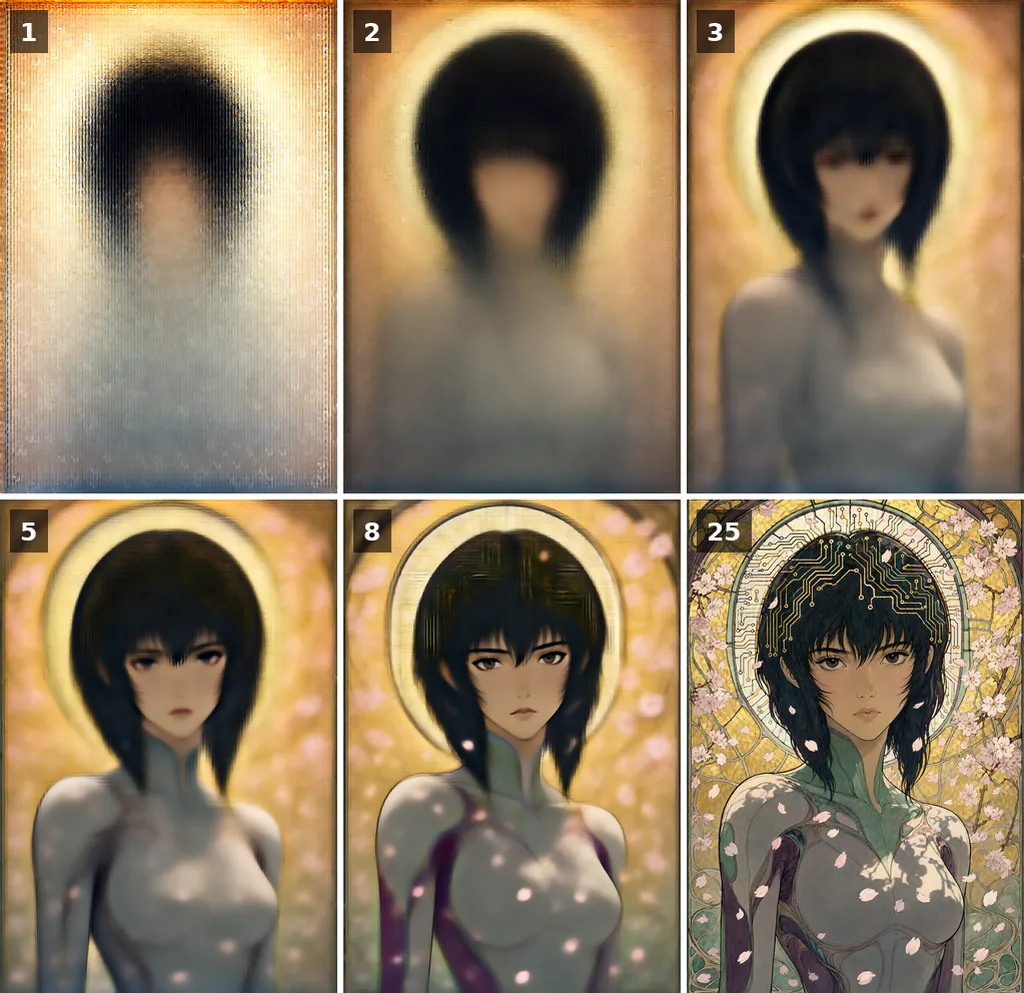
아래 그림은 모델이 중간중간 추정하는 완성 이미지가 어떤 모습인지 보여 줍니다. 구도는 처음 몇 스텝에서 고정되고 디테일은 나중에 옵니다. 이렇게 큰 틀에서 세부로 가는 순서는 모든 디퓨전 모델에 공통입니다. 플로우 매칭이 주로 바꾸는 것은 스텝의 간격이고, 동적 shift가 조정하는 것이 바로 그것입니다.
나란히 비교
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| 텍스트 인코더 | CLIP ViT-L과 OpenCLIP bigG | CLIP 인코더 두 개와 T5-XXL | Qwen3-VL 8B, 비전 언어 모델 |
| 디노이저 | U-Net, 2.6B 파라미터 | 이중 스트림 MMDiT, 8B | 단일 스트림 디퓨전 트랜스포머, 7B, 32층 |
| 잠재 표현 | 4채널, 8배 압축 | 16채널, 8배 | 64채널, 16배, 알파 포함 |
| 학습 목표 | 노이즈 예측 | 플로우 매칭(rectified flow) | 플로우 매칭(rectified flow) |
| 네이티브 크기 | 1024 px | 1024 px | 2048 px |
| 편집 | 서드파티 인페인팅 모델 | 공식 편집 모델 없음, ControlNet만 | 같은 체크포인트, 참조 이미지 최대 10장 |
| 라이선스 | OpenRAIL++-M | Community License | Qwen Research License |
이 중 어느 것도 모델을 다루는 방법을 바꾸지 않습니다. 가이던스, 스텝, 시드, 크기는 여느 디퓨전 모델과 똑같이 동작합니다. 다른 것은 가장 잘 맞는 숫자뿐이며, 설정 가이드가 그것을 측정했습니다.
버전: Qwen-Image에서 2.1까지
번호가 헷갈리는 이유는 공개 경로가 아니라 아키텍처를 따르기 때문입니다. 2026년 2월에 발표되고 가중치로는 한 번도 공개되지 않은 Qwen-Image 2.0이 지금 2.1이 공개한 가벼운 설계를 처음 도입했습니다. 2026년 7월에 발표된 Qwen-Image 3.0은 더 큰 플래그십으로 알리바바 API를 통해서만 제공됩니다. Qwen은 이 체계를 설명하지 않았습니다. 아래 날짜는 프로젝트 저장소에서, 3.0은 Qwen의 발표에서 가져왔습니다.
| 릴리스 | 날짜 | 무엇인가 | 가중치 |
|---|---|---|---|
| Qwen-Image | 2025년 8월 4일 | Qwen2.5-VL 7B 인코더를 쓰는 20B 파라미터 이중 스트림 MMDiT, 텍스트 투 이미지 | 공개, Apache 2.0 |
| Qwen-Image-Edit, 이어서 Edit-2509와 Edit-2511 | 2025년 8월부터 12월까지 | 같은 베이스의 편집 모델. 2509부터 참조 이미지 여러 장 지원. 12월에 레이어 RGBA 모델 Qwen-Image-Layered | 공개, Apache 2.0 |
| Qwen-Image-2512 | 2025년 12월 31일 | 20B 계열의 마지막 텍스트 투 이미지 릴리스 | 공개, Apache 2.0 |
| Qwen-Image 2.0 | 2026년 2월 10일 | 2.1이 물려받은 설계: Qwen3-VL 인코더, 64채널 VAE, 네이티브 2K, 최대 1,000 토큰의 지시문. 기술 보고서는 2026년 5월 | 미공개 |
| Qwen-Image 3.0 | 2026년 7월 21일 | 알리바바 API 뒤의 플래그십: 최대 4,500 토큰의 프롬프트, 인포그래픽과 스토리보드를 한 번에 렌더링 | API 전용 |
| Qwen-Image 2.1 | 2026년 9월 20일 | Qwen3-VL 8B 인코더를 쓰는 7B 파라미터 단일 스트림 트랜스포머. 생성과 편집을 체크포인트 하나로, RGBA, 2K | 공개, Qwen Research License |
| Qwen-Image 2.1 Turbo | 2026년 10월 9일 | 2.1의 증류 버전, 8스텝 | 공개, Qwen Research License |
그러니 다운로드 페이지에서 번호 없는 “Qwen-Image”는 2025년의 20B 모델이며, 2512와 Edit 업데이트와 함께 지금도 받을 수 있습니다. 현재의 공개 모델은 2.1이고, 3.0은 알리바바 유료 서비스 뒤에 있는 모델입니다. 2.1과 3.0은 계보를 공유하지만 가중치는 공유하지 않습니다.
Qwen-Image 라이선스: 오픈 웨이트, 연구 용도만
첫 Qwen-Image와 그 편집 모델들은 Apache 2.0이었습니다. 상업적 이용을 포함해 무엇에든 자유롭게 쓸 수 있습니다. Qwen-Image 2.1과 그 Turbo는 Qwen Research License Agreement를 따릅니다. 가중치를 내려받고, 연구하고, 실행하고, 파인튜닝할 수 있지만 연구와 평가 용도로만 가능합니다. 상업적 이용에는 Qwen에서 별도 라이선스를 받아야 합니다.
이 점에서 2.1은 Stable Diffusion과 다른 위치에 있습니다. Stable Diffusion의 1.5와 SDXL 라이선스는 금지 용도 목록을 두고 상업적 이용을 허용하고, 3.5 라이선스는 연 매출 백만 달러 미만이면 허용합니다. FLUX 3 Klein은 오백만 달러 미만이면 상업적 이용이 무료입니다. 학생이나 연구실에는 달라지는 것이 없습니다. 스튜디오에 열려 있는 길은 유료 API이거나 Qwen에 신청하는 상업 라이선스입니다.
Qwen-Image 써 보기, 그리고 더 나아가기
가장 빠른 방법은 이 사이트의 무료 Qwen-Image 2.1 페이지입니다. 계정이 필요 없고, 생성과 참조 이미지를 쓴 편집이 되며, 대기열이 실시간으로 표시됩니다.
집에서 돌리려면, ComfyUI가 이 모델을 기본 지원합니다. Comfy-Org가 다시 패키징한 파일 세 개를 늘 쓰는 폴더에 넣으면 됩니다. 디퓨전 모델, Qwen3-VL 텍스트 인코더, VAE이며, 16GB 그래픽카드용으로는 int8 버전입니다. 설정 가이드는 그래프, 프롬프트 구조, 가이던스, 바로 그 그래픽카드에서 측정한 크기, 그리고 Turbo와 가이드된 Turbo를 다룹니다.
이 모델들이 모두 공유하는 원리인 노이즈, 잠재 공간, 가이던스, 시드는 Stable Diffusion이란?을 읽어 보세요. 설명은 그대로 통하고, 숫자만 달라집니다.