Wat is Qwen-Image, in het kort
Qwen-Image is de beeldgeneratielijn van Qwen, de modelfamilie van de clouddivisie van Alibaba. Het verscheen in augustus 2025 als model met 20 miljard parameters onder de Apache 2.0-licentie, met een technisch rapport. Het viel op door zijn tekst. Alinea's, borden en etiketten kwamen er leesbaar uit, in het Engels en vooral in het Chinees, waar Stable Diffusion 1.5 en SDXL krabbels produceerden en de modellen van 2024 hooguit een paar Engelse woorden haalden.
De huidige open versie is Qwen-Image 2.1, uitgebracht op 20 september 2026. Het is een kleiner en sneller model: 7 miljard parameters voor de beeldgenerator, plus een vision-language-encoder van 8 miljard parameters. Eén checkpoint doet twee taken. Het genereert een afbeelding uit tekst, en het bewerkt een bestaande afbeelding op basis van een zin en maximaal tien referentieafbeeldingen. Het levert native 2K en echte transparante afbeeldingen. De licentie is niet langer Apache: alleen onderzoek en evaluatie.
Net als Stable Diffusion en FLUX is het een diffusiemodel dat in ComfyUI op een consumentenvideokaart draait, en het leest hetzelfde soort prompt. Het verschil zit vanbinnen, en dat is wat de sectie over de werking uitlegt.
Wat Qwen-Image 2.1 kan
Text-to-image in native 2K. Het model rendert vierkanten van 2048 × 2048, 2528 × 1696 in 3:2 en 2752 × 1536 in 16:9 rechtstreeks, zonder upscaler. Het leest de prompt als tekst, dus zinnen, voorzetsels en lay-outinstructies werken, en woorden tussen aanhalingstekens verschijnen zoals geschreven: “a banner above the door reads ‘OPEN ALL NIGHT’” komt er in de testprompts van de instellingengids precies zo uit. De instellingengids geeft de promptopbouw die het best werkt en de gemeten instellingen.
Bewerken met hetzelfde checkpoint. Geef het een afbeelding en een zin, en het verandert de afbeelding: een object vervangen, een scène in een andere stijl zetten, tekst toevoegen. Geef het maximaal tien referentieafbeeldingen en het combineert ze, waarbij een personage of een product van shot tot shot hetzelfde blijft. Gebieden kun je aanwijzen met een masker of een getekende cirkel. Voor lokale bewerkingen is geen apart inpainting-checkpoint nodig: hetzelfde model neemt het gebied als hint.
Transparante uitvoer. Vraag om een RGBA-afbeelding met transparante achtergrond en het model maakt een echt alfakanaal, geen uitsnede: de VAE codeert en decodeert vier pixelkanalen in plaats van drie. Logo's, stickers en gelaagde assets komen eruit, klaar om te plaatsen.
Prompts herschrijven. Qwen levert twee hulpmodellen mee, finetunes van Qwen3.5-VL 9B, die een korte prompt uitbreiden tot de gedetailleerde vorm die de generator het liefst heeft, één voor genereren en één voor bewerken. ComfyUI biedt ze als optie aan in zijn templates, standaard uit; nodig zijn ze niet.
Snelheid. Op een consumentenkaart van 16 GB doen de int8-gewichten ongeveer 40 seconden over een afbeelding van 1 megapixel en vier tot vijf minuten over 4 megapixel, met de kwaliteitsinstellingen van de instellingengids. Een gedistilleerd Turbo-checkpoint, uitgebracht op 9 oktober 2026, rendert in 8 steps, ongeveer zeven keer sneller op 4 megapixel, ten koste van het medium: tekeningen, borduurwerk en papierknipwerk drijven af richting foto.
Qwen-Image vs Stable Diffusion: hoe het werkt
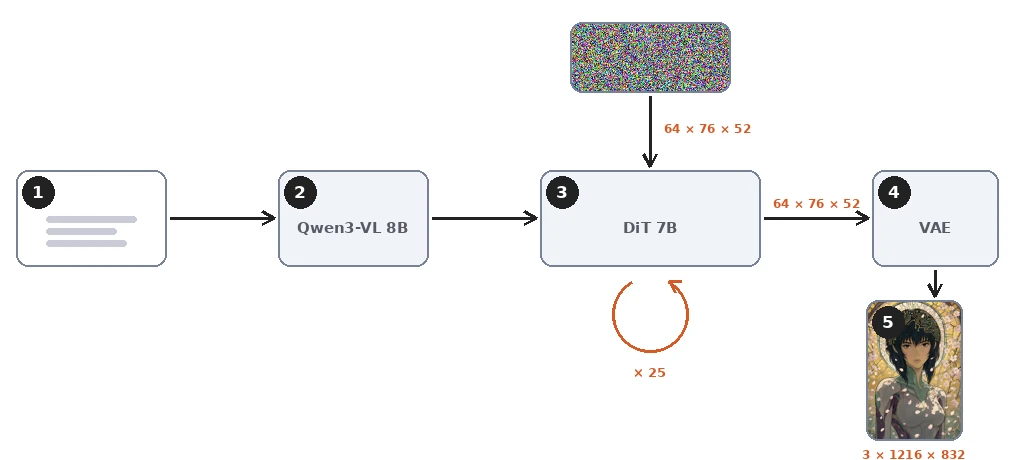
Qwen-Image 2.1 is een diffusiemodel, dus de werking die de Stable Diffusion-gids uitlegt geldt ook hier. Een tekstencoder leest de prompt. Een denoiser werkt in een aantal steps op een gecomprimeerde latent. Een decoder zet de latent om in pixels. Wat verschilt, is de keuze voor elk van de drie onderdelen. De repository van het model levert de feiten hieronder; Qwen heeft voor 2.1 geen technisch rapport gepubliceerd.
Een vision-language-model in plaats van CLIP
Stable Diffusion 1.5 en SDXL lezen de prompt met CLIP, een netwerk dat is getraind om korte bijschriften aan afbeeldingen te koppelen. Qwen-Image 2.1 leest hem met Qwen3-VL 8B, een volwaardig vision-language-model van acht miljard parameters, meer dan de beeldgenerator zelf. Dezelfde encoder leest bij het bewerken de referentieafbeeldingen. Daarom werkt de promptopbouw van de instellingengids. Zinnen, voorzetsels, tekst tussen aanhalingstekens en lay-outinstructies zijn precies waar een taalmodel voor is gebouwd. Een CLIP-encoder plet ze eerder tot een zak losse concepten.
Een single-stream transformer in plaats van een U-Net
De denoiser is een diffusion transformer van 32 lagen en 7 miljard parameters. SDXL gebruikt een U-Net, convolutieblokken met attention-lagen ertussen. Stable Diffusion 3 stapte ook over op een transformer, de MMDiT, waarin tekst- en beeldtokens in twee stromen met aparte gewichten reizen en elkaar alleen in de attention van elke laag ontmoeten. Qwen-Image 2.1 gaat een stap verder: tekst- en beeldtokens vormen één reeks en gaan door dezelfde gewichten, en dat is wat "single-stream" betekent. De eerste Qwen-Image van 2025 was een double-stream MMDiT van 20 miljard parameters; 2.1 is ongeveer een derde van die omvang.
Twee details van zijn attention doen er in de praktijk toe. Teksttokens worden causaal gelezen, zoals in een taalmodel, en elke afbeelding, referentie of gegenereerd, is één blok waarvan alle tokens elkaar zien. De volgorde is: eerst de prompt, dan de referentieafbeeldingen, als laatste de gegenereerde afbeelding, en een token kijkt nooit naar wat erna komt. De prompt en de referentieafbeeldingen zien de afbeelding in wording dus nooit, en het deel van de berekening dat bij hen hoort, de prefix, is bij elke step identiek: het wordt één keer berekend en over de denoising-steps heen gecachet. De QwenImage21Cache-node van ComfyUI bepaalt alleen waar die cache staat, in welke precisie, of dat hij überhaupt wordt gebruikt.
Een latent met 64 kanalen, zestien keer gecomprimeerd
De VAE van Stable Diffusion verkleint een afbeelding met een factor acht aan elke zijde tot 4 kanalen, 16 in versie 3. De VAE van Qwen-Image 2.1 verkleint hem met een factor zestien aan elke zijde, tot 64 kanalen. Hij codeert en decodeert ook vier pixelkanalen, rood, groen, blauw en alfa, in plaats van drie, en zo levert het model echte RGBA-afbeeldingen uit dezelfde latent met 64 kanalen. Voor een afbeelding van 832 × 1216 meet de latent 64 kanalen van 52 × 76: ongeveer 253.000 getallen voor 3 miljoen pixelwaarden, twaalf keer minder.
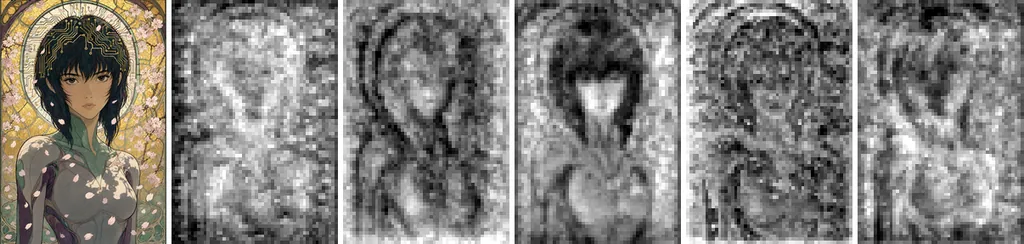
Elke latentpositie is één token voor de transformer, dus een afbeelding van 1 megapixel is 3.952 tokens en een van 4 megapixel 15.808. Dat raster is niet grover dan dat van Stable Diffusion 3 of van de eerste Qwen-Image, die hun 8-voudige latent vóór de transformer groeperen in patches van 2 × 2. Wat 2.1 verandert, is dat de VAE die groepering zelf doet, in 64 kanalen. De kosten van attention groeien met het kwadraat van het aantal tokens, en daarom kost 4 megapixel veel meer dan vier keer 1 megapixel.
Flow matching in plaats van ruisvoorspelling
Stable Diffusion 1.5 en SDXL zijn getraind om de ruis te voorspellen die aan een afbeelding is toegevoegd. Qwen-Image is, net als Stable Diffusion 3 en FLUX, getraind met flow matching. Het netwerk voorspelt de richting van de ruisige latent naar de schone, langs een rechte lijn. De sampler volgt die richting vervolgens met Euler-steps. De repository noemt die scheduler: flow matching met discrete Euler-steps en een dynamische shift. Het eerste Qwen-Image-rapport beschrijft het trainingsdoel, een snelheid langs rechte paden, en de scheduler van 2.1 laat vermoeden dat het ongewijzigd is.
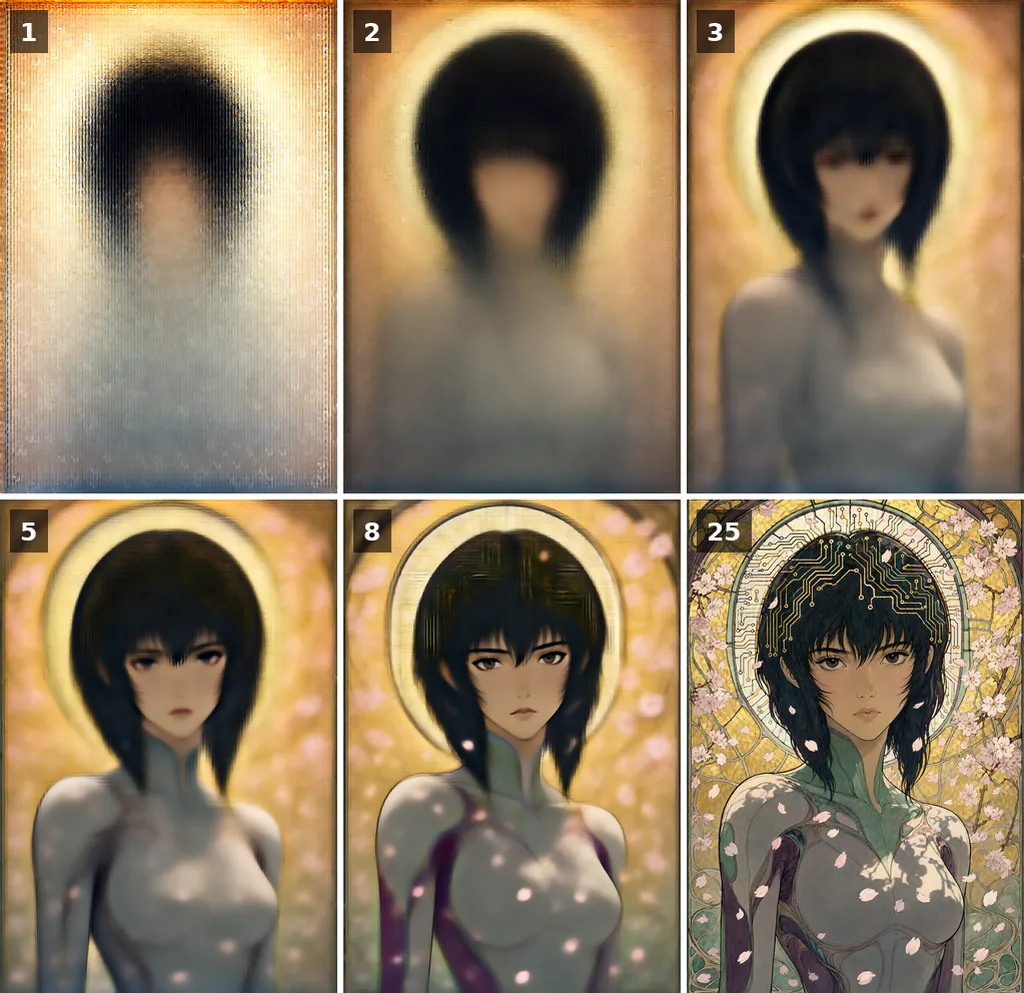
De figuur hieronder laat zien hoe de schatting van het model van de afgewerkte afbeelding er onderweg uitziet. De compositie ligt in de eerste steps vast, het detail komt later. Die volgorde van grof naar fijn delen alle diffusiemodellen; flow matching verandert vooral hoe de steps verdeeld zijn, en dat is wat de dynamische shift afstelt.
Naast elkaar
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Tekstencoder | CLIP ViT-L en OpenCLIP bigG | Twee CLIP-encoders en T5-XXL | Qwen3-VL 8B, een vision-language-model |
| Denoiser | U-Net, 2,6 miljard parameters | Double-stream MMDiT, 8 miljard | Single-stream diffusion transformer, 7 miljard, 32 lagen |
| Latent | 4 kanalen, 8× compressie | 16 kanalen, 8× | 64 kanalen, 16×, met alfa |
| Trainingsdoel | Ruisvoorspelling | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Native formaat | 1024 px | 1024 px | 2048 px |
| Bewerken | Inpainting-model van derden | Geen officieel bewerkingsmodel, alleen ControlNets | Hetzelfde checkpoint, maximaal 10 referentieafbeeldingen |
| Licentie | OpenRAIL++-M | Community License | Qwen Research License |
Niets hiervan verandert hoe je het model aanstuurt. Guidance, steps, seed en formaat gedragen zich zoals in elk diffusiemodel; alleen de getallen die het best werken verschillen, en de instellingengids meet ze.
De versies, van Qwen-Image tot 2.1
De nummering is verwarrend omdat ze de architectuur volgt, niet het uitgavekanaal. Qwen-Image 2.0, aangekondigd in februari 2026 en nooit als gewichten uitgebracht, introduceerde het lichtere ontwerp dat 2.1 nu open uitlevert. Qwen-Image 3.0, aangekondigd in juli 2026, is een groter vlaggenschip dat alleen via de API van Alibaba beschikbaar is. Qwen heeft het schema niet uitgelegd; de data hieronder komen uit de repositories van het project en, voor 3.0, uit de aankondiging van Qwen.
| Uitgave | Datum | Wat het is | Gewichten |
|---|---|---|---|
| Qwen-Image | 4 augustus 2025 | Double-stream MMDiT van 20 miljard parameters met een Qwen2.5-VL 7B-encoder; text-to-image | Open, Apache 2.0 |
| Qwen-Image-Edit, daarna Edit-2509 en Edit-2511 | augustus tot december 2025 | Bewerkingsmodellen op dezelfde basis; meerdere referentieafbeeldingen vanaf 2509; een RGBA-model in lagen, Qwen-Image-Layered, in december | Open, Apache 2.0 |
| Qwen-Image-2512 | 31 december 2025 | Laatste text-to-image-uitgave van de lijn van 20 miljard | Open, Apache 2.0 |
| Qwen-Image 2.0 | 10 februari 2026 | Het ontwerp dat 2.1 erft: Qwen3-VL-encoder, VAE met 64 kanalen, native 2K, instructies tot 1.000 tokens; technisch rapport in mei 2026 | Niet gepubliceerd |
| Qwen-Image 3.0 | 21 juli 2026 | Vlaggenschip achter de API van Alibaba: prompts tot 4.500 tokens, infographics en storyboards in één keer gerenderd | Alleen API |
| Qwen-Image 2.1 | 20 september 2026 | Single-stream transformer van 7 miljard parameters met een Qwen3-VL 8B-encoder; genereren en bewerken in één checkpoint, RGBA, 2K | Open, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 oktober 2026 | Gedistilleerde 2.1, 8 steps | Open, Qwen Research License |
Op een downloadpagina is "Qwen-Image" zonder nummer dus het model van 20 miljard uit 2025, nog steeds beschikbaar met zijn 2512- en Edit-updates. Het huidige open model is 2.1, en 3.0 is het model achter de betaalde dienst van Alibaba. 2.1 en 3.0 delen een afstamming, maar niet hun gewichten.
De licentie van Qwen-Image: open gewichten, alleen onderzoek
De eerste Qwen-Image en zijn bewerkingsmodellen waren Apache 2.0: vrij voor alles, commercieel gebruik inbegrepen. Qwen-Image 2.1 en zijn Turbo vallen onder de Qwen Research License Agreement. De gewichten mogen worden gedownload, bestudeerd, gedraaid en gefinetuned, maar alleen voor onderzoek en evaluatie. Elk commercieel gebruik vereist een aparte licentie van Qwen.
Daarmee staat 2.1 ergens anders dan Stable Diffusion, waarvan de licenties voor 1.5 en SDXL commercieel gebruik toestaan met een lijst verboden toepassingen en waarvan de 3.5-licentie het toestaat onder een miljoen dollar jaaromzet, en ook ergens anders dan FLUX 3 Klein, vrij voor commercieel gebruik onder vijf miljoen. Voor een student of een lab verandert er niets. Voor een studio blijven de betaalde API of een bij Qwen aangevraagde commerciële licentie de wegen die openstaan.
Qwen-Image proberen en verder gaan
De snelste manier is de gratis Qwen-Image 2.1-pagina van deze site: geen account, genereren en bewerken met referentieafbeeldingen, de wachtrij live in beeld.
Om het thuis te draaien: ComfyUI ondersteunt het model native. Drie bestanden uit de herverpakking van Comfy-Org gaan in de gebruikelijke mappen: het diffusiemodel, de Qwen3-VL-tekstencoder en de VAE, int8-versies voor een kaart van 16 GB. De gids over de instellingen behandelt de graph, de promptopbouw, de guidance en de formaten die op precies die kaart zijn gemeten, plus de Turbo en de Turbo met guidance.
Voor de principes die al deze modellen delen, ruis, latente ruimte, guidance en seed, lees Wat is Stable Diffusion?; de uitleg gaat één op één over, alleen de getallen veranderen.