Stable Diffusion AI online
Sztuczna inteligencja dostępna dla wszystkich za darmo
Generuj obrazy AI za darmo, bezpośrednio w przeglądarce.
Wpisz prompt. Nasze narzędzia tworzą unikalne obrazy w sekundy. Żadnego konta, GPU ani instalacji.
Darmowe narzędzia do generowania obrazów online
 Stable Diffusion 3
Tekst na obraz ze Stable Diffusion 3, bez konta
 Inpainting Popularne
Przemaluj dowolny fragment obrazu na podstawie tekstu
 Upscaling Popularne
Powiększ obraz do 2x z ostrzejszymi detalami
 Stable Diffusion XL demo
Darmowe demo online Stable Diffusion XL 1.0, bez konta
 FLUX.2 styles Nowe
Style artystyczne w FLUX.2, porównane na tych samych scenach
Qwen-Image 2.1 Nowe
Otwarty model obrazów Alibaby, wyraźny tekst i edycja
MiniMax-H3 Nowe
Otwarty model wideo ze zsynchronizowaną ścieżką dźwiękową
Wan 2.2 I2V
Zamień zdjęcie w krótkie wideo z Wan 2.2
Darmowe narzędzia do sztucznej inteligencji i LLM:
Dzieła społeczności
 giant s causeway basalt columns at sunset photograph
 anime style a street artist painting a mural
 a floating lighthouse for airships luminist painting
 stained glass of a sunrise over the sea
 anime background a first snow walk at a graduation
 a castle floating in the clouds painting
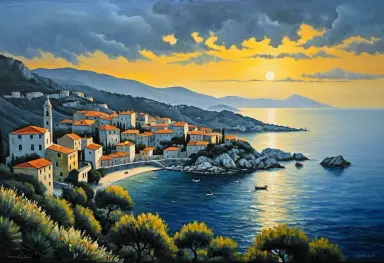 the dalmatian coast in evening mist oil painting in the style of renato guttuso
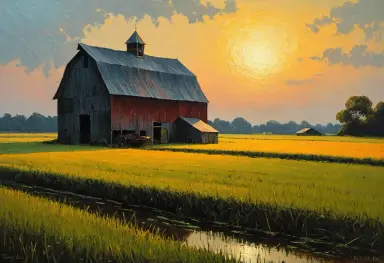 a patched rice barn tonalist painting in the style of raynald leclerc
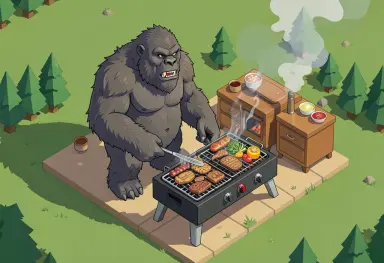 a yeti at a barbecue isometric illustration
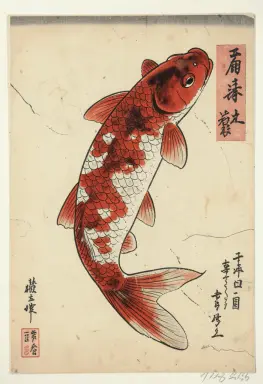 ukiyo e print of a koi fish
 oil painting of a wine cellar
 anime background an umbrella shop in the rain
 the image is a fauvist painting of a chalk rainbow peeking through a keyhole the scene is lit from the right
 photograph of a humpback whale breaching water spray blue sky telephoto cinematic lighting sharp focus high
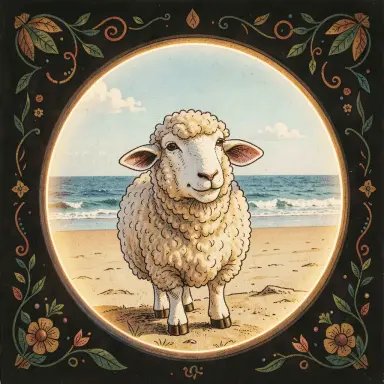 shaun the sheep rim light folk art an empty beach behind
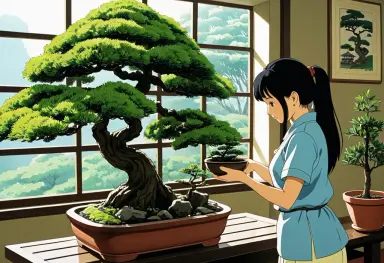 anime style a woman tending bonsai in the style of hayao miyazaki
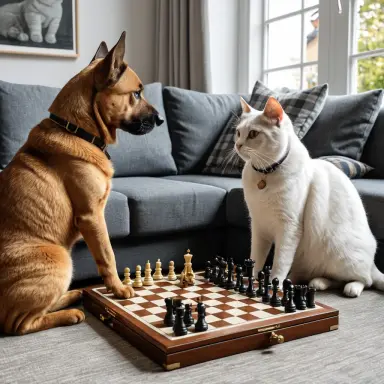 photograph style of a cat and a dog playing chess on a sofa with very serious faces cozy living room
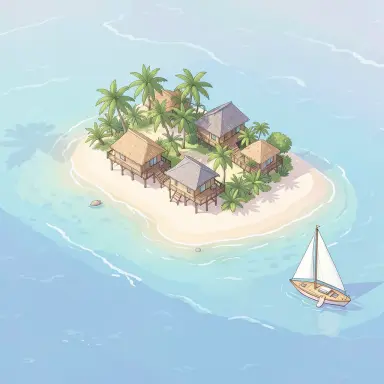 isometric illustration of a tiny tropical island resort with bungalows on stilts a reef and a sailboat pastel
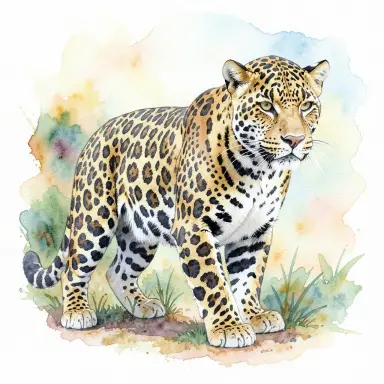 watercolor of a jaguar
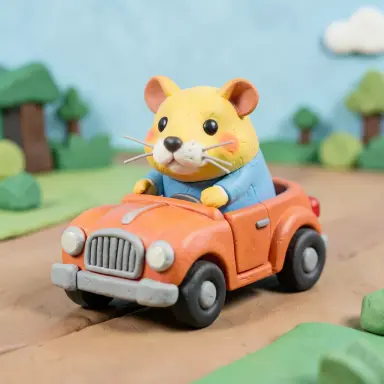 a hamster driving a toy car claymation
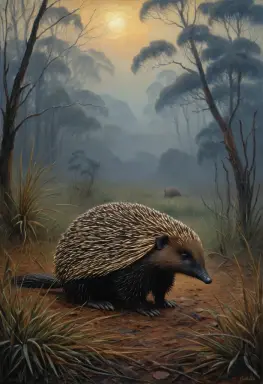 an echidna tonalist painting in evening mist
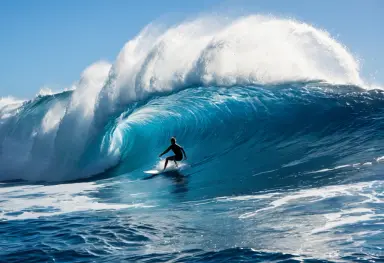 surfer riding a large blue wave spray in the sunlight hawaii action photography
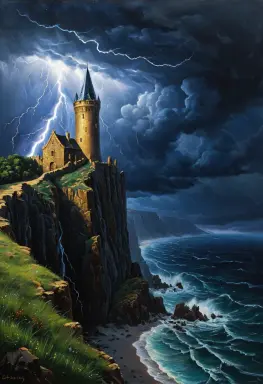 oil painting of a wizard tower on a cliff during a storm lightning dramatic chiaroscuro
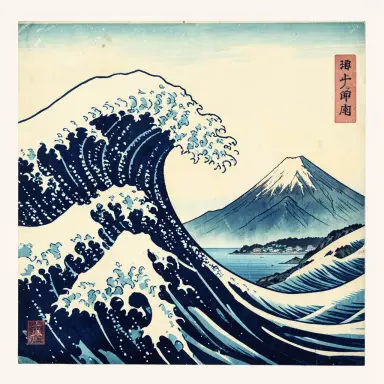 ukiyo e woodblock print of a great wave with a mountain in the background indigo and cream
Co to jest Stable Diffusion?
Stable Diffusion to AI, która tworzy obrazy z tekstu. Wpisz co chcesz — ona wygeneruje obraz.
Opracowane przez StabilityAI , jest open source. Działa na zwykłym GPU — bez chmury. Społeczność jest bardzo aktywna. Wiele modeli i dodatków jest darmowych. Możesz ją nawet trenować na własnych obrazach!
Była trenowana na milionach obrazów. Użyj jej do sztuki cyfrowej, edycji zdjęć, animacji i nie tylko.
Możesz zobaczyć przykłady w naszej galerii poleceń, Galeria sztuki i przeglądarka obrazów..Często zadawane pytania
Czy Stable Diffusion jest darmowy?
Tak. Stable Diffusion to model open source, który można bezpłatnie pobrać i uruchomić na własnym komputerze. Wszystkie narzędzia w tym serwisie również są darmowe: dema online, inpainting, powiększanie obrazów i generator promptów działają bez konta, a tekst na obraz na naszym własnym GPU wymaga jedynie darmowego konta. Bez kredytów i bez subskrypcji.
Czy potrzebuję konta, aby generować obrazy?
Konto nie jest potrzebne do dem online, inpaintingu, powiększania obrazów ani generatora promptów: otwórz stronę i zacznij. Darmowe konto, zakładane za pomocą adresu e-mail, odblokowuje tekst na obraz na naszym własnym GPU ze Stable Diffusion 1.5 i SDXL 1.0, z pełną kontrolą nad liczbą kroków, skalą CFG, seedem i rozmiarem obrazu.
Jak korzystać ze Stable Diffusion online?
Otwórz darmowe demo, wpisz opis obrazu, który chcesz uzyskać, i kliknij Generate. Obraz pojawi się po kilku sekundach i można go pobrać. Aby poprawić wynik, dodaj szczegóły dotyczące stylu i oświetlenia, napisz negatywny prompt albo zmień seed, żeby sprawdzić inne warianty. Niczego nie trzeba instalować.
Czy to oficjalna strona Stable Diffusion?
Nie. Stable Diffusion jest rozwijany przez Stability AI, którego oficjalna strona to stability.ai. stablediffusion.fr to niezależny serwis, działający od 2022 roku, który oferuje darmowe narzędzia do korzystania ze Stable Diffusion i innych otwartych modeli w przeglądarce, a także poradniki, przykłady promptów i zestawienia artystów. Nie jest powiązany ze Stability AI.
Co to jest polecenie?
Prompt to opis tekstowy, który kieruje AI. Może zawierać temat, styl artystyczny, oświetlenie, nastrój i medium — na przykład: 'średniowieczny rycerz w ciemnym lesie, obraz olejny, dramatyczne oświetlenie, kinematograficzny'. Im bardziej szczegółowy prompt, tym bliższy wynik Twojej wizji. Ogranicz go do 350 znaków, aby uzyskać najlepsze wyniki.
Prompt negatywny mówi AI, czego nie umieszczać na obrazie.
Co to jest negatywny prompt?
Prompt negatywny mówi AI, czego NIE pokazywać. Typowe przykłady: 'blurry, low quality, watermark, text, deformed hands'. Używaj ich, by usunąć typowe błędy AI.
Negatywne prompty szybko poprawiają jakość obrazu. Dodaj wagi — np. '(blurry:1.4)' — żeby je wzmocnić.
Co oznacza seed?
Seed to liczba, która inicjalizuje losowy proces generowania obrazów. Każdy obraz zaczyna się od szumu, a seed określa, jak ten początkowy szum wygląda. Zostaw go na -1, aby za każdym razem otrzymać losowy seed — i inny obraz.
Ustaw stały seed, aby odtworzyć dokładnie ten sam obraz. Przydaje się to do eksperymentowania: trzymaj seed stały, zmieniając tylko prompt lub ustawienia, aby precyzyjnie porównywać warianty. To też sposób na późniejsze odtworzenie ulubionego wyniku.
Co to jest LoRA?
LoRA oznacza Low-Rank Adaptation. To mały plik dodatku (zazwyczaj 50–150 MB), który dostosowuje model bazowy do określonego stylu, postaci lub tematu — bez ponownego trenowania całego modelu.
Załaduj LoRA, aby generować obrazy w określonym stylu artystycznym, odtworzyć konkretną postać lub dopasować koncepcję referencyjną. Możesz łączyć kilka LoRAs w jednym prompcie używając wag: <lora:my-style:0.8>. Tysiące darmowych LoRAs są dostępne na Civitai i Hugging Face.
Jak zainstalować Stable Diffusion lokalnie?
Uruchomienie Stable Diffusion lokalnie wymaga nowoczesnego GPU NVIDIA z co najmniej 6 GB VRAM. GPU AMD działają z sterownikami ROCm na Linuksie. Apple Silicon (M1/M2/M3) jest również obsługiwany przez backend MPS. Jeśli nie masz kompatybilnego GPU, nasze darmowe narzędzie online działa bezpośrednio w przeglądarce — bez instalacji.
Najpierw pobierz base model i refiner od Stability AI.Następnie zainstaluj Python 3.10 i Git.
Pobierz webUI z Automatic1111.
Umieść oba modele w folderze models/Stable-diffusion .
Znajdźwebui.bat i kliknij dwukrotnie, aby zainstalować.
Otwórz przeglądarkę na localhost:7860.
Ile VRAM potrzebuję do Stable Diffusion?
Potrzebujesz co najmniej 4 GB VRAM, aby uruchomić Stable Diffusion. 6 GB to zalecane minimum dla modeli SDXL. Przy 8 GB lub więcej możesz generować większe obrazy i korzystać z więcej funkcji.
Bez GPU możesz uruchomić Stable Diffusion na CPU, ale jest to znacznie wolniejsze. Możesz też skorzystać z naszego bezpłatnego demo online bez GPU.
Co to jest img2img?
Img2img pozwala użyć istniejącego obrazu jako punktu startowego. Podajesz obraz źródłowy i prompt. Stable Diffusion przekształca obraz zgodnie z twoimi instrukcjami.
Użyj go, aby zmienić styl zdjęcia, poprawić wygenerowany obraz lub dopracować szkic. Siła denoising kontroluje, jak bardzo AI zmienia oryginał.
Czy mogę używać obrazów Stable Diffusion komercyjnie?
To zależy od modelu. Bazowe modele Stable Diffusion używają licencji CreativeML Open RAIL-M. Pozwala ona na użytek komercyjny, ale z ograniczeniami — nie możesz używać obrazów do krzywdzenia ani oszukiwania ludzi.
Zawsze sprawdzaj licencję używanego checkpointu. Niektóre modele społeczności ograniczają użytek komercyjny. Jeśli sprzedajesz lub publikujesz obrazy AI, zachowaj zapis modelu i jego licencji.
Co to jest ControlNet?
ControlNet to rozszerzenie dla Stable Diffusion dające precyzyjną kontrolę nad kompozycją obrazu. Podajesz obraz referencyjny — pozę, mapę krawędzi lub mapę głębokości — a AI podąża za tą strukturą.
Użyj ControlNet, aby zachować dokładną pozę osoby, skopiować układ sceny lub precyzyjnie odwzorować szkic. Działa razem z promptem, kontrolując treść i strukturę obrazu.
Co to jest checkpoint?
Checkpoint to zapisany plik modelu AI. Zawiera wszystko, czego model nauczył się podczas treningu. Ładujesz checkpoint, aby ustawić styl i temat swoich obrazów.
Różne checkpointy dają bardzo różne wyniki. Niektóre są trenowane dla realistycznych zdjęć, inne dla anime lub ilustracji. Darmowe checkpointy możesz pobrać z Hugging Face lub Civitai.
Co to jest ComfyUI?
ComfyUI to darmowy interfejs oparty na węzłach dla Stable Diffusion. Tworzysz workflow obrazów, łącząc bloki zwane węzłami. Każdy węzeł wykonuje jeden krok — ładowanie modelu, dodanie promptu lub zapis obrazu.
ComfyUI daje pełną kontrolę nad każdym krokiem. Jest szybszy i lżejszy niż Automatic1111. Zaawansowani użytkownicy preferują go do złożonych workflow. Możesz udostępniać workflow jako pliki JSON.
Co to jest Flux?
Flux to model AI tekst-na-obraz firmy Black Forest Labs, założonej przez byłych badaczy Stability AI. Najnowsza wersja to FLUX.2, wydana w listopadzie 2025. Generuje obrazy do 4MP z fotorealistyczną jakością i kontrolą wielu referencji.
FLUX.2 ma cztery warianty: Max (najwyższa jakość), Pro (jakość przy pełnej prędkości), Flex (precyzja i ostry rendering tekstu) i Dev (otwarte wagi, wolne wdrożenie). FLUX.2 Dev działa lokalnie w ComfyUI lub Automatic1111 — tych samych narzędziach co Stable Diffusion.
Jaka jest najnowsza wersja Stable Diffusion?
Najnowsza wersja to Stable Diffusion 3.5 , wydany w październiku 2024 r. Produkuje ostrzejsze obrazy ze znacznie lepszym renderowaniem tekstu, bogatszymi kolorami i ulepszonymi drobnymi szczegółami. Dostępny w trzech rozmiarach: Large (8 mld parametrów), Large Turbo do szybkiej generacji i Medium — wszystkie uruchamialne lokalnie z umiarkowaną VRAM.