Ce qu'est Qwen-Image 2.1
Qwen-Image 2.1 est un seul checkpoint pour deux tâches. Il génère une image à partir d'un texte, et il modifie une image existante à partir d'une phrase et de dix images de référence au maximum. La partie génération est un transformeur de diffusion de 7 milliards de paramètres. Elle est associée à un encodeur de texte Qwen3-VL 8B, chargé dans ComfyUI comme un fichier séparé.
Un modèle de langage comme encodeur, c'est ce qui lui permet de lire des phrases entières, des consignes de mise en page et des mots entre guillemets, plutôt que des listes de mots-clés.
Qwen présente la 2.1 comme améliorée sur les textures, la typographie et la lumière des portraits. Elle travaille en 2K natif sans agrandissement : 2048 × 2048 en carré, 2528 × 1696 en 3:2, 2752 × 1536 en 16:9. Elle peut aussi sortir un vrai canal alpha quand le prompt demande un fond transparent.
Le prix, c'est le temps. Sur une carte grand public de 16 Go de mémoire vidéo, les poids int8 prennent environ 40 secondes pour une image de 1 mégapixel. Une image de 4 mégapixels prend environ quatre minutes et demie avec les réglages ci-dessous.
Une chose à savoir avant de télécharger. Les poids sont sous Qwen Research License : recherche et évaluation uniquement. Tout usage commercial exige une licence séparée auprès de Qwen. Le premier Qwen-Image, sorti en août 2025, était sous Apache 2.0. La 2.1 ne l'est pas.
Comment écrire un prompt pour Qwen-Image 2.1
Écrivez des phrases, pas des tags. L'encodeur de texte est un modèle de langage. Il lit l'ordre des mots, les prépositions et les guillemets, et il prend tout au pied de la lettre. Un « lighthouse cat » devient un chat dessiné sur un phare.
La structure ci-dessous a donné les meilleurs résultats sur un millier d'images environ. Gardez cet ordre.
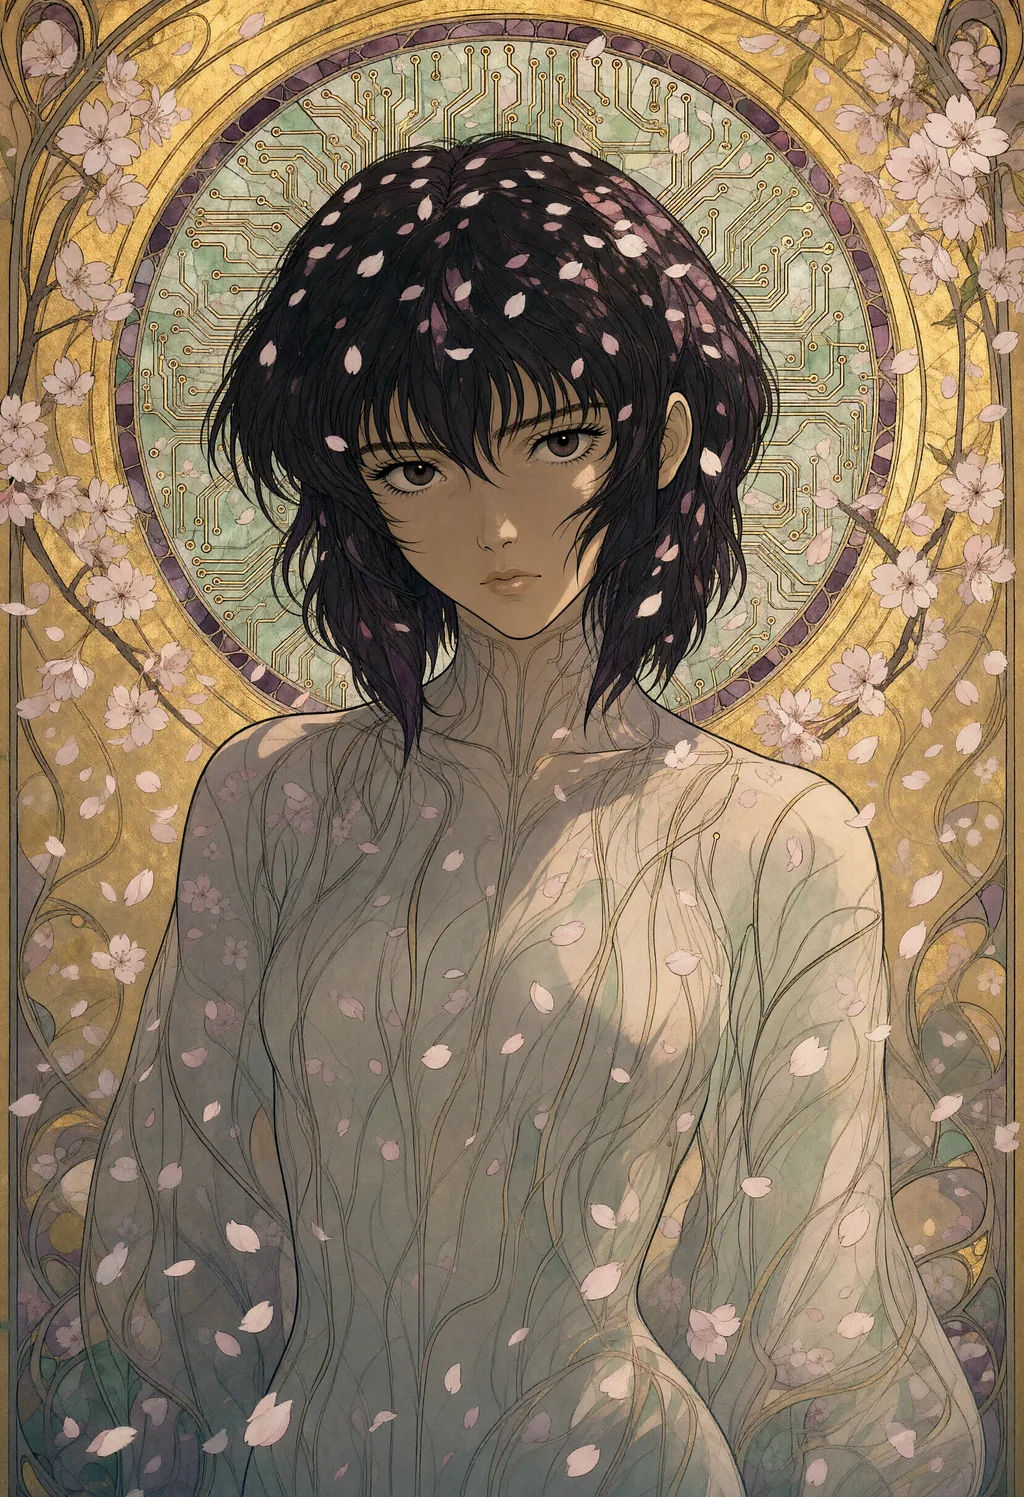
- Le médium et le sujet d'abord : « An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms ». Le médium posé en tête colore tout ce qui suit.
- Le décor : lieu, époque, météo, ou ce qui remplit l'air. « in falling cherry blossoms », « in the 1980s », « during a blizzard ».
- La lumière avec sa direction : « lit from the front by soft diffuse light, with gentle shadows ». La direction est suivie. Un simple « dramatic light » ne l'est pas.
- Le cadrage : « close-up of the subject, looking at the viewer », plan moyen, vue de dessus, le sujet minuscule dans un paysage immense.
- Les matières et la palette : « flowing ink lines, flat gold leaf background, muted jade and plum ». C'est ce que le modèle rend le mieux en 2K.
- Les restrictions, écrites dans le prompt : « no lettering, no watermark », « five fingers on each hand ». À guidance 1, le prompt négatif est ignoré. C'est donc au prompt lui-même de les porter.
Le prompt entier de l'illustration ci-dessus, dans cet ordre : An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Le texte fonctionne quand il est entre guillemets et qu'on lui donne une place. « A banner above the door reads 'OPEN ALL NIGHT' » sort juste presque à chaque fois, en capitales ou non.
L'inverse est vrai aussi. Une devanture, un diner ou une salle d'arcade sans texte demandé se couvre d'une enseigne inventée. Écrivez donc « no lettering » dès que la scène contient une façade.
Les personnages que le modèle ne connaît pas sont remplacés sans prévenir par un sosie. Le Marsupilami est devenu un singe. Mothra et Marvin the Martian sont sortis corrects.
Chaque fiche Qwen de la page d'exemples de prompts suit cette structure, avec sa seed, sa taille et ses réglages.
Des réglages qui marchent, mesurés
Le template ComfyUI officiel tourne à une guidance (CFG) de 1 avec 25 étapes. La fiche du modèle utilise 40 étapes. Les réglages ci-dessous se sont arrêtés sur CFG 3.
Au dernier test, le 16 octobre 2026, sur les mêmes seeds, ces réglages ont donné les images les plus détaillées et les plus fidèles :
| Réglage | Valeur |
|---|---|
| Guidance (CFG) | 3, avec un prompt négatif |
| Prompt négatif | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Patches du modèle | APG (eta 1, norm threshold 10, momentum 0,3) puis FreSca (low 1, high 2, cutoff 8), avant le sampler |
| Sampler | euler, scheduler simple |
| Étapes | 25 à 1 mégapixel, 20 à 2,5 et 4 mégapixels |
| LoRA | aucun |
La guidance est le seul réglage qui ne change pas la scène. À seed et taille égales, CFG 1 et CFG 3 donnent presque la même composition. C'est le rendu qui diffère.
À CFG 1, l'image est plus plate et perd les textures fines. Les points de broderie deviennent du tissu. Un visage de cartoon perd ses pupilles et sa bouche. Le métal perd ses rivets.
Pousser le CFG 1 à 30 étapes ramène la netteté, mais ni les matières ni le contraste. À 2 mégapixels, une taille essayée une fois, 40 étapes donnent une image propre mais toujours plus plate, et qui lit le prompt moins fidèlement.
L'APG empêche le CFG 3 de sursaturer. FreSca accentue les hautes fréquences. Les deux n'agissent que si la guidance dépasse 1.
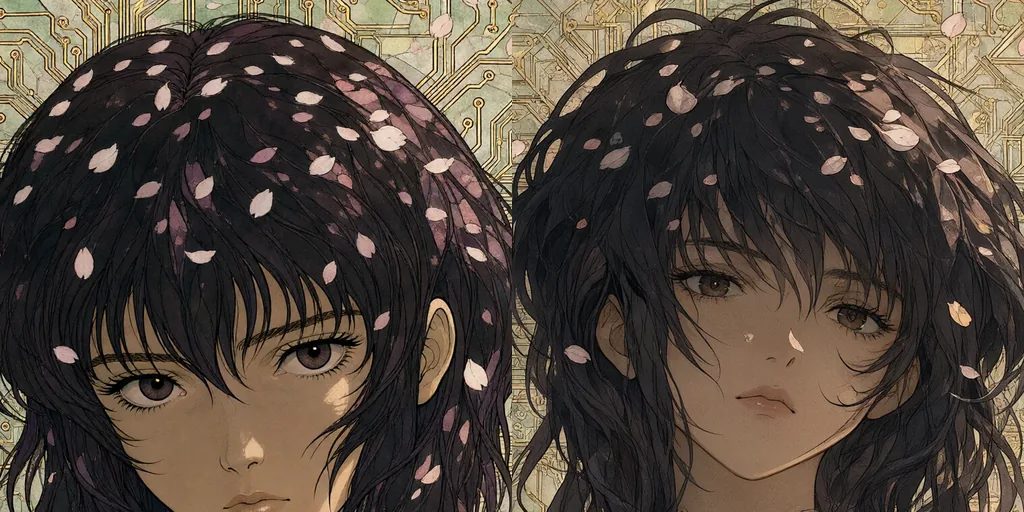
Une guidance supérieure à 1 coûte une seconde passe par étape, donc le CFG 1 est deux fois plus rapide. Sur la carte de test, cela fait 120 à 135 secondes contre 255 à 275 pour une image de 4 mégapixels. La version lente valait l'attente sur chacune des dix paires de test.
Résolution et étapes : ce qui change l'image
Comme tout modèle de diffusion, Qwen-Image 2.1 ne redimensionne pas l'image quand la taille change. Cela produit une autre prise de la même seed, donc une seed trouvée à 1 mégapixel ne se transpose pas en 2K.
Passer de 1 mégapixel à 2,5 ou 4 a donné une autre image dans chaque paire testée. Entre 2,5 et 4 mégapixels, la composition a tenu dans huit paires sur dix.
Dans l'illustration ci-dessous, seuls les détails ont bougé. À 2,5 mégapixels, les pistes de circuit ont quitté l'auréole pour les cheveux.
Changer le nombre d'étapes change aussi l'image dès que l'écart est grand. 20 et 25 étapes donnent presque la même image. À 16 étapes, l'image dérive. Il n'y a donc aucun moyen de prévisualiser à 1 mégapixel puis de rendre la même image en plus grand. Choisissez la taille d'abord, puis la seed.
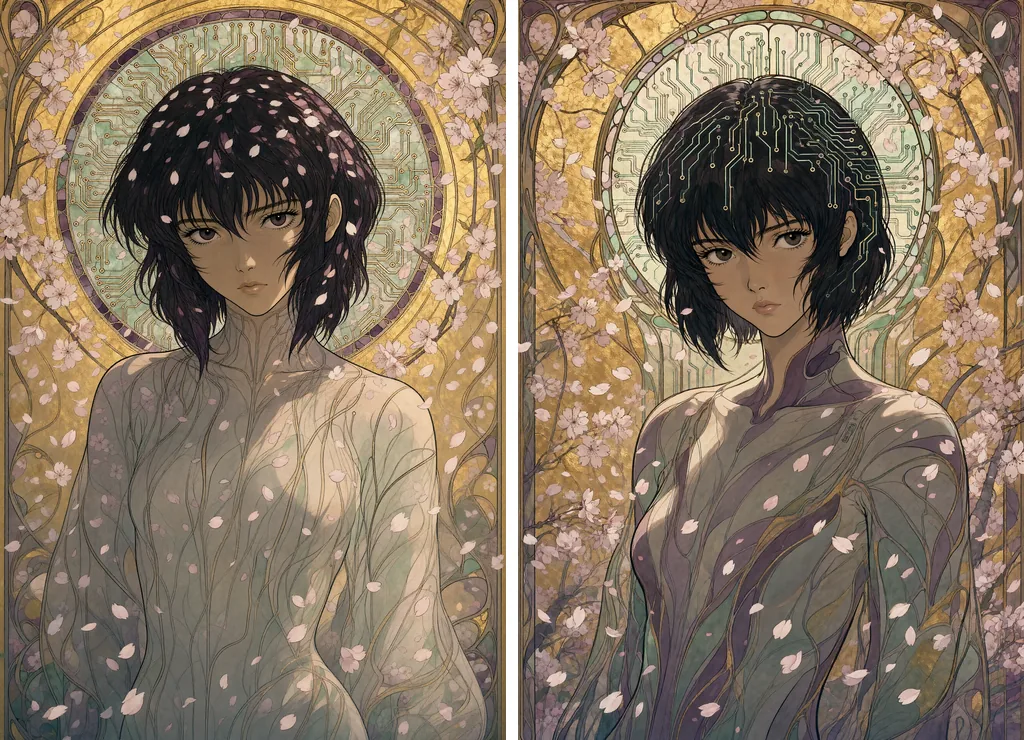
Temps mesurés avec CFG 3, APG et FreSca, poids int8, sur une seule carte grand public de 16 Go, en paysage ou dans l'équivalent portrait :
| Taille | Étapes | Temps par image |
|---|---|---|
| 1 mégapixel (1216 × 832) | 25 | environ 40 s |
| 2,5 mégapixels (1920 × 1312) | 20 | 120 à 135 s |
| 4 mégapixels (2432 × 1664) | 20 | 255 à 275 s |
| 4 mégapixels | 25 | 315 à 335 s |
À 2,5 mégapixels, le détail est un peu plus doux qu'à 4 quand on compare la même zone à 100 %. Mais le modèle suit le style du prompt au moins aussi bien, et parfois mieux sur les dix paires de test. Une broderie a montré ses points plus nettement à 2,5 mégapixels qu'à 4.
Pour une galerie servie en 1024 pixels, 2,5 mégapixels à 20 étapes est le bon compromis. Pour un tirage, 4 mégapixels à 20 étapes.
Accélérer : Turbo, Turbo guidé et le reste
Le Turbo. Qwen a publié Qwen-Image-2.1-Turbo le 9 octobre 2026. C'est un checkpoint distillé qui tourne en 8 étapes à CFG 1 avec une séquence de sigmas fixe. Comfy-Org le livre sous forme de fichier int8 et de LoRA pour le modèle de base, avec ses propres templates dans ComfyUI. Il a été mesuré le 17 octobre sur les dix mêmes seeds et tailles que les rendus à CFG 3 de ce guide, avec le graphe exact du template.
| Réglage | Temps par image |
|---|---|
| Checkpoint Turbo, 8 étapes, CFG 1, 1 mégapixel | 9 à 10 s |
| Checkpoint Turbo, 8 étapes, CFG 1, 4 mégapixels | 38 à 39 s |
| Turbo guidé, décrit plus bas : checkpoint Turbo, 8 étapes, CFG 3 avec APG et FreSca, 4 mégapixels | 66 à 71 s |
| Checkpoint de base plus LoRA Turbo, 8 étapes, CFG 1, 4 mégapixels | 52 à 55 s |
| Checkpoint de base, CFG 3, 20 étapes, 4 mégapixels | 255 à 275 s |
Sept fois plus rapide à 4 mégapixels, quatre fois à 1. Les images sont propres : nettes, bien éclairées, aucun accroc d'anatomie sur les dix seeds, lettrage correct sur les mêmes prompts que le modèle de base. Les objets du prompt sont là, parfois mieux qu'avec le modèle de base. La tortue dans sa voiture de course, que le modèle de base avait oubliée dans chaque rendu, est apparue avec le Turbo.
Ce qu'il perd, c'est le médium. Sur chaque prompt non photographique des dix seeds, le modèle distillé a glissé vers le réalisme photographique. Une broderie de crocodile est devenue une photo de crocodile. Un dessin au fusain a perdu son grain. Un Marvin the Martian en papier découpé s'est changé en figurine en vinyle. Les lettrages inventés sur les façades sont les mêmes qu'avec le modèle de base.
Sur les dix seeds, le LoRA sur le checkpoint de base a donné les mêmes images que le checkpoint Turbo, en plus lent. C'est donc le checkpoint qu'il faut télécharger. Une seed donne une autre image qu'avec le modèle de base, comme à tout changement de taille. La licence est la même : recherche et évaluation uniquement.
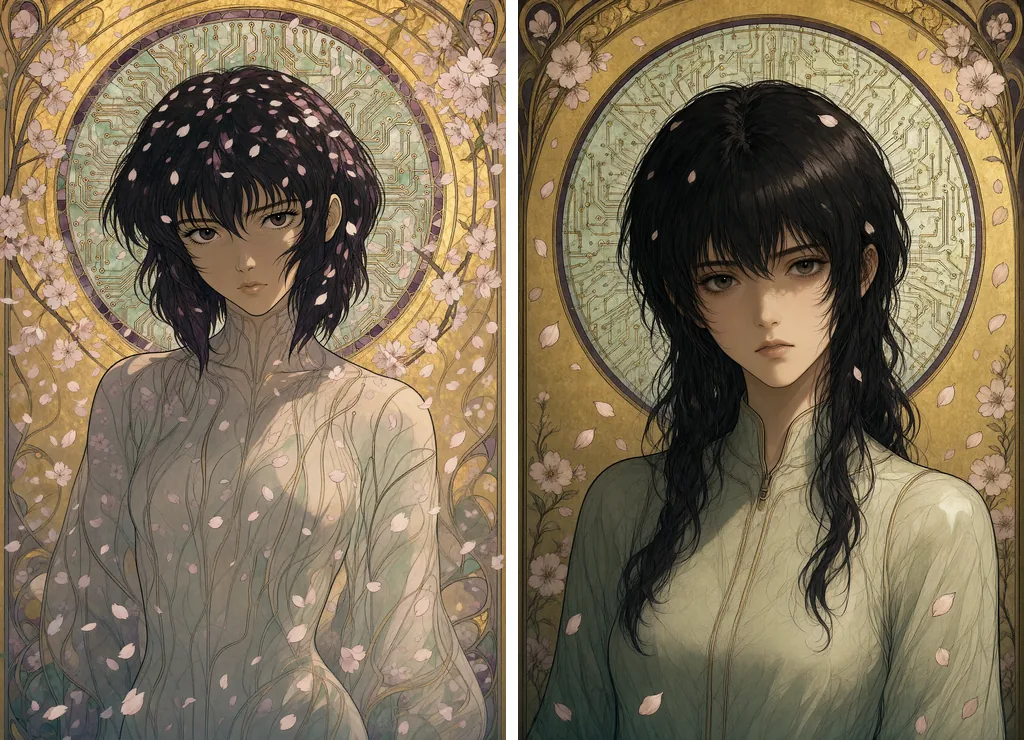
Le Turbo guidé. Le Turbo n'est pas verrouillé à CFG 1. Testé le 17 octobre 2026 sur les dix mêmes seeds plus l'illustration de ce guide. Gardez son checkpoint et ses 8 sigmas fixes, et ne prenez que le bloc de guidance du préréglage de base : CFG 3, le prompt négatif, APG puis FreSca.
Le graphe est le template Turbo lui-même. Réglez son CFGGuider à 3 au lieu de 1, remplissez le prompt négatif, et insérez APG puis FreSca sur le chemin du modèle entre le loader et le guider. Le nœud ManualSigmas et le sampler restent tels quels.
Le résultat garde la composition du Turbo et récupère ce que le CFG 1 avait aplati : le contraste, la saturation et le détail fin. Sur l'illustration de ce guide, les pistes de circuit de l'auréole reviennent nettes et dorées, et les pétales réapparaissent. Sur les dix seeds de test, les écailles, la fourrure et le gilet brodé se précisent de la même façon. Ce qu'il ne récupère pas, c'est le médium. La broderie reste une photo de crocodile.
Le coût est la seconde passe par étape : 66 à 71 secondes pour une image de 4 mégapixels contre 38 à 39. Cela reste presque quatre fois plus rapide que le modèle de base.
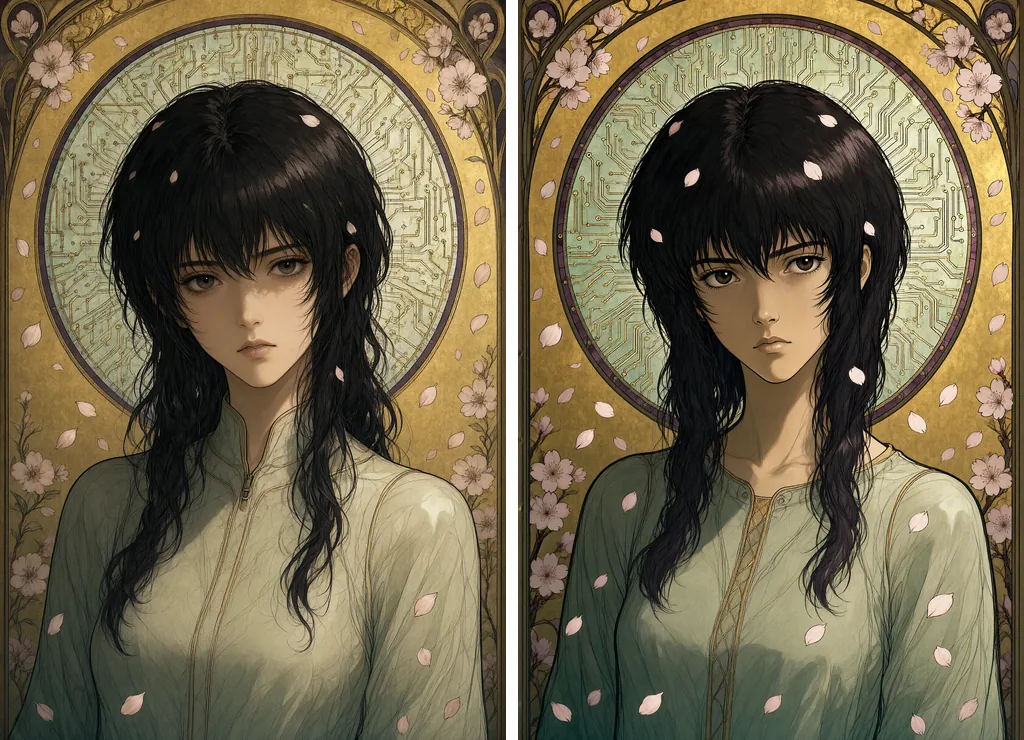
Téléchargez le workflow. Le workflow ComfyUI du Turbo guidé (JSON) rend cette illustration telle quelle : 1664 × 2432, seed 57658043, CFG 3 avec APG et FreSca, le prompt négatif de ce guide. Déposez le fichier dans ComfyUI ; il attend les trois fichiers de modèle nommés dans la dernière section. Libre de réutilisation sous CC BY 4.0, avec un lien vers cette page.
N'essayez pas d'aider le Turbo avec plus d'étapes. Avec 20 étapes et le scheduler simple à 4 mégapixels et CFG 3, comme s'il s'agissait du modèle de base, il surcuit : mèches de cheveux dures, auréole granuleuse, contraste poussé. Et il prend 169 secondes. Le checkpoint distillé veut ses 8 sigmas.
Une répartition raisonnable. Le Turbo simple comme mode brouillon, avec sept fois plus de candidats par heure pour le tri. Le Turbo guidé quand un prompt photographique ou au trait net a besoin de détail vite. Le modèle de base à CFG 3 pour tout ce qui est peint, dessiné ou artisanal, là où le médium lui-même est le sujet.
Les autres distillations. LightX2V a publié un LoRA Lightning en 4 étapes pour la 2.1 le 13 octobre 2026. Un LoRA communautaire en 8 étapes, Turbo8, existe aussi. Les deux tournent à CFG 1 comme le Turbo. Aucun des deux n'a été mesuré ici.
Le nœud de cache du préfixe. Le nœud QwenImage21Cache de ComfyUI ne fait que régler le périphérique et la précision du cache que le modèle garde déjà. Avec ses valeurs par défaut, il ne change rien. Son mode int8 divise le cache par deux, ce qui aide quand la mémoire manque en 2K ou en édition avec plusieurs images de référence. Aucune perte visible n'est venue avec lui dans ces tests.
Moins d'étapes. 16 étapes économisent environ un cinquième du temps, mais changent la composition et n'apportent aucune netteté de plus que 20. Si le temps est la contrainte, baissez la taille avant les étapes.
Faire tourner Qwen-Image 2.1 en local
ComfyUI prend le modèle en charge nativement. Trois fichiers vont dans les dossiers habituels : le modèle de diffusion dans diffusion_models, l'encodeur de texte Qwen3-VL dans text_encoders, le VAE dans vae.
Sur une carte de 16 Go, prenez les versions int8 publiées par Comfy-Org. Les poids bf16 fonctionnent aussi, mais ils débordent dans la mémoire système et prennent deux à six fois plus de temps sans gain visible.
Le graphe est court :
- UNETLoader, CLIPLoader avec le type
qwen_image, VAELoader ; - TextEncodeQwenImage21, qui prend le prompt et le prompt négatif ensemble et sort les deux conditionnements ;
- un latent vide à la taille choisie ;
- APG puis FreSca sur le chemin du modèle ;
- un KSampler à CFG 3 avec euler et le scheduler simple, puis VAEDecode.
Pour une image transparente, enveloppez le sujet dans la forme recommandée par la fiche du modèle : « This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent. » Enregistrez ensuite en PNG.
Mémoire : à 1 mégapixel, le modèle int8, l'encodeur et le VAE tournent dans 16 Go sans toucher à la mémoire système. ComfyUI décharge l'encodeur de la mémoire vidéo une fois le prompt encodé. À 4 mégapixels, le cache du préfixe a été réglé en int8, et la mémoire n'a jamais manqué. La première image d'une session prend plus longtemps, le temps que les fichiers se chargent.