Stable Diffusion โดยย่อ
Stable Diffusion คือ latent diffusion model (LDM) แบบโอเพนซอร์ส: โครงข่ายประสาทเทียมที่ถูกฝึกให้เปลี่ยนสัญญาณรบกวนแบบสุ่มให้กลายเป็นภาพทีละน้อย โดยมีข้อความเป็นตัวนำทาง พัฒนาโดยกลุ่ม CompVis แห่งมหาวิทยาลัย Ludwig Maximilian เมืองมิวนิก ร่วมกับ Runway และฝึกด้วยพลังประมวลผลจาก Stability AI บนภาพที่องค์กรไม่แสวงหากำไร LAION รวบรวมไว้ วิธีการมาจากบทความ High-Resolution Image Synthesis with Latent Diffusion Models (Rombach และคณะ, CVPR 2022)
weights ถูกเผยแพร่เมื่อ 22 สิงหาคม 2022 นั่นคือส่วนที่เปลี่ยนทุกอย่าง DALL-E 2 และ Midjourney มีอยู่แล้ว แต่ซ่อนอยู่หลังรายชื่อรอคิวและระบบเครดิต บนเซิร์ฟเวอร์ของคนอื่น ส่วน Stable Diffusion คือไฟล์ขนาด 4 GB ที่รันบนการ์ดจอหน่วยความจำ 8 GB ได้ ไม่ต้องมีบัญชี และมีตัวกรองความปลอดภัยที่ปิดเองได้
ภายในไม่กี่สัปดาห์ก็มีเว็บอินเทอร์เฟซและ inpainting ตามมาด้วยโมเดล fine-tune, LoRA และ ControlNet สี่ปีต่อมา ชื่อนี้มีสองความหมาย ในความหมายแคบคือตระกูลโมเดลตั้งแต่ 1.4 ถึง 3.5 ในความหมายกว้างคือแนวปฏิบัติทั้งหมดของการรันโมเดลสร้างภาพบนเครื่องของตัวเอง
เนื้อหาต่อจากนี้อธิบายตัวเครื่องจักรเอง ด้วยคำศัพท์ที่จะพบในทุกอินเทอร์เฟซ: latent space, VAE, U-Net, CLIP, sampler, guidance scale, seed ไม่ต้องใช้สูตร แต่ตัวเลขบางตัวช่วยได้
Stable Diffusion ทำงานอย่างไร? สามโครงข่ายกับหนึ่งลูป
Stable Diffusion ไม่ใช่โครงข่ายเดียว แต่เป็นสามโครงข่ายที่รันต่อกัน
- text encoder อ่าน prompt แล้วเปลี่ยนเป็นชุดตัวเลข ใน Stable Diffusion 1.5 คือ 77 token แต่ละ token อธิบายด้วยตัวเลข 768 ตัว ส่วน SDXL ซึ่งใช้ encoder สองตัวคือ 2,048 ตัว
- denoiser ซึ่งเป็น U-Net ในเวอร์ชัน 1 ถึง XL และเป็น transformer (MMDiT) ตั้งแต่เวอร์ชัน 3 เริ่มจากก้อนสัญญาณรบกวนแบบสุ่ม แล้วค่อย ๆ ลดสัญญาณรบกวนออกใน 20 ถึง 30 step โดยอ้างอิงตัวเลขจากข้อความทุก step มันไม่ได้ทำงานบนพิกเซล แต่ทำงานบนภาพฉบับย่อที่เรียกว่า latent ซึ่งอยู่ในสิ่งที่เรียกว่า latent space: ตัวเลข 4 × 64 × 64 ตัวสำหรับภาพ 512 พิกเซล และ 4 × 128 × 128 สำหรับ 1024 พิกเซลของ SDXL
- decoder เปลี่ยน latent นั้นให้เป็นค่าพิกเซลสุดท้าย คือแดง เขียว น้ำเงิน: 3 × 512 × 512 หรือ 3 × 1024 × 1024 สำหรับ SDXL
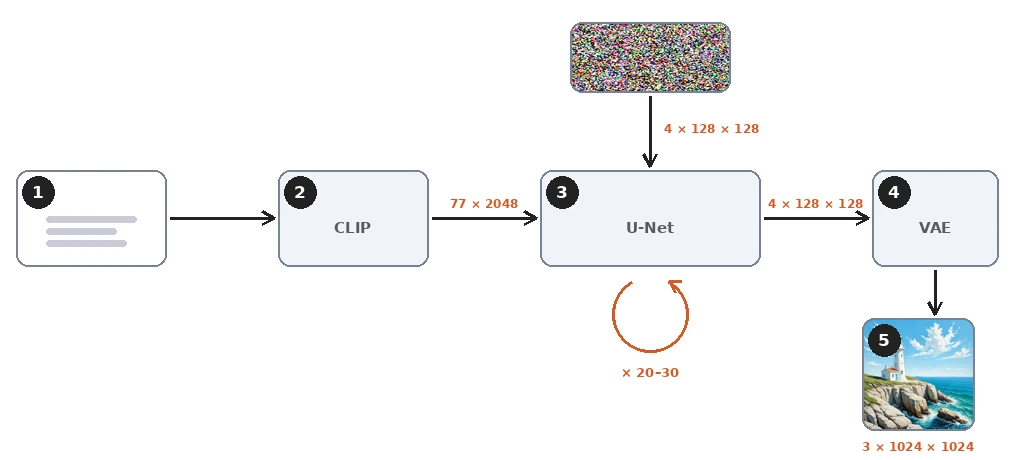
ไม่มีการค้นหาหรือคัดลอกอะไรระหว่างทาง ไม่มีฐานข้อมูลภาพอยู่ในไฟล์ weights ขนาด 2 ถึง 16 GB เก็บสิ่งที่โครงข่ายเรียนรู้ว่าคำบรรยายกับภาพสัมพันธ์กันอย่างไร และผลลัพธ์ทุกภาพคำนวณขึ้นจากสัญญาณรบกวน โครงข่ายยังอาจจำภาพที่ปรากฏหลายครั้งในการฝึกได้ และนักวิจัยสกัดภาพเหล่านั้นออกมาได้ไม่กี่ร้อยภาพ แต่นั่นคือข้อยกเว้น
Diffusion model คืออะไร? เรียนรู้การลบสัญญาณรบกวน
forward process: เติมสัญญาณรบกวน
แนวคิดของ diffusion อธิบายได้ง่าย หยิบภาพถ่ายพร้อมคำบรรยายมาหนึ่งภาพ เติมสัญญาณรบกวนแบบสุ่มในปริมาณที่กำหนด ให้โครงข่ายทายว่าสัญญาณรบกวนที่เติมเข้าไปคืออะไร โดยรู้คำบรรยาย เทียบคำตอบกับของจริง แล้วแก้โครงข่ายเล็กน้อย
การเติมสัญญาณรบกวนคือ forward process ซึ่งทำตาม schedule คงที่หนึ่งพันระดับ ตั้งแต่เม็ดจาง ๆ ที่ระดับ 50 ไปจนถึงภาพซ่าล้วน ๆ ที่ระดับ 999 โครงข่ายไม่เคยเห็น schedule นี้ไล่ไปทั้งชุด มันเห็นเพียงภาพที่มีสัญญาณรบกวนหนึ่งภาพที่หนึ่งระดับในแต่ละครั้ง
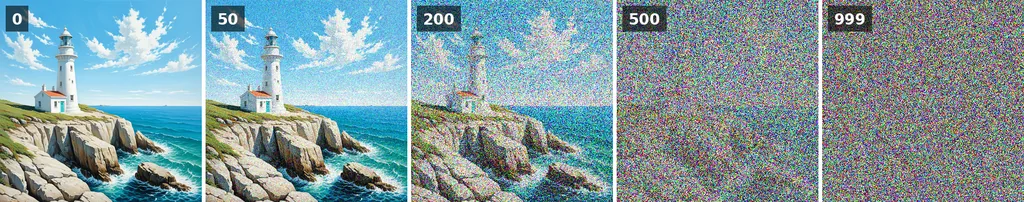
ทำแบบนี้กับตัวอย่างหลายพันล้านชิ้น ผลที่ได้คือ ตัวทำนายสัญญาณรบกวน: ให้ภาพที่มีสัญญาณรบกวน ระดับของมัน และข้อความ มันจะบอกว่าสัญญาณรบกวนน่าจะเป็นอะไร เป้าหมายการฝึกคือแค่ผลต่างระหว่างสัญญาณรบกวนที่ทำนายกับของจริง การฝึก Stable Diffusion 1 ใช้เวลาราว 150,000 ชั่วโมงบน GPU A100 ในศูนย์ข้อมูล ตามmodel card ของมัน
reverse process: ตัวทำนายสัญญาณรบกวนลงมือทำงาน
การสร้างภาพคือการย้อนกระบวนการเรียนรู้นั้นกลับ นั่นคือ reverse process เริ่มจากสัญญาณรบกวนล้วน ๆ ซึ่ง seed เป็นตัวกำหนด ถามตัวทำนายว่าสัญญาณรบกวนคืออะไร ลบออกส่วนหนึ่ง แล้วถามอีก DDPM บทความปี 2020 ที่ทำให้ diffusion ใช้งานได้จริง ทำแบบนี้ด้วย step เล็ก ๆ หนึ่งพันครั้ง
sampler ซึ่งบางอินเทอร์เฟซเรียกว่า scheduler คือกฎที่กำหนดว่าแต่ละ step ใหญ่แค่ไหน และจะเติมสัญญาณรบกวนใหม่กลับเข้าไปเล็กน้อยหรือไม่ sampler ที่ดีกว่าอย่าง DDIM, Euler และตระกูล DPM++ ก้าวยาวขึ้นบนเส้นทางเดียวกัน นี่คือเหตุผลที่ทุกวันนี้ 20 ถึง 30 step ก็เพียงพอ
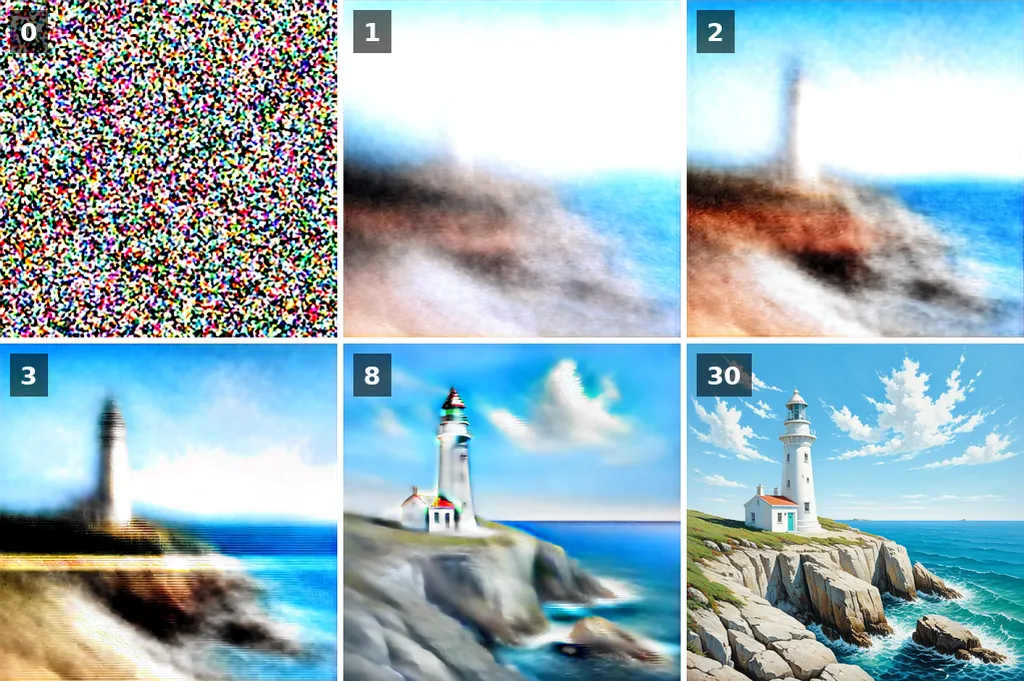
ภาพนี้แสดงส่วนที่ควรจำ ทุก step โมเดลมีภาพสำเร็จที่มันคาดเดาไว้ และการคาดเดานั้นนิ่งตั้งแต่ต้น สองสาม step แรก ขณะที่สัญญาณรบกวนยังหนัก กำหนดองค์ประกอบภาพ: เส้นขอบฟ้าอยู่ตรงไหน ประภาคารตั้งอยู่ตรงไหน ท้องฟ้ากินพื้นที่เท่าไร step หลัง ๆ ขัดเกลาพื้นผิวและรายละเอียดเล็ก ๆ
แถบเลื่อนด้านล่างไล่ดูการคาดเดาทั้งสามสิบครั้งของการสร้างภาพเดียวกัน
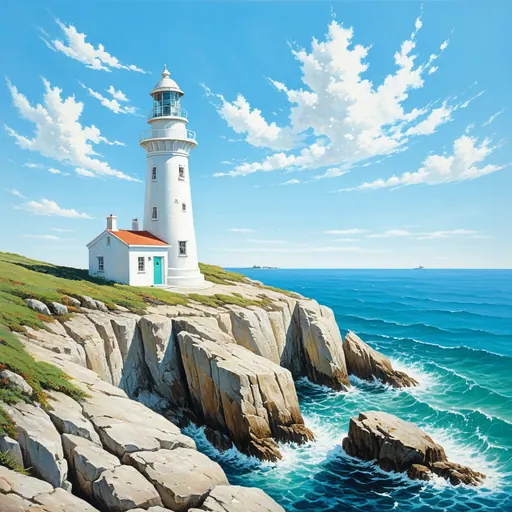
มีผลในทางปฏิบัติสองข้อตามมา การเปลี่ยนจำนวน step เปลี่ยนรายละเอียด และบางครั้งเปลี่ยนองค์ประกอบภาพด้วย เพราะ step แรก ๆ ไปตกที่ค่าอื่น มันไม่ได้แค่ทำให้ภาพเดิมคมขึ้น และ seed เดิมที่ขนาดภาพอื่นจะเริ่มจากก้อนสัญญาณรบกวนคนละก้อน จึงให้ภาพคนละภาพเช่นกัน เลือกขนาดก่อน แล้วค่อยหา seed
Latent diffusion: กลเม็ด VAE ที่ทำให้มันลงการ์ดจอเกมได้
diffusion model รุ่นก่อนหน้าทำงานบนพิกเซล ภาพ 512 × 512 คือตัวเลข 786,432 ตัว และตัวทำนายต้องอ่านและเขียนทั้งหมดนั้นในทุก step โมเดลแบบพิกเซลอย่าง DALL-E 2 และ Imagen เลี่ยงปัญหาด้วยการทำ diffusion ที่ 64 พิกเซลแล้วเพิ่มโครงข่ายขยายภาพ และอย่างไรก็ตาม โมเดลเหล่านั้นไม่เคยถูกเผยแพร่
Stable Diffusion เพิ่ม variational autoencoder หรือ VAE เข้ามา encoder ของมันบีบภาพลงแปดเท่าในแต่ละด้านให้เหลือสี่แชนเนล: 4 × 64 × 64 หรือตัวเลข 16,384 ตัว น้อยลง 48 เท่า diffusion ทำงานทั้งหมดในพื้นที่บีบอัดนั้น ซึ่งก็คือ latent space ท้ายที่สุดจริง ๆ decoder ของ VAE จึงขยายผลลัพธ์ออกเป็นพิกเซล

latent ไม่ใช่ภาพขนาดเล็ก สี่แชนเนลของมันคือรหัสที่ decoder รู้วิธีอ่าน และไม่มีแชนเนลใดที่ดูเหมือนภาพจริง ๆ แต่เค้าโครงรอดจากการบีบอัดมาได้ นั่นคือสิ่งที่ทำให้ denoiser ตัดสินองค์ประกอบภาพในพื้นที่เล็กขนาดนั้นได้
นี่คือเหตุผลที่การเลือก VAE มีผลต่อสีและรายละเอียดเล็ก ๆ ด้วย: ตัวเลขแต่ละตัวใน latent แทนพื้นที่ 8 × 8 พิกเซล และ decoder เป็นตัวสร้างสิ่งที่อยู่ภายในพื้นที่นั้นขึ้นเอง Stable Diffusion 3 เปลี่ยนไปใช้ latent 16 แชนเนลด้วยเหตุผลนี้เอง และรายละเอียดเล็ก ๆ กับตัวอักษรขนาดเล็กก็ดีขึ้นตาม
CLIP กับ cross-attention: ข้อความนำทางภาพอย่างไร
สามชิ้นส่วนเปลี่ยนคำให้เป็นทิศทางสำหรับ denoiser
tokenizer และ text encoder: CLIP อ่าน prompt อย่างไร
tokenizer ตัด prompt เป็น token คำทั่วไปเป็นคำเต็ม ส่วนคำที่พบน้อยกว่าถูกตัดเป็นชิ้น Stable Diffusion 1.5 และ SDXL อ่านได้มากสุด 77 token โดยสองตัวเป็นเครื่องหมายเริ่มและจบ คิดเป็นคำภาษาอังกฤษราว 50 ถึง 60 คำ เกินกว่านั้นข้อความจะถูกตัดทิ้ง เว้นแต่อินเทอร์เฟซจะแบ่งเป็นหลายรอบ ให้วางสิ่งที่สำคัญที่สุดไว้ต้น prompt
text encoder ของ 1.5 คือ CLIP โครงข่ายที่ OpenAI ฝึกบนคู่ภาพกับคำบรรยาย 400 ล้านคู่ ด้วยงานเดียว: ทำให้ตัวเลขที่อธิบายคำบรรยายเข้าใกล้ตัวเลขที่อธิบายภาพของมัน หลังการฝึกนั้น ตัวเลขของคำว่า "lighthouse" ก็บรรจุหน้าตาของประภาคารไว้แล้ว SDXL รัน encoder แบบนี้สองตัวคู่กัน ตัวที่สองเป็นเวอร์ชันเปิดที่ LAION ฝึกใหม่บนสองพันล้านคู่ Stable Diffusion 3 เพิ่มตัวที่สามคือ T5 ซึ่งอ่านทั้งประโยค
cross-attention ภายใน U-Net
cross-attention คือจุดที่ข้อความพบกับภาพ U-Net คือชุดบล็อก convolution ที่ซ้อนกัน ที่ย่อ latent ลงแล้วขยายกลับขึ้นมา โดยมี skip connection เชื่อมระหว่างขนาดที่ตรงกัน ระหว่างบล็อกเหล่านั้นมีชั้น attention แทรกอยู่ ทุก step แต่ละบริเวณของ latent จะมองเวกเตอร์ token ทั้ง 77 ตัว และให้น้ำหนักว่าตัวไหนเกี่ยวกับตัวเอง บริเวณท้องฟ้าสนใจ "sunset" และ "clouds" ส่วนหินสนใจ "cliff" นี่คือเหตุผลที่ลำดับคำ การซ้ำคำ และไวยากรณ์ถ่วงน้ำหนักของอินเทอร์เฟซต่าง ๆ มีผล และเหตุผลที่คำบอกสไตล์ที่อยู่ต้น prompt ย้อมทั้งภาพ
นี่คือข้อจำกัดของเวอร์ชันแรก ๆ ด้วย CLIP เรียนรู้จาก alt text สั้น ๆ มันจึงเข้าใจรายการของวัตถุและสไตล์ได้ดี แต่เข้าใจความสัมพันธ์ระหว่างสิ่งเหล่านั้นได้แย่ "A red cube on a blue sphere" (ลูกบาศก์สีแดงบนทรงกลมสีน้ำเงิน) มักออกมาสลับกันใน 1.5 คู่มือ prompt แสดงสิ่งที่ใช้ได้ผลอย่างสม่ำเสมอ
Guidance scale (CFG), negative prompt และ seed: การตั้งค่าสามอย่าง
การตั้งค่าสามอย่างปรากฏในทุกอินเทอร์เฟซของ Stable Diffusion และสอดคล้องโดยตรงกับกลไกข้างต้น
guidance scale ย่อมาจากการนำทางแบบไม่ใช้ตัวจำแนก (classifier-free guidance หรือ CFG) คือค่าที่กำหนดว่าจะผลักข้อความแรงแค่ไหน ในแต่ละ step denoiser ทำนายจริง ๆ สองครั้ง: ครั้งหนึ่งกับ prompt และอีกครั้งกับ prompt ว่าง ผลต่างระหว่างสองครั้งคือทิศทางที่ prompt ให้ การทำนายสุดท้ายคือการทำนายแบบว่าง บวกผลต่างนั้นคูณด้วย guidance scale ที่ 1 การทำนายที่มี prompt ถูกใช้ตามเดิมโดยไม่มีแรงผลัก: ภาพตามข้อความแบบหลวม ๆ สีหม่น และท้องฟ้าเป็นสีเทาทั้งที่ prompt ขอสีฟ้า ราว 5 ถึง 8 ภาพตาม prompt อย่างใกล้ชิดด้วยสีธรรมชาติ เกิน 12 คอนทราสต์แข็งขึ้น สีอิ่มจัด และฝีแปรงกระด้าง
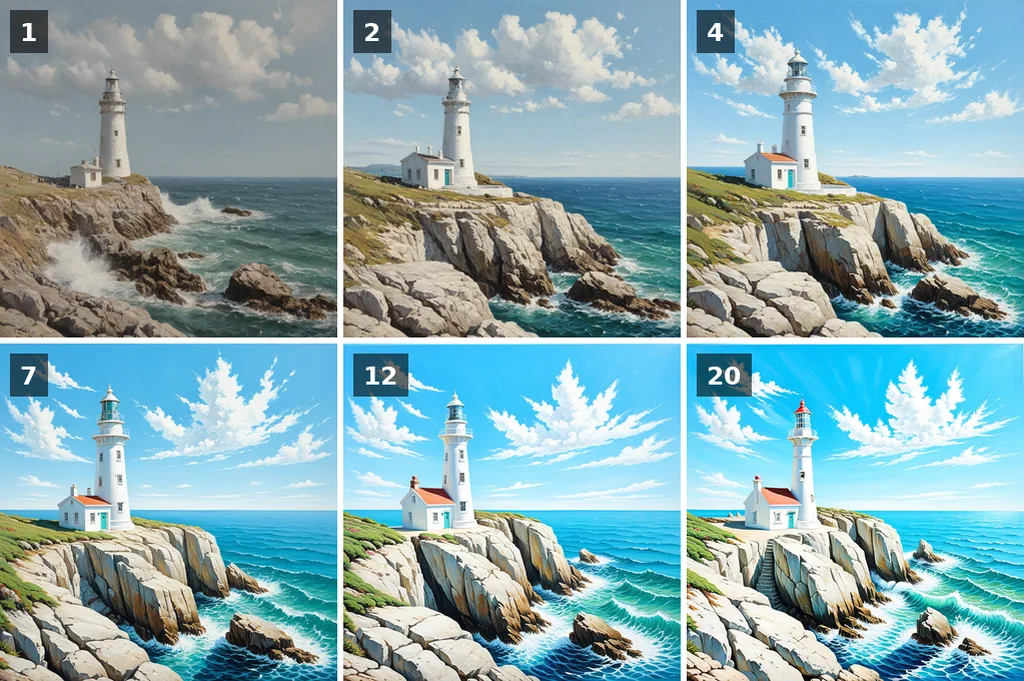
negative prompt เข้าแทนที่ prompt ว่างของการทำนายครั้งที่สอง แทนที่จะอ่านอะไรเลย รอบที่สองอ่าน "blurry, text, watermark" และ guidance ก็ผลักออกห่างจากมัน ไม่มีต้นทุนเพิ่ม เพราะรอบที่สองรันอยู่แล้ว และมันทำงานเฉพาะเมื่อ guidance สูงกว่า 1 คู่มือ negative prompt มีรายการที่ใช้ได้จริง
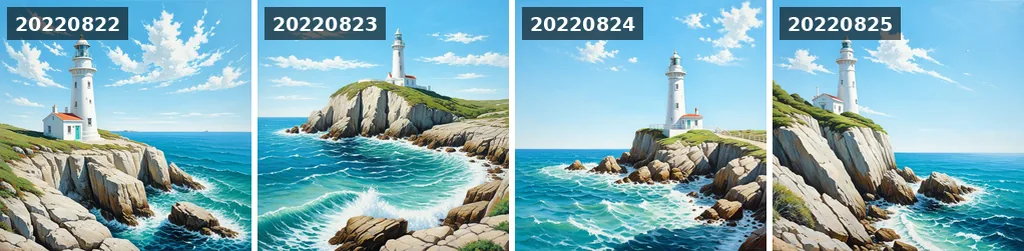
seed คือตัวเลขที่สร้างสัญญาณรบกวนเริ่มต้น seed เดิม prompt เดิม การตั้งค่าเดิม และโมเดลเดิม ให้ภาพเดิมทุกพิกเซลบนซอฟต์แวร์และฮาร์ดแวร์เดียวกัน อินเทอร์เฟซอื่นหรือการ์ดจออื่นสุ่มสัญญาณรบกวนต่างกัน เปลี่ยน seed แล้วองค์ประกอบภาพเปลี่ยน เพราะ step แรก ๆ อ่านก้อนสัญญาณรบกวนคนละก้อน เปลี่ยน prompt หนึ่งคำแต่คง seed ไว้ ภาพส่วนใหญ่มักคงเดิม นี่คือวิธีขัดเกลา prompt
จาก U-Net สู่ transformer: เวอร์ชัน 1.5 ถึง 3.5
หกรุ่นหลักออกมาในสองปี สองรุ่นแรกจาก CompVis และ Runway ที่เหลือจาก Stability AI แต่ละรุ่นเปลี่ยนโครงข่ายอย่างน้อยหนึ่งในสาม
| เวอร์ชัน | วันที่ | denoiser | text encoder | ขนาดพื้นฐาน |
|---|---|---|---|---|
| 1.4 และ 1.5 | สิงหาคมและตุลาคม 2022 | U-Net, พารามิเตอร์ 860 ล้าน | CLIP ViT-L | 512 px |
| 2.0 และ 2.1 | พฤศจิกายนและธันวาคม 2022 | U-Net แบบเดียวกัน ฝึกใหม่ตั้งแต่ต้น | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | กรกฎาคม 2023 | U-Net, 2.6 พันล้าน บวก refiner | CLIP ViT-L และ OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | พฤศจิกายน 2023 | SDXL ที่กลั่นให้เหลือ 1 ถึง 4 step | เหมือน SDXL | 512 px |
| 3 Medium | มิถุนายน 2024 | diffusion transformer (MMDiT), 2 พันล้าน | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | ตุลาคม 2024 | MMDiT, 8 พันล้าน; Medium 2.5 พันล้าน | สามตัวเดิม | 1024 px |
1.5 ยังคงเป็นหนึ่งในโมเดลที่ถูก fine-tune มากที่สุดเท่าที่มี มี checkpoint และ LoRA จากชุมชนหลายหมื่นตัว และยังรันบน VRAM 4 GB ได้ SDXL คือตัวหลักที่ใช้งานจริง: มือ ใบหน้า และองค์ประกอบภาพดีขึ้น และให้ภาพ 1024 พิกเซลโดยตรง 3 และ 3.5 แทนที่ U-Net ด้วย transformer ที่จัดการ token ของข้อความและภาพไปพร้อมกัน ซึ่งในที่สุดก็ทำให้ตัวอักษรที่อ่านออกในภาพเป็นไปได้: ใส่คำนั้นในเครื่องหมายคำพูดใน prompt การเปรียบเทียบ SDXL กับ Stable Diffusion 3 แสดง prompt เดียวกันบนทั้งสองโมเดล
ไลเซนส์ก็เปลี่ยนไปด้วย 1.5 อยู่ใต้ ไลเซนส์ CreativeML OpenRAIL-M และ SDXL อยู่ใต้ OpenRAIL++-M ทั้งคู่ใช้เชิงพาณิชย์ได้ฟรีโดยมีรายการการใช้งานที่ห้าม ส่วนโมเดล 3.x อยู่ใต้ Stability AI Community License ซึ่งฟรีเมื่อรายได้ต่อปีต่ำกว่าหนึ่งล้านดอลลาร์
ใช้ทำอะไรได้บ้าง: image-to-image, inpainting, ControlNet, LoRA
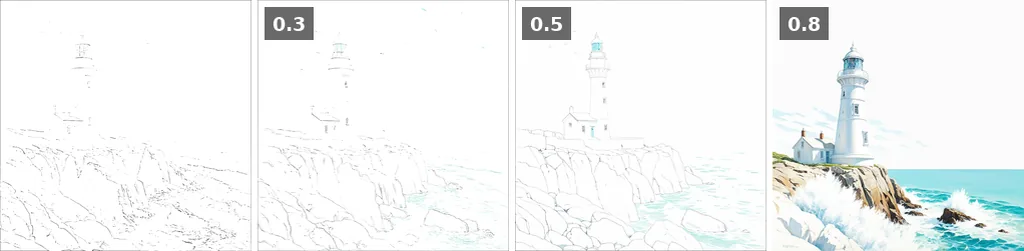
การสร้างภาพจากข้อความเป็นแค่จุดเริ่มต้น เพราะทุกชิ้นส่วนของ pipeline นำกลับมาใช้ได้ เข้ารหัสภาพร่างเป็น latent เติมสัญญาณรบกวนเพียงบางส่วน แล้วลดสัญญาณรบกวนจากตรงนั้น ก็ได้ image-to-image หรือ img2img ในอินเทอร์เฟซ: ค่า strength หรือ denoise คือปริมาณสัญญาณรบกวนที่เติม แนวคิดนี้มาจาก SDEdit ปิด mask บริเวณหนึ่งของ latent ก็ได้ inpainting หรือ outpainting เมื่อ mask อยู่นอกกรอบภาพ เพิ่มโครงข่ายเสริมเล็ก ๆ ที่อ่านท่าทาง แผนที่ความลึก หรือเส้นขอบ ก็ได้ ControlNet ฝึก weights เพิ่มไม่กี่ล้านตัวบนภาพถ่ายยี่สิบภาพ ก็ได้ LoRA ที่สอนโมเดลให้รู้จักใบหน้าหรือสไตล์ ส่วนการขยายภาพเป็นหน้าที่ของโมเดล super-resolution เฉพาะทาง
ถ้าจะรันเอง การ์ด NVIDIA รุ่นใหม่ที่มีหน่วยความจำ (VRAM) 6 GB ก็พอสำหรับ 1.5 และ 8 GB สำหรับ SDXL การ์ด AMD ใช้ได้ผ่าน ROCm ส่วน Apple Silicon ผ่าน MPS backend คู่มือติดตั้งครอบคลุมอินเทอร์เฟซหลักทั้งสาม ถ้าไม่มีการ์ดจอ เครื่องมือบนเว็บไซต์นี้ไม่ต้องใช้ฮาร์ดแวร์เลย: Stable Diffusion XL และ Stable Diffusion 1.5 รันบน GPU ของเว็บไซต์เอง แสดงคิวแบบสด prompt พร้อมคำอธิบายแสดงว่าแต่ละการตั้งค่าทำอะไร และสไตล์ศิลปิน 1,731 คนแสดงว่าโมเดลเรียนรู้อะไรเกี่ยวกับจิตรกร
Stable Diffusion vs Midjourney vs DALL-E
เทียบกับ Midjourney และโมเดลภาพของ OpenAI ความต่างไม่ใช่คุณภาพแต่คือการควบคุม weights เป็นสาธารณะและโมเดลรันในเครื่อง: ภาพของคุณอยู่ในดิสก์ของคุณ คุณเลือกโมเดล คุณกำหนด seed และคุณเปลี่ยนชิ้นส่วนไหนก็ได้ แลกกับการที่มันเรียกร้องจากคุณมากกว่า Midjourney ขอแค่หนึ่งประโยคแล้วให้ภาพที่เสร็จสวยงามแล้ว ส่วน Stable Diffusion ขอโมเดล, prompt, negative prompt และ guidance scale แล้วให้สิ่งที่คุณตั้งไว้เป๊ะ ๆ
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| weights | สาธารณะ ดาวน์โหลดได้ | ปิด | ปิด |
| รันบนคอมพิวเตอร์ของคุณ | ได้ VRAM 6 ถึง 8 GB | ไม่ได้ | ไม่ได้ |
| ราคา | ฟรีในเครื่อง มีเครื่องมือฟรีออนไลน์ | สมัครสมาชิก | สมัครสมาชิกหรือจ่ายต่อภาพ |
| การควบคุม | seed, โมเดล, LoRA, ControlNet, inpainting, การตั้งค่าทุกอย่าง | พารามิเตอร์และภาพอ้างอิงสไตล์ | การสนทนา |
| fine-tune | ได้ ใครก็ได้ | ไม่ได้ | ไม่ได้ |
| ตัวอักษรในภาพ | อ่อนก่อน 3 ดีตั้งแต่ 3.5 | ดีตั้งแต่ v6 | ดีมาก |
หลักการ diffusion เดียวกันตอนนี้ขับเคลื่อนโมเดลจากห้องแล็บอื่นด้วย โดยมี encoder อื่นและไลเซนส์อื่น: FLUX จาก Black Forest Labs ซึ่งก่อตั้งโดยผู้สร้าง Stable Diffusion รุ่นแรก และ Qwen-Image จาก Alibaba โมเดลเหล่านี้รันในอินเทอร์เฟซเดียวกัน ด้วย seed, step และ sampler แบบเดียวกัน เนื้อหาส่วนใหญ่ของหน้านี้จึงใช้ได้ guidance ของมันทำงานต่างออกไป FLUX dev ไม่มี negative prompt และพวกมันชอบประโยคเต็มมากกว่ารายการคำสำคัญ
แหล่งอ้างอิง และวิธีนำภาพไปใช้ซ้ำ
แหล่งอ้างอิงหลัก ตามลำดับที่ปรากฏในหน้านี้:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach และคณะ, 2022: บทความของ Stable Diffusion
- Denoising Diffusion Probabilistic Models, Ho และคณะ, 2020: forward และ reverse process กับ schedule หนึ่งพัน step
- Learning Transferable Visual Models From Natural Language Supervision, Radford และคณะ, 2021: CLIP
- Classifier-Free Diffusion Guidance, Ho และ Salimans, 2022: guidance scale
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023 และ Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL และ Stable Diffusion 3
การนำภาพไปใช้ซ้ำ ภาพที่สร้างและแผนภาพในหน้านี้เผยแพร่ภายใต้ CC BY 4.0: นำไปใช้ในการสอน การบรรยาย หรือบทความได้ โดยใส่ลิงก์มายังหน้านี้ ภาพทุกภาพใช้ Stable Diffusion XL, euler, 30 step, CFG 6, seed 20220822, prompt ด้านล่าง และ negative prompt "text, watermark, signature, blurry, low quality, storm, dark clouds, sunset"
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesการอ้างอิงหน้านี้
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion