Trí tuệ nhân tạo Stable Diffusion trực tuyến
Trí tuệ nhân tạo miễn phí cho mọi người
Tạo hình ảnh AI miễn phí, trực tiếp trong trình duyệt.
Nhập một prompt. Công cụ của chúng tôi tạo ra hình ảnh độc đáo trong vài giây. Không cần tài khoản, GPU hay cài đặt.
Công cụ tạo hình ảnh miễn phí trực tuyến
 Stable Diffusion 3
Tạo ảnh từ văn bản với Stable Diffusion 3, không cần tài khoản
 Inpainting Phổ biến
Vẽ lại bất kỳ phần nào của ảnh từ một prompt văn bản
 Upscaling Phổ biến
Phóng to ảnh tới 2x với chi tiết sắc nét hơn
 Stable Diffusion XL demo
Demo trực tuyến miễn phí Stable Diffusion XL 1.0, không cần tài khoản
Bộ công cụ trí tuệ nhân tạo và LLM miễn phí:
Tác phẩm nghệ thuật từ Cộng đồng
 anime style a bike ride on a levee at a homecoming
 an isometric 3d render of a tiny city block with a caf a park a bus stop and little people lit from the top
 a chalk drawing of stilgar painting a sunset that moves at blue hour lit by storm light from above with long
 a photograph of a man in a business suit asleep in a hammock strung between two parking meters on a sunny
 an origami of reptar lit by firelight from the front with long shadows the subject is at the edge of the
 an elven city built into giant trees with bridges of light dawn mist fantasy concept painting
 the mekong delta mughal miniature just before the storm
 anime style a first snow walk on a rainy sunday
 the image is a fauvist painting of snape at blue hour the scene takes place during a mackerel sky the scene
 a science fiction book cover the title the last signal is at the top centre in bold condensed white letters
 a bicycle helmet gongbi painting
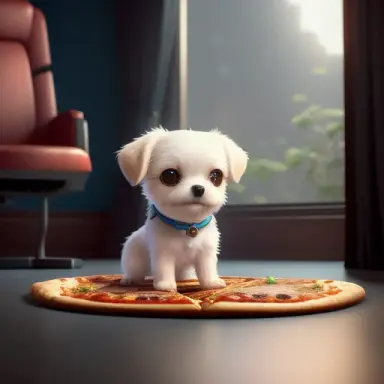 Cute small dog sitting in a movie theater eating pizza watching a movie ,unreal engine, cozy indoor lighting, artstation, detail
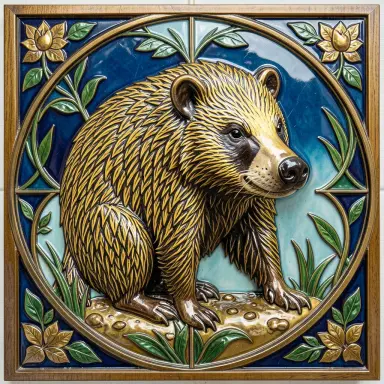 cloisonn of a honey badger
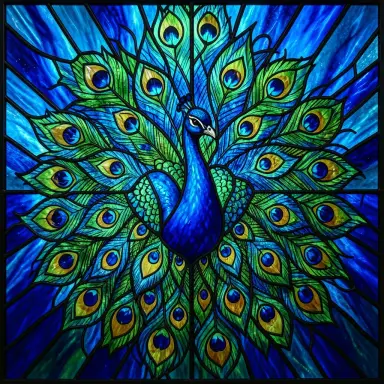 stained glass style illustration of a peacock deep blues and greens bold black leading
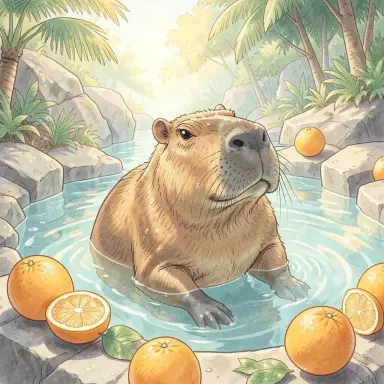 a capybara in a hot spring with oranges illustration
 anime background painting of a train crossing a bridge over a river in spring cherry petals in the air soft
 photograph of a sea otter floating on its back holding a shell calm kelp bay soft morning light
 a photograph of a tightrope walker crossing between two palm trees above a sunlit beach carrying a tray with
 crochet of a greylag goose
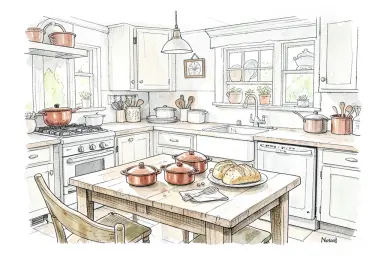 ink line drawing with light watercolor of a rustic farmhouse kitchen copper pots bread on the table
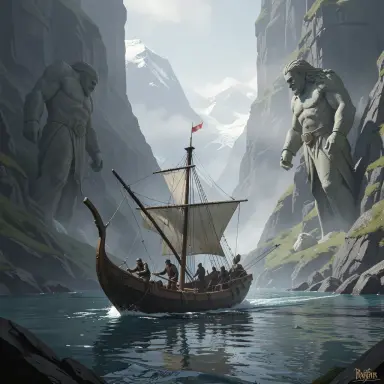 viking longship sailing into a fjord guarded by colossal stone statues matte painting style
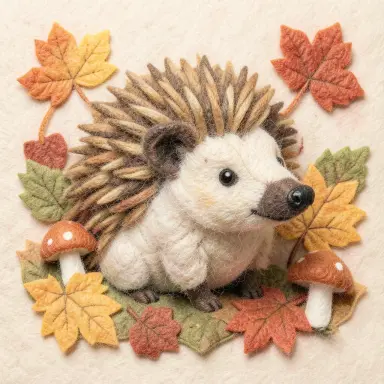 felt craft illustration of a hedgehog among autumn leaves and mushrooms soft wool texture
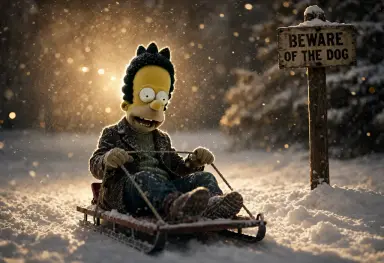 the image is a tintype of sideshow bob sledging the scene is set in a blizzard lit by backlight from behind
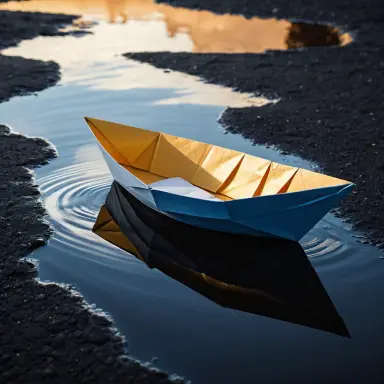 photograph of a paper boat floating on a puddle reflecting the sky close up ultra detailed dramatic lighting
Stable Diffusion là gì?
Stable Diffusion là AI tạo ảnh từ văn bản. Gõ điều bạn muốn — nó sẽ tạo ảnh.
Được phát triển bởi StabilityAI , là mã nguồn mở. Chạy trên GPU thông thường — không cần đám mây. Cộng đồng rất năng động. Nhiều mô hình và tiện ích bổ sung miễn phí. Bạn thậm chí có thể huấn luyện nó trên ảnh của mình!
Nó được huấn luyện trên hàng triệu ảnh. Dùng để tạo nghệ thuật số, chỉnh sửa ảnh, hoạt ảnh và nhiều hơn nữa.
Bạn có thể xem các ví dụ trong thư viện lời nhắc, Thư viện Nghệ thuật và trình duyệt hình ảnh..Câu hỏi thường gặp
Stable Diffusion có miễn phí không?
Có. Stable Diffusion là mô hình mã nguồn mở, có thể tải về và chạy miễn phí trên máy tính của bạn. Mọi công cụ trên trang này cũng miễn phí: các bản demo trực tuyến, inpainting, phóng to ảnh và trình tạo prompt không cần tài khoản, còn tạo ảnh từ văn bản trên GPU riêng của chúng tôi chỉ cần một tài khoản miễn phí. Không tín dụng, không thuê bao.
Tôi có cần tài khoản để tạo ảnh không?
Không cần tài khoản cho các bản demo trực tuyến, inpainting, phóng to ảnh và trình tạo prompt: chỉ cần mở trang và bắt đầu. Một tài khoản miễn phí, tạo bằng địa chỉ e-mail, mở khóa tính năng tạo ảnh từ văn bản trên GPU riêng của chúng tôi với Stable Diffusion 1.5 và SDXL 1.0, với toàn quyền điều chỉnh số bước, thang CFG, seed và kích thước ảnh.
Làm thế nào để dùng Stable Diffusion trực tuyến?
Mở bản demo miễn phí, nhập mô tả hình ảnh bạn muốn rồi nhấp Generate. Hình ảnh xuất hiện sau vài giây và bạn có thể tải về. Để cải thiện kết quả, hãy thêm chi tiết về phong cách và ánh sáng, viết prompt âm hoặc đổi seed để khám phá các biến thể. Không cần cài đặt gì cả.
Đây có phải là trang web chính thức của Stable Diffusion không?
Không. Stable Diffusion do Stability AI phát triển, trang web chính thức của họ là stability.ai. stablediffusion.fr là một trang độc lập, hoạt động từ năm 2022, cung cấp các công cụ miễn phí để dùng Stable Diffusion và các mô hình mở khác ngay trên trình duyệt, cùng với hướng dẫn, ví dụ prompt và tài liệu tham khảo về nghệ sĩ. Trang không liên kết với Stability AI.
Lời nhắc là gì?
Prompt là mô tả văn bản hướng dẫn AI. Nó có thể bao gồm chủ đề, phong cách nghệ thuật, ánh sáng, tâm trạng và phương tiện — ví dụ: 'một hiệp sĩ thời trung cổ trong khu rừng tối, tranh sơn dầu, ánh sáng kịch tính, điện ảnh'. Prompt càng cụ thể, kết quả càng gần với tầm nhìn của bạn. Giữ nó dưới 350 ký tự để có kết quả tốt nhất.
Prompt âm cho AI biết những gì không nên có trong ảnh.
Đọc hướng dẫn đầy đủ: Viết prompt Stable Diffusion như thế nào? →
Prompt âm là gì?
Prompt âm cho AI biết điều gì KHÔNG được hiển thị. Ví dụ phổ biến: 'blurry, low quality, watermark, text, deformed hands'. Dùng chúng để loại bỏ lỗi AI thường gặp.
Prompt âm nhanh chóng cải thiện chất lượng ảnh. Thêm trọng số — như '(blurry:1.4)' — để làm chúng mạnh hơn.
Hạt giống có nghĩa là gì?
Seed là một số khởi tạo quá trình ngẫu nhiên đằng sau việc tạo hình ảnh. Mỗi hình ảnh bắt đầu từ nhiễu, và seed xác định nhiễu ban đầu trông như thế nào. Để -1 để nhận seed ngẫu nhiên — và hình ảnh khác nhau — mỗi lần.
Cố định seed để tái tạo chính xác cùng một hình ảnh. Điều này hữu ích cho thử nghiệm: giữ seed không đổi trong khi chỉ thay đổi prompt hoặc cài đặt để so sánh các biến thể một cách chính xác. Đây cũng là cách tái tạo một kết quả yêu thích sau này.
Đọc hướng dẫn đầy đủ: Seed trong Stable Diffusion dùng để làm gì? →
LoRA là gì?
LoRA viết tắt của Low-Rank Adaptation. Đây là một tệp bổ sung nhỏ (thường 50–150 MB) tinh chỉnh mô hình cơ sở cho một phong cách, nhân vật hoặc chủ đề cụ thể — mà không cần đào tạo lại toàn bộ mô hình.
Tải LoRA để tạo hình ảnh theo phong cách nghệ thuật cụ thể, tái tạo nhân vật cụ thể hoặc khớp với một khái niệm tham chiếu. Bạn có thể kết hợp nhiều LoRA trong một prompt bằng cách sử dụng trọng số: <lora:my-style:0.8>. Hàng nghìn LoRA miễn phí có sẵn trên Civitai và Hugging Face.
Cách cài đặt Stable Diffusion cục bộ?
Chạy Stable Diffusion cục bộ yêu cầu GPU NVIDIA gần đây với ít nhất 6 GB VRAM. GPU AMD hoạt động với driver ROCm trên Linux. Apple Silicon (M1/M2/M3) cũng được hỗ trợ qua backend MPS. Nếu bạn không có GPU tương thích, công cụ trực tuyến miễn phí của chúng tôi chạy trực tiếp trong trình duyệt — không cần cài đặt.
Đầu tiên, tải base model và refiner từ Stability AI.Tiếp theo, cài Python 3.10 và Git.
Tải webUI từ Automatic1111.
Đặt cả hai mô hình vào thư mục models/Stable-diffusion .
Tìmwebui.bat và nhấp đúp để cài đặt.
Mở trình duyệt tại localhost:7860.
Đọc hướng dẫn đầy đủ: Cài đặt Stable Diffusion trên máy tính như thế nào? →
Cần bao nhiêu VRAM cho Stable Diffusion?
Bạn cần ít nhất 4 GB VRAM để chạy Stable Diffusion. 6 GB là mức tối thiểu được khuyến nghị cho mô hình SDXL. Với 8 GB trở lên, bạn có thể tạo ảnh lớn hơn và dùng nhiều tính năng hơn.
Không có GPU vẫn có thể chạy trên CPU, nhưng chậm hơn nhiều. Bạn cũng có thể dùng demo trực tuyến miễn phí của chúng tôi mà không cần GPU.
Img2img là gì?
Img2img cho phép dùng ảnh hiện có làm điểm xuất phát. Bạn cung cấp ảnh gốc và prompt. Stable Diffusion sẽ biến đổi ảnh theo hướng dẫn của bạn.
Dùng để thay đổi phong cách ảnh, sửa ảnh đã tạo, hoặc hoàn thiện phác thảo. Denoising strength kiểm soát mức độ AI thay đổi ảnh gốc.
Tôi có thể dùng ảnh Stable Diffusion cho mục đích thương mại không?
Điều này phụ thuộc vào mô hình. Các mô hình Stable Diffusion cơ sở dùng giấy phép CreativeML Open RAIL-M. Giấy phép này cho phép sử dụng thương mại, nhưng có hạn chế — không được dùng ảnh để gây hại hoặc lừa dối người khác.
Luôn kiểm tra giấy phép của checkpoint bạn sử dụng. Một số mô hình cộng đồng hạn chế dùng thương mại. Nếu bán hoặc công bố ảnh AI, hãy lưu lại thông tin mô hình và giấy phép.
ControlNet là gì?
ControlNet là tiện ích mở rộng của Stable Diffusion giúp bạn kiểm soát chính xác bố cục ảnh. Bạn cung cấp ảnh tham chiếu — tư thế, bản đồ cạnh hoặc bản đồ độ sâu — và AI sẽ theo cấu trúc đó.
Dùng ControlNet để giữ nguyên tư thế chính xác, sao chép bố cục cảnh hoặc phác thảo chính xác. Nó hoạt động cùng prompt để kiểm soát cả nội dung lẫn cấu trúc ảnh.
Checkpoint là gì?
Checkpoint là một file mô hình AI đã lưu. Nó chứa mọi thứ mô hình học được trong quá trình huấn luyện. Bạn tải checkpoint để xác định phong cách và chủ đề hình ảnh.
Các checkpoint khác nhau cho kết quả rất khác nhau. Một số được huấn luyện cho ảnh thực tế, số khác cho anime hoặc minh họa. Bạn có thể tải checkpoint miễn phí từ Hugging Face hoặc Civitai.
ComfyUI là gì?
ComfyUI là giao diện miễn phí dựa trên nút cho Stable Diffusion. Bạn xây dựng quy trình ảnh bằng cách kết nối các khối gọi là nút. Mỗi nút thực hiện một bước — tải mô hình, thêm prompt hoặc lưu ảnh.
ComfyUI cho bạn kiểm soát hoàn toàn từng bước. Nó nhanh và nhẹ hơn Automatic1111. Người dùng nâng cao ưa dùng cho quy trình phức tạp. Bạn có thể chia sẻ quy trình dưới dạng file JSON.
Flux là gì?
Flux là họ mô hình tạo ảnh từ văn bản của Black Forest Labs, được thành lập bởi các nhà nghiên cứu cũ của Stability AI. Bản trọng số mở mới nhất là FLUX 3 Image Klein, phát hành ngày 15 tháng 10 năm 2026: 5,6 tỷ tham số, tạo ảnh 4K gốc, chỉnh sửa từ tối đa mười ảnh tham chiếu và một bản int8 chạy được trên card đồ họa 8 GB.
FLUX 3 Image Klein được phát hành theo FLUX Kommunity License: miễn phí sử dụng thương mại cho cá nhân và công ty có doanh thu hằng năm dưới 5 triệu đô la; tổ chức lớn hơn cần giấy phép thương mại từ Black Forest Labs. FLUX.2, phát hành tháng 11 năm 2025, vẫn đang hiện hành với năm biến thể: ba bản chạy trên máy chủ của hãng là [max], [pro] và [flex], cùng hai bản trọng số mở là [dev] và [klein]. Bản demo của trang này chạy FLUX.2 [dev], còn trang phong cách nghệ thuật được dựng bằng FLUX.2 [klein].
Qwen-Image 2.1 là gì?
Qwen-Image 2.1 là mô hình trọng số mở tạo ảnh từ văn bản và chỉnh sửa ảnh của nhóm Qwen (Alibaba), phát hành tháng 9 năm 2026. Nó bám theo trọn câu thay vì danh sách từ khóa, viết chữ rõ ràng trong ảnh và tạo ảnh 2K gốc, 2048 × 2048 cho ảnh vuông, không cần upscaler. Khi chỉnh sửa, nó nhận một câu cùng tối đa mười ảnh tham chiếu.
Bạn có thể dùng thử miễn phí trên bản demo Qwen-Image 2.1 của trang này, không cần tài khoản. Nó chạy tại nhà trong ComfyUI; trọng số int8 vừa với card đồ họa 16 GB. Trọng số được phát hành theo Qwen Research License: chỉ dành cho nghiên cứu và đánh giá, mọi mục đích thương mại đều cần một giấy phép riêng từ Qwen. Qwen-Image đầu tiên, phát hành tháng 8 năm 2025, theo Apache 2.0.
Đọc hướng dẫn đầy đủ: Qwen-Image là gì, làm được gì và hoạt động ra sao →
Phiên bản mới nhất của Stable Diffusion là gì?
Phiên bản mới nhất là Stable Diffusion 3.5 , phát hành vào tháng 10 năm 2024. Tạo ra hình ảnh sắc nét hơn với khả năng hiển thị văn bản tốt hơn đáng kể, màu sắc phong phú hơn và chi tiết tinh tế được cải thiện. Có ba kích thước: Large (8B tham số), Large Turbo cho tạo nhanh và Medium — tất cả đều có thể chạy cục bộ với VRAM vừa phải.
Đọc hướng dẫn đầy đủ: SDXL, Stable Diffusion 3 hay SD 1.5: nên dùng mô hình nào? →