Stable Diffusion Online
Artificiell intelligens tillgänglig för alla gratis
Skapa AI-bilder gratis, direkt i din webbläsare.
Ange ett prompt. Våra verktyg skapar unika bilder på sekunder. Inget konto, ingen GPU, ingen installation krävs.
Gratis verktyg för bildgenerering online
 Stable Diffusion 3
Text till bild med Stable Diffusion 3, utan konto
 Inpainting Populärt
Måla om valfri del av en bild utifrån en text
 Upscaling Populärt
Förstora en bild upp till 2x med skarpare detaljer
 Stable Diffusion XL demo
Gratis onlinedemo av Stable Diffusion XL 1.0, utan konto
Gratis verktygslåda för artificiell intelligens och LLM:
Konstverk från gemenskapen
 a gecko realist painting as a snow globe scene
 morty smith winning a card game in the 1980s rendered as a pastel drawing further back a foggy lake the scene
 anime style fireworks from a hill
 a snow globe containing a tiny alpine village close up soft light 3d illustration
 a cloud castle botanical illustration on a windy afternoon
 a yellow tram in a narrow lisbon street with blue facades pencil and watercolor travel sketch
 a yeti at a barbecue isometric illustration
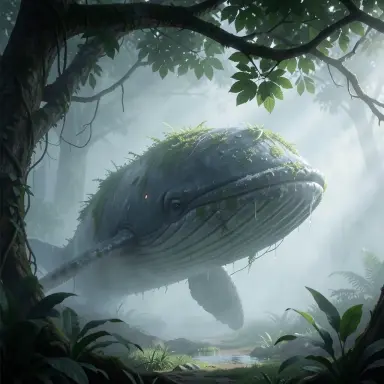 a half built whale made of mist sheltering under a leaf
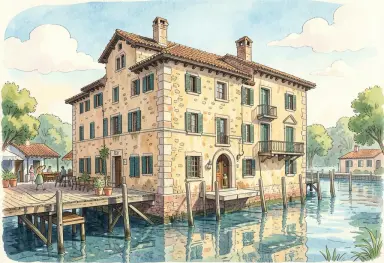 a proven al mas from the pier storybook illustration
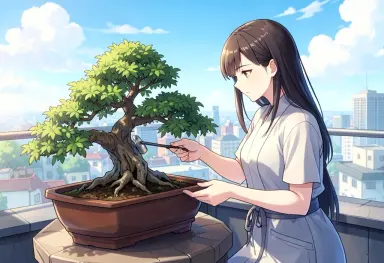 anime style a woman tending bonsai on a rooftop
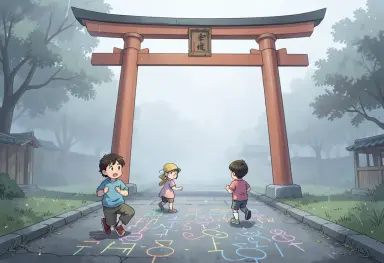 anime style a torii in fog with children chalking the pavement
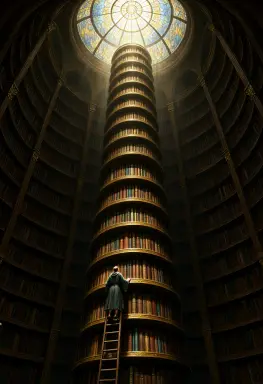 a fantasy concept art of a giant library tower with spiral shelves and a lone scholar on a ladder lit from
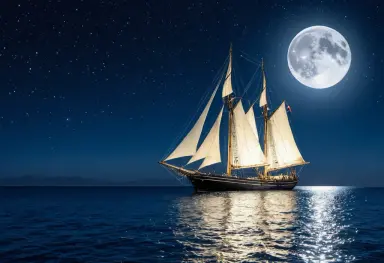 sailing ship on a calm sea under a full moon starry sky silver reflections
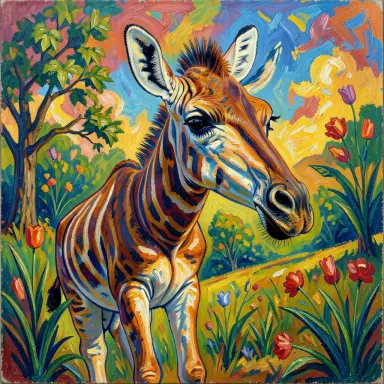 an okapi fauvist painting
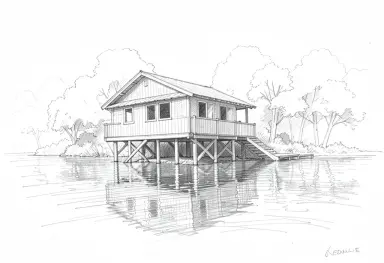 pencil architectural sketch of a wooden cabin on stilts above a lake perspective lines light shading
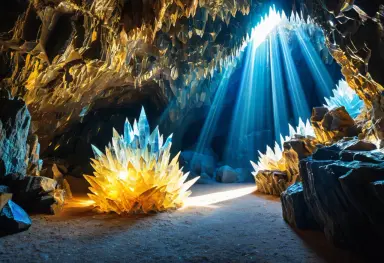 photograph style of a glowing crystal cave with sunlight pouring in blue and gold masterpiece
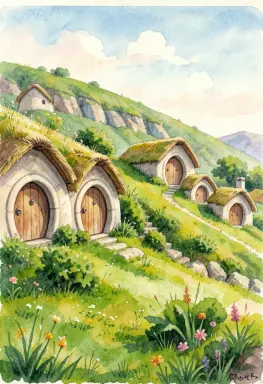 a village of hobbit holes with round doors on a green hillside gouache painting cozy
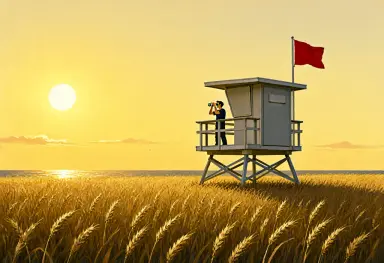 a gouache illustration of a lifeguard tower standing in a wheat field the lifeguard scanning the golden waves
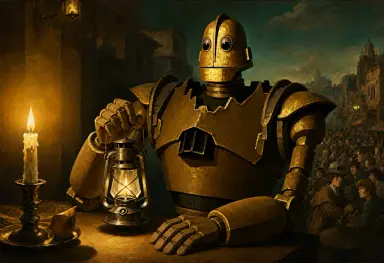 iron giant holding a lantern in the 1980s rendered as a vanitas painting lit by candlelight from the left
 just a viper folk art
 a naive painting of bilbo baggins lit by golden hour light from the front with hard shadows the subject is
 fresco of a jellyfish shaped lamp city built from biscuits
 anime style a vending machine glowing on a country road
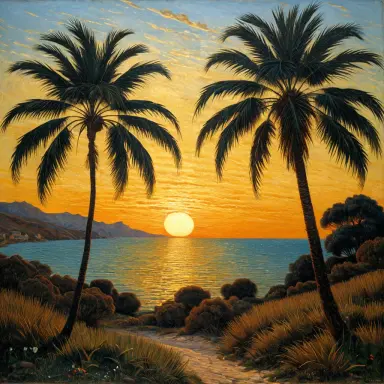 a palm sunset pre raphaelite painting in the style of giovanni segantini
Vad är Stable Diffusion?
Stable Diffusion är en AI som skapar bilder från text. Skriv vad du vill — den skapar bilden.
Utvecklad av StabilityAI , det är öppen källkod. Det körs på ett vanligt GPU — ingen molntjänst behövs. Communityn är mycket aktiv. Många modeller och tillägg är gratis. Du kan till och med träna det på dina egna bilder!
Det tränades på miljontals bilder. Använd det för digital konst, fotoredigering, animationer och mer.
Du kan se exempel i vårt promptgalleri, Konstgalleri och bildbläddrare..Vanliga frågor
Är Stable Diffusion gratis?
Ja. Stable Diffusion är en modell med öppen källkod som är gratis att ladda ner och köra på din egen dator. Alla verktyg på den här webbplatsen är också gratis: onlinedemona, inpainting, uppskalning och promptgeneratorn fungerar utan konto, och text till bild på vår egen GPU kräver bara ett gratis konto. Inga krediter, ingen prenumeration.
Behöver jag ett konto för att generera bilder?
Inget konto behövs för onlinedemona, inpainting, bilduppskalning och promptgeneratorn: öppna sidan och börja. Ett gratis konto, som skapas med en e-postadress, ger tillgång till text till bild på vår egen GPU med Stable Diffusion 1.5 och SDXL 1.0, med full kontroll över steg, CFG-skala, seed och bildstorlek.
Hur använder jag Stable Diffusion online?
Öppna gratisdemon, skriv en beskrivning av bilden du vill ha och klicka på Generate. Bilden visas efter några sekunder och du kan ladda ner den. För ett bättre resultat kan du lägga till detaljer om stil och ljus, skriva ett negativt prompt eller ändra seed för att utforska varianter. Ingenting behöver installeras.
Är det här den officiella webbplatsen för Stable Diffusion?
Nej. Stable Diffusion utvecklas av Stability AI, vars officiella webbplats är stability.ai. stablediffusion.fr är en oberoende webbplats, online sedan 2022, som erbjuder gratis verktyg för att använda Stable Diffusion och andra öppna modeller i webbläsaren, med guider, promptexempel och konstnärsreferenser. Den är inte ansluten till Stability AI.
Vad är en prompt?
En prompt är en textbeskrivning som vägleder AI:n. Den kan innehålla motivet, konstnärlig stil, belysning, stämning och medium — till exempel: 'en medeltida riddare i en mörk skog, oljemålning, dramatisk belysning, filmisk'. Ju mer specifik din prompt, desto närmare resultatet din vision. Håll den under 350 tecken för bästa resultat.
En negativ prompt säger till AI:n vad som inte ska visas i bilden.
Läs hela guiden: Hur skriver man en prompt för Stable Diffusion? →
Vad är en negativ prompt?
En negativ prompt säger till AI:n vad den INTE ska visa. Vanliga exempel: 'blurry, low quality, watermark, text, deformed hands'. Använd dessa för att ta bort typiska AI-misstag.
Negativa prompts förbättrar bildkvaliteten snabbt. Lägg till vikter — som '(blurry:1.4)' — för att göra dem starkare.
Vad betyder seed?
Seedet är ett tal som initierar den slumpmässiga processen bakom bildgenerering. Varje bild börjar från brus, och seedet bestämmer hur det startbruset ser ut. Lämna det på -1 för att få ett slumpmässigt seed — och en annan bild — varje gång.
Fixera seedet för att reproducera exakt samma bild. Det är användbart för experiment: håll seedet konstant medan du bara ändrar prompten eller inställningarna för att exakt jämföra variationer. Det är också hur du återskapar ett favoritresultat senare.
Vad är LoRA?
LoRA står för Low-Rank Adaptation. Det är en liten tilläggsfil (vanligtvis 50–150 MB) som finjusterar en basmodell för en specifik stil, karaktär eller ämne — utan att träna om hela modellen.
Ladda ett LoRA för att generera bilder i en specifik konstnärlig stil, reproducera en viss karaktär eller matcha ett referenskoncept. Du kan kombinera flera LoRAs i ett prompt med vikter: <lora:my-style:0.8>. Tusentals gratis LoRAs finns tillgängliga på Civitai och Hugging Face.
Hur installerar man Stable Diffusion lokalt?
Att köra Stable Diffusion lokalt kräver ett nyare NVIDIA GPU med minst 6 GB VRAM. AMD GPU:er fungerar med ROCm-drivrutiner på Linux. Apple Silicon (M1/M2/M3) stöds också via MPS-backend. Om du inte har ett kompatibelt GPU kör vårt gratis onlineverktyg direkt i din webbläsare — ingen installation behövs.
Ladda ner base model och refiner från Stability AI.Installera sedan Python 3.10 och Git.
Ladda ner webUI från Automatic1111.
Lägg båda modellerna i mappen models/Stable-diffusion .
Hittawebui.bat och dubbelklicka för att installera.
Öppna din webbläsare på localhost:7860.
Läs hela guiden: Hur installerar man Stable Diffusion lokalt? →
Hur mycket VRAM behöver jag för Stable Diffusion?
Du behöver minst 4 GB VRAM för att köra Stable Diffusion. 6 GB är det rekommenderade minimumet för SDXL-modeller. Med 8 GB eller mer kan du generera större bilder och använda fler funktioner.
Utan GPU kan du ändå köra Stable Diffusion på CPU, men det är mycket långsammare. Du kan också använda vår gratis onlinedemo utan GPU.
Vad är img2img?
Img2img låter dig använda en befintlig bild som startpunkt. Du anger en källbild och en prompt. Stable Diffusion omvandlar sedan bilden utifrån dina instruktioner.
Använd det för att ändra stilen på ett foto, förbättra en genererad bild eller förfina en grov skiss. Denoising-styrkan styr hur mycket AI:n ändrar originalet.
Kan jag använda Stable Diffusion-bilder kommersiellt?
Det beror på modellen. Grundmodellerna för Stable Diffusion använder CreativeML Open RAIL-M-licensen. Den tillåter kommersiell användning men med begränsningar — du får inte använda bilder för att skada eller vilseleda människor.
Kontrollera alltid licensen för det checkpoint du använder. Vissa community-modeller begränsar kommersiell användning. Om du säljer eller publicerar AI-genererade bilder, spara en anteckning om modellen och dess licens.
Vad är ControlNet?
ControlNet är ett tillägg för Stable Diffusion som ger dig exakt kontroll över bildkompositionen. Du anger en referensbild — en pose, en kantkarta eller en djupkarta — och AI:n följer den strukturen.
Använd ControlNet för att behålla en persons exakta pose, kopiera en scenlayout eller spåra en skiss exakt. Det fungerar tillsammans med din prompt för att styra både innehåll och struktur.
Vad är ett checkpoint?
Ett checkpoint är en sparad AI-modellfil. Den innehåller allt modellen lärde sig under träningen. Du laddar ett checkpoint för att ange stil och motiv för dina bilder.
Olika checkpoints ger mycket olika resultat. Vissa är tränade för realistiska foton, andra för anime eller illustration. Du kan ladda ner gratis checkpoints från Hugging Face eller Civitai.
Vad är ComfyUI?
ComfyUI är ett gratis, nodbaserat gränssnitt för Stable Diffusion. Du bygger bildarbetsflöden genom att koppla ihop block som kallas noder. Varje nod gör ett steg — ladda en modell, lägga till en prompt eller spara bilden.
ComfyUI ger dig full kontroll över varje steg. Det är snabbare och lättare än Automatic1111. Avancerade användare föredrar det för komplexa arbetsflöden. Du kan dela arbetsflöden som JSON-filer.
Vad är Flux?
Flux är en familj text-till-bild-modeller från Black Forest Labs, grundat av tidigare Stability AI-forskare. Den senaste utgåvan med öppna vikter är FLUX 3 Image Klein, publicerad den 15 oktober 2026: 5,6 miljarder parametrar, nativ 4K-generering, redigering utifrån upp till tio referensbilder och en int8-version som körs på ett grafikkort med 8 GB.
FLUX 3 Image Klein släpps under FLUX Kommunity License: fri kommersiell användning för privatpersoner och företag med under 5 miljoner dollar i årsomsättning; större organisationer behöver en kommersiell licens från Black Forest Labs. FLUX.2, släppt i november 2025, är fortfarande aktuell i fem varianter: tre hostade, [max], [pro] och [flex], och två med öppna vikter, [dev] och [klein]. Den här webbplatsens demo kör FLUX.2 [dev], och sidan med konststilar renderades med FLUX.2 [klein].
Vad är Qwen-Image 2.1?
Qwen-Image 2.1 är en text-till-bild- och bildredigeringsmodell med öppna vikter från Alibabas Qwen-team, släppt i september 2026. Den följer hela meningar i stället för nyckelordslistor, skriver läsbar text i bilden och renderar nativ 2K, 2048 × 2048 för en kvadrat, utan uppskalning. För redigering tar den en mening och upp till tio referensbilder.
Du kan prova den gratis i den här webbplatsens Qwen-Image 2.1-demo, utan konto. Den körs hemma i ComfyUI; int8-vikterna får plats på ett grafikkort med 16 GB. Vikterna ligger under Qwen Research License: enbart forskning och utvärdering, och all kommersiell användning kräver en separat licens från Qwen. Den första Qwen-Image, släppt i augusti 2025, var Apache 2.0.
Läs hela guiden: vad Qwen-Image är, vad den kan och hur den fungerar →
Vad är den senaste versionen av Stable Diffusion?
Den senaste versionen är Stable Diffusion 3.5 , utgiven i oktober 2024. Den producerar skarpare bilder med avsevärt bättre textrendering, rikare färger och förbättrade fina detaljer. Den finns i tre storlekar: Large (8B parametrar), Large Turbo för snabb generering och Medium — alla körbara lokalt med måttlig VRAM.
Läs hela guiden: SDXL vs Stable Diffusion 3 vs SD 1.5: vilken ska du använda? →