Stable Diffusion AI online
Intelligenza Artificiale Accessibile a Tutti gratuitamente
Genera immagini AI gratuitamente, direttamente nel tuo browser.
Inserisci un prompt. I nostri strumenti creano immagini uniche in pochi secondi. Nessun account, GPU o installazione.
Strumenti gratuiti di generazione di immagini online
 Stable Diffusion 3
Text to image with Stable Diffusion 3, no account needed
 Inpainting Popular
Repaint any part of an image from a text prompt
 Upscaling Popular
Enlarge an image up to 2x with sharper details
 Stable Diffusion XL demo
Free Stable Diffusion XL 1.0 online demo, no account needed
Strumenti gratuiti di Intelligenza Artificiale e LLM:
Opere della Comunità
 futuristic tree house hyper realistic epic composition cinematic landscape vista photography by carr clifton galen rowell
 vector logo, vector art, emblem, simple,cartoon, illustration of inspired a Behance medal with adrawing of a full cartoon funny
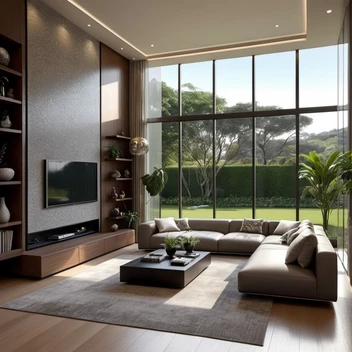 ultra detailed modern interior design, living room, residential design, floor to ceiling windows, and garden landscape
).webp) photoluminescence goniochromism. half shattered sapphire ruby monocrystalline crystal, by louis wain, (((rembrandt painting))
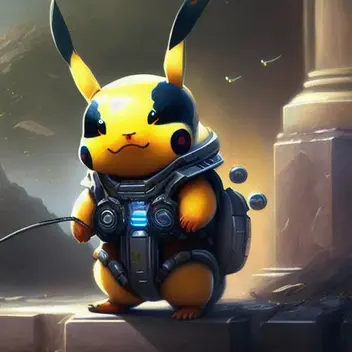 Detailed oil painting William Adolphe Beaugereau starcraft 2 pikacu
 eagle bracelet made of buckskin with eagle features, rich details, fine carvings, studio lighting
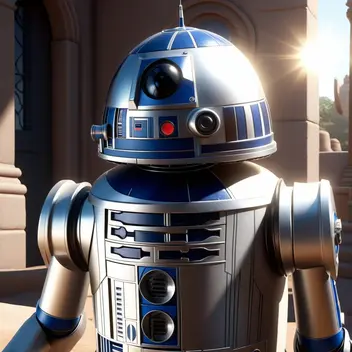 homme nuvo r3d2 d4k3 hyperrealistic cgi photorealistic cinematic volume lighting fanart on artstation full sun shine day concept
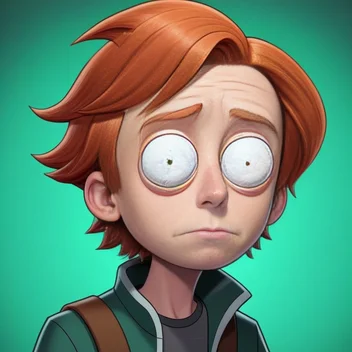 ron weasley in the style of rick and morty
 vector traditional illustration of a create a school on front road and bike cycle, toon smart happy girl student with happy face
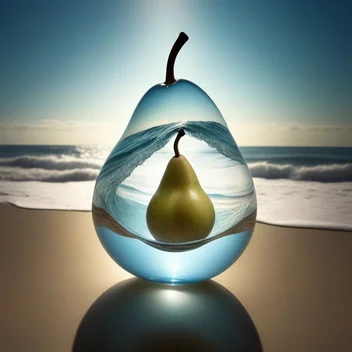 beautiful double exposure image by mixing a rough sea and a glass pear. the sea should serve as the underlying backdrop
 Architecture modern building 8 stories
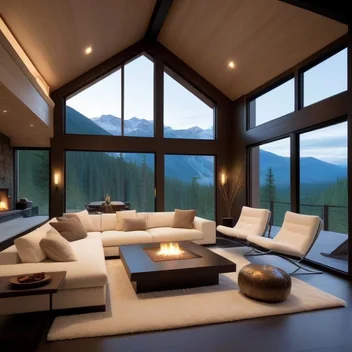 a modern and inviting living room within a cabin, boasting a double height ceiling and a floor to ceiling window on one side
 illustration letter v with flowers covered in colorful microscopy beads, beaded pointillism style, pixel art. image is white background
 3d printed house with an innovative spherical design against a night background, fine details, 4k reso
 iyoung children with clown makeup and white hair, dark fantasy digital art, inspired by cornelis bisschop
 a living roomscandinavian interior style
 captain america mixed with green lantern, intricate, elegant, highly detailed, cell shaded, digital painting, artstation
 cartoon character of a person with a hoodie , in style of cytus and deemo, ork, gold chains, realistic anime cat, dripping black
 Create an engaging website banner image featuring a futuristic car at its center. This car should embody the cutting edge features
 isometric clean pixel art image cutaway of inside of japanese bath house,
 hamburger,
 modern 4 story construction, with low homes, main street.,
 create a culinary narrative or description of a dish using the following five words fragrant, juicy, exquisite, effervescent, r
 photorealistic ink art showing silouhette of beautiful and mysterious woman into psychedelic desert with charred shrubs, far bac
Cos'è Stable Diffusion?
Stable Diffusion è un'IA che crea immagini da testo. Scrivi quello che vuoi — lei genera l'immagine.
Sviluppato da StabilityAI , è open source. Funziona su una GPU standard — senza cloud. La community è molto attiva. Molti modelli e add-on sono gratuiti. Puoi persino allenarla con le tue immagini!
È stata addestrata su milioni di immagini. Usala per arte digitale, fotoritocco, animazioni e altro.
Puoi vedere esempi nella nostra galleria di prompt, Galleria d'Arte e browser di immagini..Domande Frequenti
Stable Diffusion è gratuito?
Sì. Stable Diffusion è un modello open source, gratuito da scaricare e da eseguire sul proprio computer. Anche tutti gli strumenti di questo sito sono gratuiti: le demo online, l’inpainting, l’upscaling e il generatore di prompt funzionano senza account, e il testo in immagine sulla nostra GPU richiede solo un account gratuito. Nessun credito, nessun abbonamento.
Serve un account per generare immagini?
Non serve alcun account per le demo online, l’inpainting, l’upscaling delle immagini e il generatore di prompt: apri la pagina e inizia. Un account gratuito, creato con un indirizzo e-mail, sblocca il testo in immagine sulla nostra GPU con Stable Diffusion 1.5 e SDXL 1.0, con il pieno controllo di step, scala CFG, seed e dimensioni dell’immagine.
Come si usa Stable Diffusion online?
Apri la demo gratuita, scrivi una descrizione dell’immagine che desideri e fai clic su Generate. L’immagine appare dopo pochi secondi e puoi scaricarla. Per migliorare il risultato, aggiungi dettagli su stile e illuminazione, scrivi un prompt negativo o cambia il seed per esplorare le varianti. Non c’è nulla da installare.
È questo il sito ufficiale di Stable Diffusion?
No. Stable Diffusion è sviluppato da Stability AI, il cui sito ufficiale è stability.ai. stablediffusion.fr è un sito indipendente, online dal 2022, che offre strumenti gratuiti per usare Stable Diffusion e altri modelli aperti nel browser, con guide, esempi di prompt e riferimenti di artisti. Non è affiliato a Stability AI.
Cos'è un prompt?
Un prompt è una descrizione testuale che guida l'IA. Può includere il soggetto, lo stile artistico, l'illuminazione, l'umore e il mezzo — ad esempio: 'un cavaliere medievale in una foresta oscura, pittura a olio, illuminazione drammatica, cinematografico'. Più specifico è il prompt, più il risultato si avvicina alla tua visione. Mantienilo sotto i 350 caratteri per i migliori risultati.
Un prompt negativo dice all'IA cosa escludere dall'immagine.
Cos'è un prompt negativo?
Un prompt negativo dice all'IA cosa NON mostrare. Esempi comuni: 'blurry, low quality, watermark, text, deformed hands'. Usali per eliminare i tipici errori dell'IA.
I prompt negativi migliorano la qualità rapidamente. Aggiungi pesi — come '(blurry:1.4)' — per renderli più forti.
Cosa significa seed?
Il seed è un numero che inizializza il processo casuale dietro la generazione delle immagini. Ogni immagine parte dal rumore, e il seed determina come appare quel rumore iniziale. Lascialo a -1 per ottenere un seed casuale — e un'immagine diversa — ogni volta.
Fissa il seed per riprodurre esattamente la stessa immagine. È utile per sperimentare: mantieni il seed costante cambiando solo il prompt o le impostazioni per confrontare le variazioni con precisione. È anche il modo per ricreare un risultato preferito in seguito.
Cos'è LoRA?
LoRA sta per Low-Rank Adaptation. È un piccolo file aggiuntivo (tipicamente 50–150 MB) che affina un modello base per uno stile, personaggio o soggetto specifico — senza riaddestrare l'intero modello.
Carica un LoRA per generare immagini in uno stile artistico specifico, riprodurre un personaggio particolare o abbinare un concetto di riferimento. Puoi combinare diversi LoRA in un prompt usando i pesi: <lora:my-style:0.8>. Migliaia di LoRA gratuiti sono disponibili su Civitai e Hugging Face.
Come installare Stable Diffusion localmente?
Eseguire Stable Diffusion localmente richiede una GPU NVIDIA recente con almeno 6 GB di VRAM. Le GPU AMD funzionano con i driver ROCm su Linux. Apple Silicon (M1/M2/M3) è supportato anche tramite il backend MPS. Se non hai una GPU compatibile, il nostro strumento online gratuito funziona direttamente nel tuo browser — nessuna installazione necessaria.
Prima, scarica il base model e il refiner da Stability AI.Poi, installa Python 3.10 e Git.
Scarica il webUI da Automatic1111.
Metti entrambi i modelli nella cartella models/Stable-diffusion .
Trovawebui.bat e fai doppio clic per installare.
Apri il browser su localhost:7860.
Quanta VRAM serve per Stable Diffusion?
Servono almeno 4 GB di VRAM per eseguire Stable Diffusion. 6 GB è il minimo consigliato per i modelli SDXL. Con 8 GB o più puoi generare immagini più grandi e usare più funzionalità.
Senza GPU puoi comunque usare Stable Diffusion su CPU, ma è molto più lento. Puoi anche usare la nostra demo online gratuita senza GPU.
Cos'è img2img?
Img2img ti permette di usare un'immagine esistente come punto di partenza. Fornisci un'immagine sorgente e un prompt. Stable Diffusion trasforma poi l'immagine in base alle tue istruzioni.
Usalo per cambiare lo stile di una foto, correggere un'immagine generata o affinare un bozzetto grezzo. La forza di denoising controlla quanto l'AI modifica l'originale.
Posso usare le immagini di Stable Diffusion commercialmente?
Dipende dal modello. I modelli base di Stable Diffusion usano la licenza CreativeML Open RAIL-M. Questa consente l'uso commerciale, ma con alcune restrizioni — non puoi usare le immagini per danneggiare o ingannare persone.
Verifica sempre la licenza del checkpoint che usi. Alcuni modelli della community limitano l'uso commerciale. Se vendi o pubblichi immagini AI, tieni traccia del modello e della sua licenza.
Cos'è ControlNet?
ControlNet è un'estensione per Stable Diffusion che ti dà un controllo preciso sulla composizione dell'immagine. Fornisci un'immagine di riferimento — una posa, una mappa dei bordi o una mappa della profondità — e l'AI segue quella struttura.
Usa ControlNet per mantenere la posa esatta di una persona, copiare un layout di scena o tracciare un bozzetto con precisione. Funziona insieme al tuo prompt per controllare sia il contenuto che la struttura.
Cos'è un checkpoint?
Un checkpoint è un file di modello AI salvato. Contiene tutto ciò che il modello ha imparato durante l'addestramento. Carichi un checkpoint per impostare lo stile e il soggetto delle tue immagini.
Checkpoint diversi danno risultati molto diversi. Alcuni sono addestrati per foto realistiche, altri per anime o illustrazione. Puoi scaricare checkpoint gratuiti da Hugging Face o Civitai.
Cos'è ComfyUI?
ComfyUI è un'interfaccia gratuita basata su nodi per Stable Diffusion. Crei workflow collegando blocchi chiamati nodi. Ogni nodo fa un passo — caricare un modello, aggiungere un prompt o salvare l'immagine.
ComfyUI ti dà il pieno controllo su ogni passo. È più veloce e leggero di Automatic1111. Gli utenti avanzati lo preferiscono per workflow complessi. Puoi condividere i workflow come file JSON.
Cos'è Flux?
Flux è un modello AI testo-immagine di Black Forest Labs, fondato da ex ricercatori di Stability AI. L'ultima versione è FLUX.2, rilasciata a novembre 2025. Produce immagini fino a 4MP con output fotorealistico e controllo multi-riferimento.
FLUX.2 ha quattro varianti: Max (qualità massima), Pro (qualità a piena velocità), Flex (precisione e testo nitido) e Dev (pesi aperti, distribuzione libera). FLUX.2 Dev può girare localmente in ComfyUI o Automatic1111 — gli stessi strumenti di Stable Diffusion.
Qual è la versione più recente di Stable Diffusion?
L'ultima versione è Stable Diffusion 3.5 , rilasciato nell'ottobre 2024. Produce immagini più nitide con un rendering del testo significativamente migliore, colori più ricchi e dettagli fini migliorati. È disponibile in tre dimensioni: Large (8 miliardi di parametri), Large Turbo per la generazione rapida e Medium — tutti eseguibili localmente con VRAM moderata.